Si alguna vez te ha tocado hacer guardia en infraestructura de producción, conoces perfectamente esa sensación incómoda de caos cuando se produce una caída masiva. En la monitorización se encienden decenas de avisos en rojo, el busca no deja de sonar y el chat del equipo se convierte en un hervidero: «¿Quién ha cogido la base de datos?», «¿Miro yo la red o la miras tú?», «¿Por qué lleva esta alerta media hora colgada?».
La interfaz web oficial de Prometheus Alertmanager nació como una herramienta minimalista para revisar reglas básicas y crear silencios. Alternativas populares como el panel Karma mejoraron bastante la parte visual, pero no resolvieron el problema de fondo: sigue siendo una pecera estática con una foto del estado actual. En cuanto una alerta desaparece por un microcorte de red, se pierde todo el hilo de lo que estaba pasando.
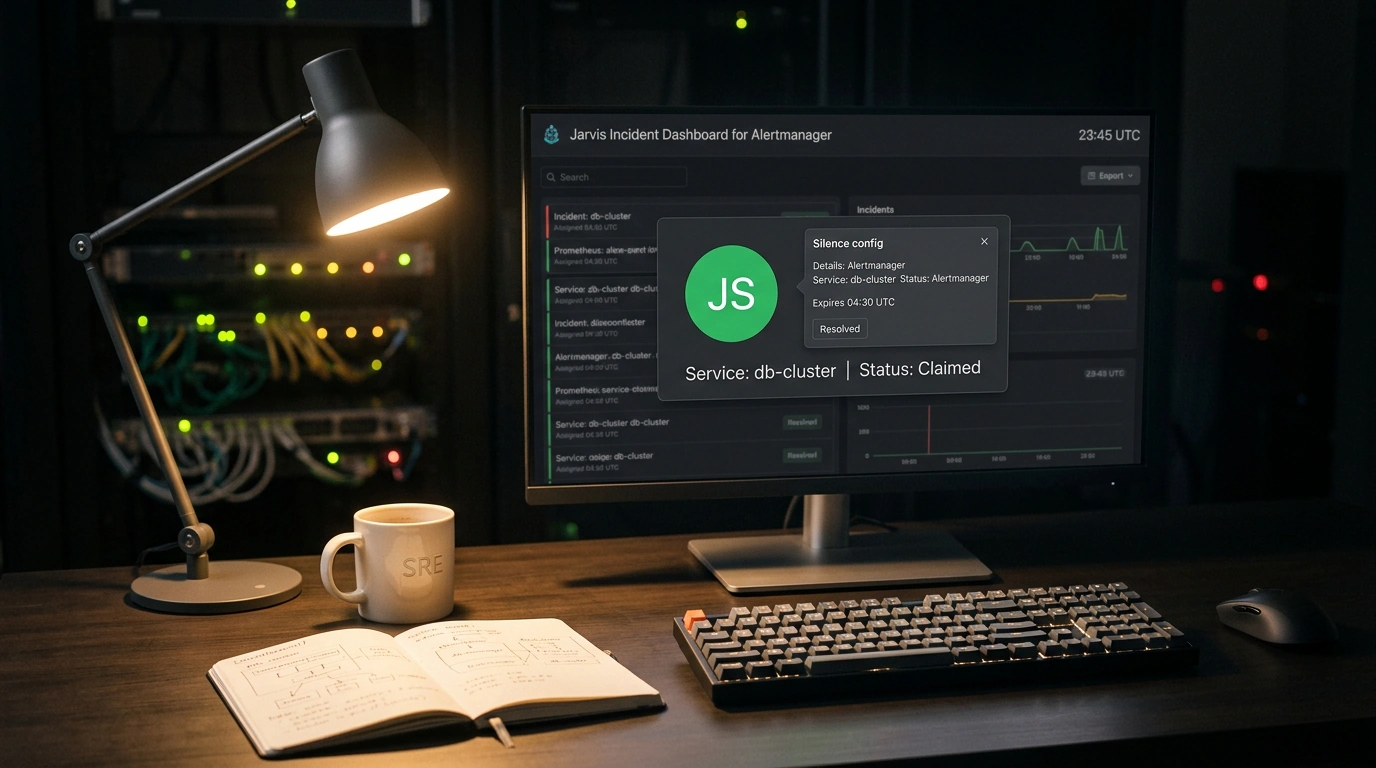
El ingeniero alemán Kevin Jahns ha desarrollado Jarvis, una aplicación open-source y self-hosted escrita en Go y pnpm que convierte Alertmanager de un simple tablón pasivo en una consola interactiva de respuesta ante incidentes.
Asignación de responsables e historial persistente
El gran acierto arquitectónico de Jarvis es contar con su propio almacenamiento ligero. Por defecto utiliza una base de datos local SQLite (y para clústeres de alta disponibilidad con varias réplicas puede conectarse a PostgreSQL).
¿Qué gana el equipo de guardia en el día a día? En primer lugar, asignación de responsable (claiming) en un clic. Pulsas un botón en la tarjeta del incidente y todo el equipo ve tu avatar al instante: ese problema ya tiene dueño, no hace falta duplicar esfuerzos. En segundo lugar, notas y comentarios persistentes. Cada apunte se vincula no a un ID temporal del evento, sino a la huella criptográfica estable de la alerta (fingerprint). Si la base de datos intermitente falla una vez por semana, quien esté de guardia verá enseguida el historial de análisis anteriores y las instrucciones listas dentro de la propia tarjeta. En tercer lugar, el mecanismo de Grace Period. Si hay un corte breve de red entre Jarvis y el servidor upstream, las alertas no desaparecen de la pantalla al instante, evitando la falsa ilusión de que el incidente se ha resuelto solo.
Silencios seguros: protección contra errores humanos
Otro quebradero de cabeza clásico para cualquier SRE es crear reglas de silencio (silences). Basta con equivocarse en una expresión regular o poner un matcher demasiado amplio (por ejemplo, env=~"prod.*") para silenciar la mitad de los servicios críticos de la empresa y dejar pasar una caída real.
Jarvis integra un Silence Preview interactivo. Mientras escribes las condiciones de filtrado, la interfaz consulta en tiempo real el conjunto actual de alertas y resalta la lista exacta de notificaciones que quedarán silenciadas. Ves el impacto real antes de pulsar el botón de confirmar.
Jarvis está diseñado para desplegarse de forma segura en la red interna. La imagen del contenedor arranca por defecto con un usuario sin privilegios, en modo read_only: true y eliminando todas las capacidades del kernel (cap_drop: ALL). Eso sí, la aplicación no incluye un sistema propio de registro público: conviene protegerla detrás de una VPN corporativa o un proxy inverso con autenticación OIDC/SSO.
Despliegue en Docker o Podman
Jarvis se distribuye como una única imagen OCI compacta y se conecta a Alertmanager mediante la API HTTP v2 estándar. Aquí tienes un manifiesto compose.yaml listo para usar que combina los entornos de producción y staging:
services:
  jarvis:
    image: ghcr.io/kj187/jarvis:2.1.0
    container_name: jarvis
    ports:
      - "8080:8080"
    volumes:
      - jarvis_data:/data
    read_only: true
    tmpfs:
      - /tmp
    security_opt:
      - no-new-privileges:true
    cap_drop:
      - ALL
    environment:
      # Conexión del primer clúster de Alertmanager (Producción)
      JARVIS_CLUSTER_1_NAME: "production"
      JARVIS_CLUSTER_1_ALERTMANAGER_URL: "http://alertmanager-prod.internal:9093"
      JARVIS_CLUSTER_1_AUTH_TYPE: "bearer"
      JARVIS_CLUSTER_1_AUTH_TOKEN: "${ALERTMANAGER_TOKEN}"

      # Conexión del segundo clúster de Alertmanager (Staging)
      JARVIS_CLUSTER_2_NAME: "staging"
      JARVIS_CLUSTER_2_ALERTMANAGER_URL: "http://alertmanager-stage.internal:9093"

      # Ajustes de la base de datos local e intervalos
      JARVIS_STORAGE_TYPE: "sqlite"
      JARVIS_STORAGE_SQLITE_PATH: "/data/jarvis.db"
      JARVIS_POLL_INTERVAL: "15s"
      JARVIS_GRACE_PERIOD: "45s"
    restart: unless-stopped

volumes:
  jarvis_data:
    driver: local
Tras arrancar el contenedor, comprueba que la configuración se haya leído bien y que el endpoint de salud responda:
# Arranque del servicio en segundo plano
podman compose up -d

# Revisión del registro de arranque y conexión con los clústeres
podman logs -f jarvis

# Verificación de disponibilidad de la interfaz web
curl -fsS http://localhost:8080/healthz || echo "Инициализация сервиса..."
Para equipos de infraestructura pequeños y medianos, Jarvis encaja como un punto intermedio ideal: tapa los huecos del Alertmanager estándar sin obligarte a montar pesadas plataformas comerciales de gestión de incidentes.