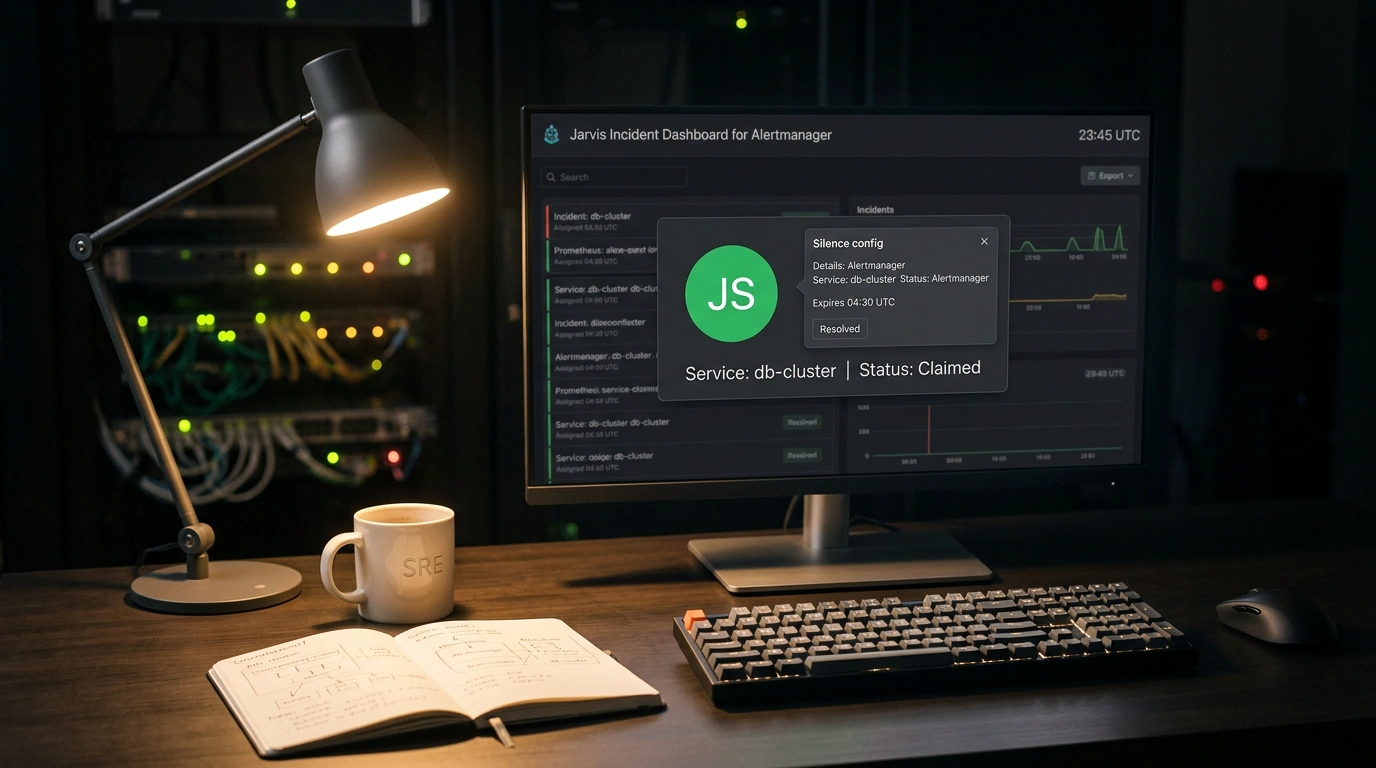

Если тебе хоть раз доводилось дежурить на боевой инфраструктуре, ты отлично знаешь это липкое чувство растерянности при массовом сбое. В мониторинге вспыхивают десятки красных плашек, пейджер разрывается, а в командном чате начинается суматоха: «Кто взял базу?», «Я смотрю сеть или ты?», «Почему этот алерт висит уже полчаса?».
Штатный веб-интерфейс Prometheus Alertmanager задумывался как сугубо минималистичный инструмент для базовой проверки правил и создания заглушек. Популярная альтернатива в лице дашборда Karma заметно улучшила визуализацию, но принципиально проблему не решила: это по-прежнему статичный «аквариум» со снимком текущего состояния. Стоит алерту исчезнуть из-за кратковременного сетевого лага, как теряется вся цепочка контекста.
Немецкий инженер Кевин Янс (Kevin Jahns) разработал проект Jarvis — открытое self-hosted приложение на Go и pnpm, которое превращает Alertmanager из пассивного табло в интерактивный пульт оперативного реагирования.
Назначение ответственных и постоянная история
Главная архитектурная находка Jarvis — наличие собственного легковесного хранилища. По умолчанию сервис использует локальную базу данных SQLite (а для отказоустойчивых кластеров из нескольких реплик умеет подключаться к PostgreSQL).
Что это даёт дежурной смене на практике? Во-первых, назначение ответственного (claiming) в один клик. Ты нажимаешь кнопку на карточке инцидента, и вся команда сразу видит твою аватарку: ресурс взят в работу, дублировать усилия не нужно. Во-вторых, сохранение заметок и комментариев. Все записи привязываются не к временному ID события, а к стабильному криптографическому отпечатку алерта (fingerprint). Если база данных флапает раз в неделю, дежурный инженер сразу увидит историю прошлых разборов и готовые инструкции прямо в карточке. В-третьих, механизм Grace Period. При кратковременном сетевом сбое между Jarvis и upstream-сервером оповещения не исчезают с экрана мгновенно, предотвращая ложные иллюзии успешного разрешения проблемы.
Безопасные заглушки: защита от человеческой ошибки
Отдельная головная боль любого SRE — создание правил тишины (silences). Достаточно ошибиться в регулярном выражении или случайно указать слишком широкий лейбл матчера (например, env=~"prod.*"), как ты заглушишь половину критических сервисов компании и пропустишь настоящую аварию.
В Jarvis встроен интерактивный Silence Preview. Когда ты набираешь условия фильтрации, интерфейс на лету обращается к текущему пулу алертов и подсвечивает точный список уведомлений, которые попадут под действие заглушки. Ты видишь результат до нажатия кнопки подтверждения.
Jarvis спроектирован для безопасного развёртывания во внутреннем контуре. Образ контейнера изначально запускается от непривилегированного пользователя в режиме read_only: true со сбросом всех привилегий ядра (cap_drop: ALL). Однако в самом приложении нет встроенной системы публичной регистрации: его следует закрывать за корпоративным VPN или обратным прокси с OIDC/SSO авторизацией.
Развёртывание в Docker или Podman
Jarvis распространяется в виде единого компактного OCI-образа и подключается к Alertmanager через стандартный HTTP API v2. Вот готовый манифест compose.yaml, объединяющий production- и staging-контуры:
services:
  jarvis:
    image: ghcr.io/kj187/jarvis:2.1.0
    container_name: jarvis
    ports:
      - "8080:8080"
    volumes:
      - jarvis_data:/data
    read_only: true
    tmpfs:
      - /tmp
    security_opt:
      - no-new-privileges:true
    cap_drop:
      - ALL
    environment:
      # Подключение первого кластера Alertmanager (Production)
      JARVIS_CLUSTER_1_NAME: "production"
      JARVIS_CLUSTER_1_ALERTMANAGER_URL: "http://alertmanager-prod.internal:9093"
      JARVIS_CLUSTER_1_AUTH_TYPE: "bearer"
      JARVIS_CLUSTER_1_AUTH_TOKEN: "${ALERTMANAGER_TOKEN}"

      # Подключение второго кластера Alertmanager (Staging)
      JARVIS_CLUSTER_2_NAME: "staging"
      JARVIS_CLUSTER_2_ALERTMANAGER_URL: "http://alertmanager-stage.internal:9093"

      # Настройки локальной базы и интервалов
      JARVIS_STORAGE_TYPE: "sqlite"
      JARVIS_STORAGE_SQLITE_PATH: "/data/jarvis.db"
      JARVIS_POLL_INTERVAL: "15s"
      JARVIS_GRACE_PERIOD: "45s"
    restart: unless-stopped

volumes:
  jarvis_data:
    driver: local
После запуска контейнера проверь чтение конфигурации и статус готовности эндпоинта проверки работоспособности:
# Фоновый запуск сервиса
podman compose up -d

# Проверка журнала инициализации и подключения к кластерам
podman logs -f jarvis

# Валидация доступности веб-интерфейса
curl -fsS http://localhost:8080/healthz || echo "Инициализация сервиса..."
Для небольших и средних инфраструктурных команд Jarvis выглядит идеальным промежуточным звеном: он закрывает дыры стандартного Alertmanager, не требуя разворачивать тяжеловесные коммерческие платформы эскалации инцидентов.