

Картина маслом: три часа ночи, дежурный мониторинг взрывается авариями. СУБД экстренно падает в аварийный read-only, веб-сервер сыплет ошибками No space left on device (ENOSPC). Ты подключаешься по SSH, запускаешь df -h и видишь: корневой раздел забит ровно на 100%.
Казалось бы, решение очевидно: найти самый толстый лог-файл в /var/log/ и снести его через rm -f. Ты радостно удаляешь сорокагигабайтный файл, снова вводишь df -h... и замираешь в ступоре. Занятое пространство не уменьшилось ни на один килобайт. Ты запускаешь du -xsh /, и утилита рапортует, что видимые файлы занимают всего 50 ГБ из 100 доступных. Куда делись остальные 50 гигабайт?
Мы уже подробно разбирали архитектуру ядра и файловых систем в материале Большой справочник по Linux и Bash: от архитектуры ядра до отладки. Давай разберём физику этого инцидента на уровне системных вызовов VFS.
Физика файловых дескрипторов: почему rm не освобождает блоки
В операционных системах Linux файл физически состоит из двух частей:
- Запись в каталоге (имя файла и ссылка на номер inode).
- Сам индексный дескриптор inode и связанные с ним блоки данных на накопителе.
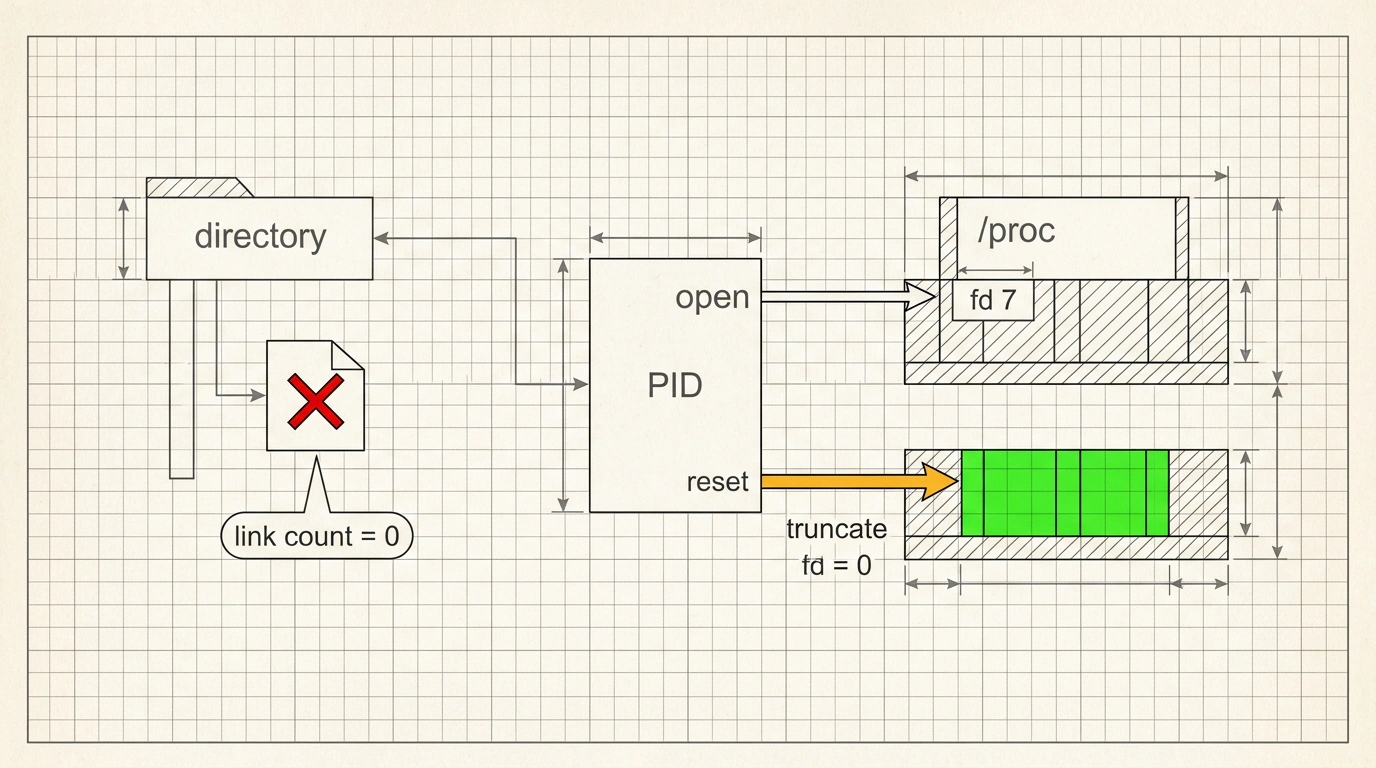
Команда rm — это всего лишь системный вызов unlink(). Она стирает запись об имени файла из директории и уменьшает счётчик жестких ссылок (nlink). Однако ядро освобождает фактические блоки на диске только тогда, когда выполнены два условия:
- счётчик ссылок
nlinkравен нулю; - все процессы закрыли открытый файловый дескриптор этого файла.
Если твой сервис (Java, Nginx, PostgreSQL или ClickHouse) в момент удаления продолжал писать в лог, дескриптор остаётся открытым. Файл превращается в невидимого «призрака» (unlinked deleted file). Утилита du обходит дерево каталогов и просто не видит этот файл. А утилита df опрашивает суперблок файловой системы (statvfs), который честно учитывает все занятые блоки. Хуже того: процесс продолжает писать в открытый дескриптор, и диск заполняется дальше!
Поиск виновника и спасение сервера без перезагрузки
Самый грубый способ — перезагрузить сервер или перезапустить упавший сервис. Но если это мастер-узел распределённой базы данных или центральный балансировщик, перезагрузка вызовет недопустимый простой бизнеса.
Мы пойдём чисто инженерным путём через аудит открытых дескрипторов утилитой lsof:
# 1. Проверяем процент занятого дискового пространства
df -h /

# 2. Ищем процессы, удерживающие удаленные файлы (+L1 = Link count < 1)
sudo lsof -nP +L1 / | grep -i deleted

# Пример вывода:
# COMMAND   PID USER   FD   TYPE DEVICE        SIZE/OFF   NODE NAME
# java     1420 root    7w   REG  253,0  42949672960 134212 /var/log/app.log (deleted)
Из вывода мы видим: процесс с идентификатором PID 1420 удерживает файл через дескриптор номер 7.
Теперь самое интересное. Виртуальная файловая система ядра Linux экспортирует все дескрипторы работающих процессов в псевдокаталог /proc/<PID>/fd/. Мы можем сбросить размер удерживаемого файла в ноль прямо на лету, не останавливая приложение:
# Обнуляем размер файла через системный дескриптор в /proc
sudo truncate -s 0 /proc/1420/fd/7

# Альтернативный вариант через перенаправление пустого потока шелла:
# sudo sh -c ": > /proc/1420/fd/7"

# Проверяем мгновенное освобождение блоков:
df -h /
# Результат: занятое место сразу падает с 100% до безопасных 55%!
А если закончились не гигабайты, а inode?
Бывает обратная ситуация: df -h показывает 30 ГБ свободного места, но любая попытка создать файл возвращает ту же ошибку No space left on device. В этом случае проверь исчерпание индексных дескрипторов:
# Проверка пула индексных дескрипторов
df -i /

# Если IUse% = 100%, ищем каталоги с миллионами крошечных файлов (кеш, сессии):
sudo find / -xdev -type d -size +1M 2>/dev/null
Чтобы логи не переполняли диск, настраивают системный демон logrotate. Многие по привычке ставят директиву copytruncate. Помни: она работает в два этапа — сначала копирует файл целиком, а затем обнуляет исходный. На высоконагруженных системах строки логов, записанные приложением между окончанием копирования и вызовом очистки, безвозвратно теряются! Для критичных сервисов безопаснее использовать метод переоткрытия дескрипторов по сигналу: блок postrotate с вызовом systemctl reload <service>.
Запомни эту связку lsof -nP +L1 и truncate /proc/<PID>/fd/<FD>: в критический момент она спасёт тебя от ночной паники и сохранит непрерывность работы продакшена.