La escena clásica de terror: son las tres de la madrugada y la monitorización de guardia estalla en alertas. La base de datos pasa de golpe a modo read-only de emergencia y el servidor web escupe errores No space left on device (ENOSPC). Te conectas por SSH, ejecutas df -h y lo ves claro: la partición raíz está clavada al 100 %.
Parece evidente qué hacer: localizar el log más gordo en /var/log/ y borrarlo con rm -f. Eliminas felizmente un archivo de 40 GB, vuelves a lanzar df -h... y te quedas helado. El espacio ocupado no ha bajado ni un kilobyte. Ejecutas du -xsh / y la utilidad asegura que los archivos visibles ocupan apenas 50 GB de los 100 disponibles. ¿Dónde están los otros 50 gigas?
Ya vimos a fondo la arquitectura del kernel y los sistemas de archivos en la Gran guía de Linux y Bash: de la arquitectura del kernel a la depuración. Vamos a analizar la física de este incidente bajando al nivel de las llamadas al sistema de VFS.
La física de los descriptores de archivo: por qué rm no libera bloques
En Linux, un archivo consta físicamente de dos partes:
- Una entrada en el directorio (el nombre del archivo y el puntero al número de inodo).
- El propio descriptor de índice (inode) y los bloques de datos asociados en el disco.
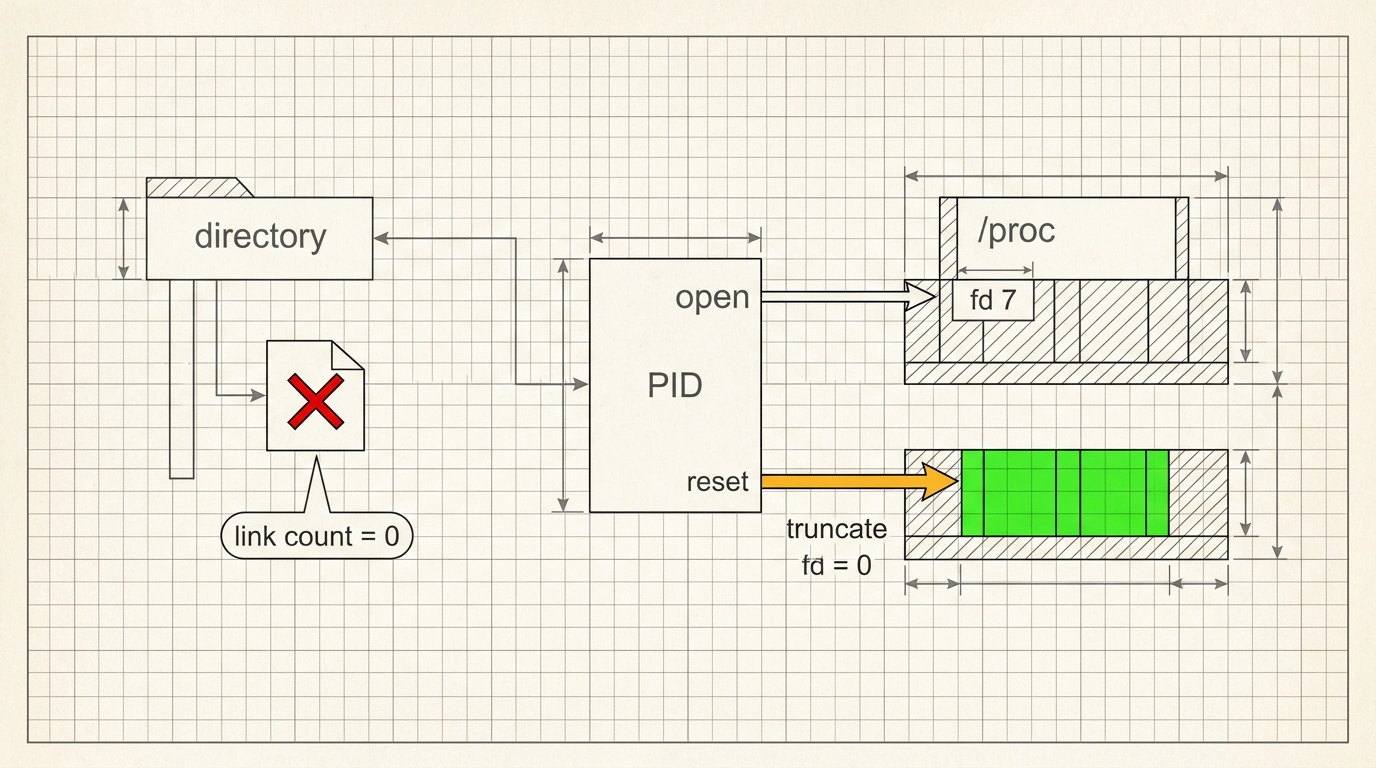
El comando rm no es más que la llamada al sistema unlink(). Borra la entrada del nombre en el directorio y reduce el contador de enlaces duros (nlink). Sin embargo, el kernel solo libera los bloques reales en disco cuando se cumplen dos condiciones:
- el contador de enlaces
nlinkllega a cero; - todos los procesos han cerrado el descriptor de archivo abierto de ese archivo.
Si tu servicio (Java, Nginx, PostgreSQL o ClickHouse) seguía escribiendo en el log cuando lo borraste, el descriptor continúa abierto. El archivo se convierte en un «fantasma» invisible (unlinked deleted file). du recorre el árbol de directorios y ni lo ve. En cambio, df consulta el superbloque del sistema de archivos (statvfs), que cuenta con total honestidad todos los bloques ocupados. Y lo peor: el proceso sigue escribiendo en ese descriptor abierto y el disco se llena todavía más.
Encontrar al culpable y rescatar el servidor sin reiniciar
La salida bruta sería reiniciar el servidor o el servicio caído. Pero si hablamos del nodo maestro de una base de datos distribuida o del balanceador central, un reinicio supone una caída inaceptable para el negocio.
Vamos por la vía limpia de ingeniería auditando los descriptores abiertos con lsof:
# 1. Comprobamos el porcentaje de espacio en disco ocupado
df -h /

# 2. Buscamos procesos que retienen archivos borrados (+L1 = Link count < 1)
sudo lsof -nP +L1 / | grep -i deleted

# Ejemplo de salida:
# COMMAND   PID USER   FD   TYPE DEVICE        SIZE/OFF   NODE NAME
# java     1420 root    7w   REG  253,0  42949672960 134212 /var/log/app.log (deleted)
En la salida vemos enseguida que el proceso con PID 1420 retiene el archivo a través del descriptor número 7.
Ahora viene lo mejor. El sistema de archivos virtual del kernel Linux expone todos los descriptores de los procesos activos en el pseudodirectorio /proc/<PID>/fd/. Podemos poner a cero el tamaño del archivo retenido al vuelo, sin detener la aplicación:
# Truncamos a cero el tamaño del archivo mediante el descriptor del sistema en /proc
sudo truncate -s 0 /proc/1420/fd/7

# Alternativa redirigiendo un flujo vacío desde la shell:
# sudo sh -c ": > /proc/1420/fd/7"

# Comprobamos la liberación inmediata de bloques:
df -h /
# Resultado: el espacio ocupado cae al instante del 100 % a un cómodo 55 %.
¿Y si no se acabaron los gigas, sino los inodos?
A veces pasa justo al revés: df -h muestra 30 GB libres, pero cualquier intento de crear un archivo devuelve el mismo error No space left on device. En ese caso, revisa si se han agotado los inodos:
# Comprobación del pool de descriptores de índice (inodos)
df -i /

# Si IUse% = 100%, buscamos directorios con millones de archivos diminutos (caché, sesiones):
sudo find / -xdev -type d -size +1M 2>/dev/null
Para evitar que los logs llenen el disco se suele configurar el demonio logrotate. Muchos ponen por costumbre la directiva copytruncate. Ten en cuenta que trabaja en dos pasos: primero copia el archivo entero y después vacía el original. En sistemas con mucha carga, las líneas escritas por la aplicación entre el fin de la copia y el vaciado se pierden para siempre. En servicios críticos es mucho más seguro reabrir los descriptores por señal: un bloque postrotate que ejecute systemctl reload <service>.
Quédate con esta pareja de comandos, lsof -nP +L1 y truncate /proc/<PID>/fd/<FD>: en un momento crítico te ahorran el pánico nocturno y mantienen producción en marcha sin cortes.