Si llevas al menos un par de años configurando publicidad en buscadores, seguro que has notado lo rápido que está cambiando el paisaje de Yandex Direct. Las pujas manuales, el control milimétrico de palabras clave con operadores de concordancia exacta y la limpieza artesanal de palabras negativas están pasando a la historia. Yandex empuja a los anunciantes de forma constante y firme hacia los brazos de las estrategias automáticas y la segmentación automática (autotargeting) obligatoria. El discurso oficial de la plataforma suena inspirador: las redes neuronales se han vuelto más listas, los algoritmos ven miles de millones de señales de comportamiento y la inteligencia artificial es capaz de encontrar al cliente solvente mejor que cualquier especialista humano.
Pero cuando un empresario o un marketer abre la cuenta publicitaria tras recargar el saldo con cientos de miles de rublos, el cuento de hadas de la IA todopoderosa choca de frente con la cruda realidad. En los informes lucen decenas de leads baratos, el coste por conversión encaja en el objetivo y la gráfica de clics sube alegremente... mientras el departamento de ventas literalmente aúlla de rabia. Los comerciales descuelgan el teléfono y escuchan: «Uy, yo solo llamaba para preguntar una cosilla», «¿Me arreglan una nevera vieja por quinientos rublos?» o «¿Seguro que la asesoría es gratis?».
Se produce una paradoja peligrosísima: la cuenta publicitaria celebra un éxito rotundo, pero la caja de la empresa está vacía. Para no tirar el presupuesto por el desagüe cuando configuras una campaña unificada de performance en Direct, hay que levantar el capó de los modelos neuronales de Yandex. Vamos a destripar sin ilusiones la lógica interna de la segmentación automática, exponer los errores de arquitectura al entrenar estrategias automáticas y montar un control de ingeniería sobre el flujo publicitario.
La caja negra del aprendizaje automático: por qué el algoritmo no conoce el valor de tu dinero
El fallo de base de la mayoría de los especialistas es atribuirle inteligencia humana al machine learning y suponer que entiende la lógica comercial de un negocio. Grábatelo como un axioma: el algoritmo de Yandex Direct no sabe qué es el beneficio de tu empresa. No tiene la más remota idea del margen de tus productos, del coste de tu stock inmovilizado ni de cuántas horas pierden tus vendedores en llamadas vacías.
El modelo matemático de Direct resuelve un problema de optimización sumamente estrecho: predice la probabilidad de que ocurra un evento concreto (probabilidad de clic o probabilidad de envío de formulario) que tú mismo marcaste como acción objetivo.
Así funciona el ciclo de decisión del algoritmo a nivel micro:
- El sistema evalúa las señales entrantes sobre el usuario: su historial de búsquedas recientes, sitios visitados, tipo de dispositivo, geolocalización y hora del día.
- El modelo calcula un peso probabilístico: qué tan propenso es ese usuario en concreto a rellenar un formulario en la web ahora mismo.
- Si el usuario pertenece a la cohorte de «generadores de leads en serie» —gente a la que le encanta hacer clic en anuncios y dejar sus datos en diez webs seguidas para pedir presupuestos gratis—, ¡el algoritmo le asigna una puntuación altísima!
Para el robot, la solicitud de un estudiante buscando material gratuito para su trabajo de fin de grado y la solicitud del director general de una fábrica pidiendo maquinaria por valor de 10 millones de rublos son idénticas. Ambas disparan la marca goal_achieved = 1. Y como atraer al estudiante es diez veces más barato y fácil, la estrategia automática empezará encantada a inundar tu web con ese tráfico basura, informando orgullosa de que bajó el coste por lead (CPL). Al analizar cómo las estrategias automáticas queman el presupuesto, confirmamos la regla: cualquier optimización desconectada del dinero se convierte en una fábrica de espejismos.
Búsqueda frente a RSYA: la diferencia fundamental entre intención y probabilidad
El segundo error crítico de quienes gestionan campañas es meter en el mismo saco la lógica del Buscador y la de la Red Publicitaria de Yandex (RSYA). Son entornos radicalmente distintos con mecánicas opuestas para captar audiencia.
La publicidad en Búsqueda trabaja con intención comercial explícita (Intent): En el buscador, es el propio usuario quien formula su problema. Cuando alguien escribe «comprar chiller industrial para enfriar leche con envío Moscú», ya se encuentra en la fase final del embudo. La tarea del sistema es simplemente mostrar la respuesta más relevante.
Sin embargo, con la llegada del autotargeting obligatorio incluso en Búsqueda, Direct dejó de apoyarse exclusivamente en tus palabras clave. Los embeddings neuronales analizan el titular de tu anuncio y el texto de la landing page para adivinar bajo qué otras búsquedas mostrarte. Y si vendes frío industrial, el sistema es perfectamente capaz de colarte la búsqueda «por qué no congela una nevera doméstica Atlant». Semánticamente se parece —frío, avería, reparación—, pero el valor comercial de esa consulta es cero absoluto.
RSYA trabaja con probabilidad de interés (Interest & Behavior): En las redes de display el usuario no está buscando tu producto en ese segundo. Está leyendo el pronóstico del tiempo, mirando la receta de un pastel o ojeando noticias en un portal sectorial. El algoritmo le enseña un banner basándose en sus rastros de comportamiento: lo que buscó hace tres días o las páginas que visitó.
Pero tener interés en un tema no equivale en absoluto a estar dispuesto a pagar:
- El usuario puede estar leyendo un artículo sobre montaje de tejados porque se está construyendo una caseta de campo con sus propias manos;
- Puede ser un estudiante de formación profesional preparando una práctica;
- Puede ser tu competidor directo vigilando el mercado.
Para el robot de RSYA todos ellos lucen igual de atractivos. Por eso en RSYA es letal optimizar hacia microconversiones intermedias como «pasó 60 segundos en la web» o «hizo scroll hasta la mitad». Solo entrenarás al sistema para traerte lectores ociosos, vaciando tu presupuesto en los bolsillos de webs llenas de clickbait.
Cinco categorías de segmentación automática: cuáles apagar al arrancar la campaña
Echemos un vistazo al sancta sanctorum de Direct: las categorías de segmentación automática en los anuncios de texto y gráficos. La documentación oficial de Yandex divide todo el autotargeting en cinco cestas rígidas:
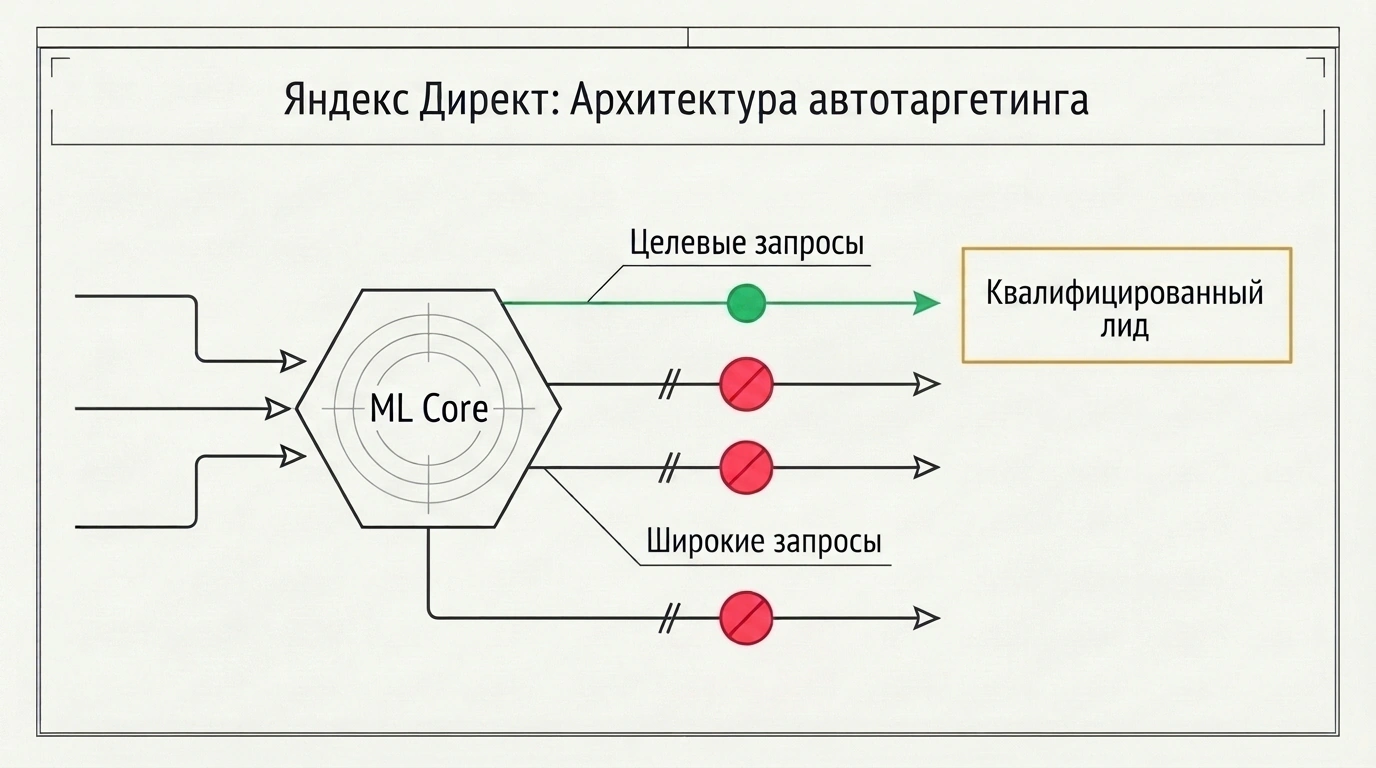
Esquema conceptual de selección de consultas de búsqueda en la segmentación automática de Yandex Direct: filtrado de tráfico irrelevante mediante un sistema de filtros.
- Consultas objetivo (Target queries): búsquedas que reflejan con exactitud y sin ambigüedad la necesidad de comprar el producto o servicio anunciado (por ejemplo, «encargar proyecto de ventilación para nave industrial»).
- Consultas alternativas (Alternative queries): el usuario busca otro producto que potencialmente resuelve el mismo problema (por ejemplo, busca «aire acondicionado para sala de servidores» cuando tú ofreces un sistema split de precisión).
- Consultas complementarias (Complementary queries): bienes y servicios que suelen comprarse junto con tu producto (por ejemplo, buscar «comprar conductos de aire galvanizados» frente a un anuncio de instalación de ventilación).
- Consultas con mención de competidores (Competitor queries): búsqueda directa de las marcas rivales de tu mercado.
- Consultas amplias (Broad queries): términos genéricos de alto volumen cuyo interés desborda tu oferta concreta (por ejemplo, simplemente la palabra «ventilación» o «microclima»).
La propia guía oficial de Yandex Direct da una recomendación inequívoca: ¡en la fase de lanzamiento y aprendizaje de una campaña nueva, las categorías «Consultas amplias» y «Consultas complementarias» deben desactivarse sin excepción!
Si dejas el autotargeting amplio encendido en una cuenta fría, la red neuronal arrastrará la campaña al instante hacia basura semántica barata. Quemará el presupuesto semanal inicial en consultas informativas de valor casi nulo antes de llegar a reunir conversiones del núcleo objetivo.
Además, Direct incorporó una herramienta potente de ajuste fino: la «Descripción de consultas de búsqueda» (un prompt de hasta 500 caracteres). No te dé pereza rellenar ese campo a mano. Escribe allí con lenguaje claro a quién va dirigida tu oferta y a quién hay que excluir de raíz: «Suministros B2B de equipamiento industrial para restaurantes y comedores. No electrodomésticos, no reparación de aparatos del hogar, no venta minorista, tickets desde 300 000 rublos». Ese contexto textual influye directamente en los embeddings neuronales de emparejamiento.
El círculo vicioso de la optimización: cómo un formulario de consulta gratis rompe el machine learning
Analicemos la trampa clásica en la que cae el 80% de las empresas con productos complejos. Llamémosla el «ciclo autosostenido de degradación del tráfico».
Imagina un despacho de abogados especializado en litigios mercantiles y defensa de activos corporativos. Ticket por operación: desde 500 000 rublos. El marketer coloca en la web un lead magnet llamativo: «Consiga una asesoría exprés gratuita de un abogado en 15 minutos». En Yandex Metrica crea el objetivo «Envío de formulario» y en Direct activa la estrategia automática «Optimización de conversiones» con pago por clic o por conversión.
Lo que ocurre acto seguido:
- Entra en la web un jubilado o un estudiante que tiene una pelea vecinal por una tubería con goteras o un perro que ladra. Ve la palabra mágica «Gratis», mete felizmente su teléfono y pulsa el botón.
- Metrica registra al instante: ¡viva, objetivo cumplido! El dato vuela hacia Direct.
- El robot analiza el perfil de ese usuario: edad, intereses, comunidades que sigue, hábitos de navegación. Para él, ese jubilado es el modelo perfecto de cliente objetivo: trajo una conversión barata de 300 rublos frente a un límite planeado de 2 000 rublos.
- ¿Qué hace el algoritmo después? Sale a aspirar por todo internet a personas con huellas digitales idénticas: gente que busca ayuda legal gratis para líos domésticos.
- Dos semanas más tarde, la campaña está optimizada «a la perfección»: entran decenas de solicitudes al día y el CPL está en mínimos históricos. Pero cuando los abogados llaman a esos leads, descubren que ninguno tiene un céntimo y el despacho necesita pleitos entre sociedades mercantiles.
El algoritmo no se equivocó. Ejecutó a la perfección la orden que le dio el humano. Le serviste como señal de éxito un indicador erróneo y la máquina escaló esa basura con eficiencia mecánica. Para salir de este infierno cuando compites en una subasta recalentada de Yandex Direct, hay que cambiar de raíz la arquitectura de las señales de retorno.
Caso de Nizhni Nóvgorod: cómo la subida del CPL redujo el coste de la venta real
Veamos un caso práctico real de una empresa de Nizhni Nóvgorod dedicada al suministro de equipos profesionales de lavado y al equipamiento integral de centros de detailing. La compañía vende hidrolimpiadoras de alta presión industriales (AVD), generadores de espuma, compresores estacionarios y sistemas de depuración de agua. Ticket medio por contrato: desde 400 000 rublos.
Primer mes (Enero) — Despilfarro clásico en «leads baratos»:
- Configuración: Búsqueda + RSYA, estrategia automática optimizada al objetivo «Envío de cualquier formulario en la web».
- Presupuesto: 110 000 rublos.
- Solicitudes recibidas: 44 leads.
- Coste formal por lead (CPL en la plataforma): 2 500 rublos.
A primera vista, un resultado estupendo para maquinaria compleja. Pero la auditoría del equipo comercial destapó el desastre: de las 44 solicitudes, solo 16 eran clientes comerciales reales. Las otras 28 llamadas eran particulares buscando una minilimpiadora Karcher barata de 8 000 rublos para lavar alfombras en el garaje, o gente pidiendo mangueras y juntas de céntimos que la empresa ni siquiera vende.
El coste real de cada oportunidad cualificada (SQL) fue:
110 000 rub. / 16 leads = 6 875 rublos!
Segundo mes (Febrero) — Reconstrucción de señales y filtrado de demanda: El equipo apagó el piloto automático y ejecutó una cirugía de precisión:
- Rediseño de landing pages: eliminaron los titulares vagos. En la primera pantalla pusieron un filtro tajante: «Equipos profesionales de lavado para túneles de autolavado, flotas y plantas industriales. Pedido mínimo desde 150 000 rublos. No vendemos al por menor para garajes ni uso doméstico».
- Limpieza de anuncios: sacaron de los textos expresiones genéricas de hidrolimpiadoras domésticas y las sustituyeron por «AVD industriales 380V» y «equipamiento llave en mano de lavaderos comerciales».
- Separación de objetivos en Metrica: implantaron un estado de cualificación en el CRM. Los datos de cada solicitud solo se enviaban de vuelta a Direct cuando el comercial marcaba el lead como «Cualificado (B2B)».
- Presupuesto: 105 000 rublos.
- Solicitudes recibidas: 35 leads (caída del 20%).
- Coste formal por lead en la plataforma: ¡subió a 3 000 rublos! A simple vista, un marketer sin criterio habría gritado que era un fracaso: menos leads y más caros. Pero miremos el CRM: ¡de las 35 solicitudes, 21 clientes superaron la cualificación! El coste real del lead cualificado cayó de 6 875 a 5 000 rublos. ¡La eficiencia subió casi un 30%!
Tercer mes (Abril) — Sincronización con margen y almacén: En abril el equipo fue un paso más allá: conectó las campañas con el stock real disponible en almacén. Descubrieron que parte de los clientes válidos se caía por los largos plazos de entrega en referencias bajo pedido. Reenfocaron la publicidad exclusivamente hacia conjuntos rentables en existencia inmediata.
- Presupuesto: 115 000 rublos.
- Solicitudes recibidas: 37 leads.
- Leads cualificados: 24 clientes.
- Coste del SQL: bajó a 4 790 rublos mientras subía la tasa de cierre a contrato.
Este caso demuestra algo incontestable: en B2B y tickets medios o altos, perseguir un CPL barato es el camino directo a la ruina. La publicidad debe medirse exclusivamente por la cadena: «Clic → Lead cualificado → Contrato → Beneficio marginal».
Masa crítica de conversiones: microobjetivos, valor de conversión y 15 eventos por semana
Aquí surge una duda técnica muy lógica: «Si optimizamos la campaña solo hacia tratos B2B cualificados, y cerramos apenas 2 o 3 a la semana, ¿cómo entrenamos a la estrategia automática? ¡Se va a quedar sin datos!».
Es totalmente cierto. Las matemáticas del machine learning en Yandex Direct exigen un umbral estadístico sólido: para que una estrategia automática de conversiones funcione estable, necesita recibir al menos 10–15 eventos objetivo por semana a nivel de campaña. Con menos volumen, el algoritmo entra en deriva estocástica: las pujas dan bandazos, las impresiones se congelan en cero o queman el tope diario en dos horas.
¿Cómo resolver este dilema? Mediante una arquitectura de objetivos compuestos multinivel asignando un «Valor de conversión» (Goal Value):
- Macroconversión (Objetivo final):
- «Lead cualificado desde CRM» o «Factura pagada».
- Le asignamos el valor máximo: por ejemplo, 10 000 rublos.
- Microconversión de peso (Interés avanzado):
- «Completar el quiz de cálculo de presupuesto» o «Descargar el catálogo técnico introduciendo un email corporativo».
- Le asignamos un valor intermedio: por ejemplo, 1 500 rublos.
- Microconversión de comportamiento (Filtrado inicial):
- «Visita a la página de precios y condiciones de leasing + profundidad mínima de 3 páginas + tiempo en web superior a 90 segundos».
- Le asignamos un valor base: por ejemplo, 200 rublos.
Después, en la configuración de Direct elegimos la estrategia «Máximo de conversiones» optimizada hacia objetivos clave y con límite por porcentaje de gasto publicitario sobre ingresos (DRR) o presupuesto semanal.
Qué logra esto en el algoritmo: El sistema recibe el volumen estadístico necesario (entre 30 y 50 eventos semanales en total), ¡pero entiende matemáticamente las prioridades! No se lanza a optimizar clics hacia visitas baratas porque el formulario de presupuesto completado le aporta 10 veces más peso virtual que una simple lectura. Le damos al robot un flujo denso de datos para entrenar sin dejar que se degrade hacia el clickbait.
Protocolo de control de ingeniería: checklist de auditoría e higiene de palabras negativas
Para que tus campañas no vivan una vida secreta a tus espaldas, necesitan supervisión técnica periódica. Adopta como regla ejecutar una auditoría semanal siguiendo este checklist:
- Inspección periódica del Informe de consultas de búsqueda: Cada 3 o 4 días abre el informe «Consultas de búsqueda» agrupado por condiciones de activación. Filtra las filas donde el disparador fue «Segmentación automática» (Autotargeting). Lee con atención las frases reales que escribieron personas de carne y hueso. Toda consulta informativa, doméstica, basura o fuera de tu zona geográfica debe ir directa a la lista de palabras negativas a nivel de campaña.
- Control de ubicaciones prohibidas en RSYA: En RSYA hasta el 40% de las impresiones puede fugarse hacia apps móviles, juegos infantiles (donde los niños pulsan el banner sin querer) y granjas de dominios con recarga automática. Descarga con regularidad el informe de ubicaciones y bloquea sin piedad dominios con tiempo en sitio cero, CTR anormalmente alto (>5–7% en redes es síntoma seguro de clic accidental o fraude) y cero conversiones.
- Protección frente a cambios compulsivos (Stop Tinkering): Los algoritmos de aprendizaje automático necesitan entre 7 y 14 días para recalibrar pesos tras cualquier cambio relevante. El peor vicio del marketer novato es toquetear los ajustes cada día: por la mañana baja el presupuesto un 10%, al mediodía cambia el texto del anuncio y por la noche modifica el CPC objetivo. Cada retoque borra el progreso de aprendizaje acumulado y obliga al sistema a empezar de cero. Aplica cambios en bloque y deja que la campaña trabaje al menos una semana con parámetros estables.
- Segmentación por economía, no por demografía: No intentes recortar audiencia por sexo o edad: en B2B el comprador puede ser un chico de 25 años o una directiva de 60. Divide tus campañas según el margen de los productos, la geografía logística y el ticket medio.
Yandex Direct hoy es un sistema de ingeniería complejísimo. Deja de tratarlo como un botón mágico y deja de pelear contra la automatización con métodos de la vieja escuela. Ponle al algoritmo marcos rígidos, aliméntalo con señales financieras reales desde tu CRM, mantén el pulso sobre la analítica... y entonces las máquinas inteligentes de Yandex trabajarán para tu beneficio, no para tu ruina.