Cuando lanzas en la terminal el habitual git push, da la sensación de que los cambios simplemente aterrizan en una carpeta de un servidor remoto. Pero entre bastidores, en el lado de GitHub se activa el enrutador interno y coordinador de almacenamiento Spokes: recibe los objetos empaquetados, los distribuye entre servidores independientes en distintas salas y vigila que los nodos confirmen de forma síncrona el nuevo estado del repositorio. Durante mucho tiempo esta mecánica pasó desapercibida porque el ritmo lo marcábamos las personas: escribir código, probarlo en local, subir la rama a revisión.
Todo cambió con la llegada de los agentes de IA autónomos: decenas de bots sin pausas para el café crean ramas en paralelo, ejecutan tests y envían correcciones a ritmo de ametralladora. Las ingenieras de GitHub Eleonora White y Victoria Dye, en un análisis de la nueva arquitectura de almacenamiento que destacó el canal DevOps&SRE Library, mostraron las entrañas de este «giro agéntico». ¿Cómo escalar una plataforma del tamaño de GitHub cuando los agentes autónomos generan un flujo continuo de commits y bloquean los repositorios más activos?
El techo físico de los centros de datos y la barrera de los 25 milisegundos
El crecimiento explosivo del tráfico generado por agentes de IA (hace poco te conté cómo los asistentes neuronales multiplican por más de cinco los commits por ingeniero en medio año al analizar el estudio de Anthropic) chocó contra un límite físico. Los centros de datos de GitHub y la red eléctrica regional alcanzaron su tope de potencia, mientras que las cadenas de suministro de hardware impedían ampliar racks in situ con rapidez. Había margen suficiente para migrar con seguridad a la nube de Azure, pero no se podía perder tiempo. Como las operaciones Git en GitHub pertenecen al nivel crítico Tier 0, no se atrevieron a cambiar a la vez el alojamiento y la arquitectura de almacenamiento bajo una carga creciente: primero trasladaron los datos tal cual para rediseñar después la arquitectura en la nube.
En agosto de 2025, la primera copia de un repositorio aterrizó en la región Azure Central US. La mayoría de los repositorios se guardan en un quórum de 5 réplicas: hoy, 2 de cada 5 réplicas viven en Azure y atienden alrededor de la mitad de todo el tráfico Git, mientras que el enrutamiento preferencial (preferential routing) en Spokes dirige las lecturas hacia la réplica de la misma región y zona de disponibilidad.
Para octubre de 2026 ya se había replicado en Azure el 99,99999 % de los repositorios de GitHub, pero el 0,00001 % restante —los proyectos más calientes— se quedó atascado. Al leer el informe me llamó enseguida la atención el motivo: los frenaba una única constante física. La región destino de Azure está a unas 1000 millas de los centros de datos de GitHub, así que un viaje de ida y vuelta por red (round trip) tarda unos 25 ms, y cada escritura en Git exige varios intercambios de paquetes. Para un repositorio al límite de su capacidad, esos 25 ms en cada paso se convirtieron en un muro infranqueable.
Del cerrojo global del repositorio a los quórums independientes por referencia
¿Por qué la latencia interregional golpeó tanto a las escrituras? Formalmente, para confirmar una escritura al quórum de Spokes le basta la mayoría (3 de 5 nodos), pero en la práctica espera la respuesta de cada réplica sana hasta agotar el timeout para que los servidores lejanos no se queden atrás. Al final, la latencia de cada escritura la dicta la réplica más lenta a 25 ms de distancia. Y, encima, en el esquema antiguo cada escritura adquiría un bloqueo exclusivo de todo el repositorio (repository-wide lock) durante todo ese intercambio de red.
Imagina un edificio de oficinas con mil despachos y un único juego de llaves en recepción para toda la planta. Mientras un mensajero sube con él al piso diez para abrir la sala 101 y no devuelve las llaves al conserje, otros veinte repartidores esperan junto al torno, aunque solo tengan que entregar paquetes en oficinas completamente distintas de la primera planta.
Veamos este atasco en un escenario real de un clúster Spokes de 5 réplicas (3 en el centro de datos local y 2 en Azure con 25 ms de ida y vuelta). En un repositorio activo trabajan en paralelo 20 agentes de IA autónomos en ramas aisladas agent/task-1…agent/task-20, y en ese mismo segundo un desarrollador sube un arreglo urgente a hotfix/login o un commit a main. Con el bloqueo global solo hay una escritura en vuelo: el desarrollador se pone al final de una cola única detrás de veinte agentes y espera a que cada uno complete varios viajes de 25 ms hasta Azure. La cola crece y los pushes empiezan a caer por timeout.
Seguramente te estés preguntando: ¿para qué bloquear todo el repositorio si los agentes y el desarrollador tocan ramas distintas? Aquí entró en juego el primer principio de la nueva arquitectura de GitHub: minimizar la coordinación (minimize coordination), es decir, no ordenar lo que no necesita consenso. En Git las exigencias de consistencia aplican de forma individual a cada referencia (reference, por ejemplo refs/heads/main): tras actualizar una rama, ningún cliente debe ver su valor anterior, ya sea un fast-forward, un force push o un borrado. Pero las actualizaciones de ramas diferentes no dependen unas de otras.
Pasar Spokes a una serialización por referencia individual (per-reference serialization) quitó el candado general de la puerta. En nuestro escenario, las ramas agent/task-1…agent/task-20 y hotfix/login cruzan en paralelo el puente de 25 ms hacia Azure, y solo se esperan entre sí los pushes que compiten por la misma rama. En pruebas internas con tráfico realista, esto multiplicó el rendimiento de escritura por 3–4 veces con menor latencia y abrió el camino a Azure para ese 0,00001 % de repositorios hiperactivos.
Réplicas virtuales y traslado del almacenamiento a Azure Blob Storage
El siguiente paso fue descargar las lecturas. En un repositorio típico, por cada escritura llegan entre 100 y 1000 operaciones de lectura (git clone, git fetch, builds de CI y lectura de código por parte de agentes). Antes ambos flujos iban a parar a las mismas 5 réplicas: las lecturas necesitan mucha caché en RAM, pero esa misma memoria la devoraba la compactación en segundo plano (compaction).
El segundo principio de GitHub es desacoplar el almacenamiento del cómputo (decouple storage from compute). Los ingenieros introdujeron en el quórum de Spokes una réplica virtual de escritura (virtual write replica) efímera y sin estado persistente propio. No atiende lecturas: traduce el flujo de escrituras al almacenamiento de objetos Azure Blob Storage y confirma el commit en el quórum en cuanto los datos quedan guardados en la nube. Además, la réplica virtual de escritura aplica coalescencia de transacciones (coalescing): agrupa commits paralelos de ramas independientes (los de nuestros 20 agentes y la rama hotfix/login) en un único paquete de E/S de red hacia Blob Storage. El repositorio paga un solo viaje de red en lugar de veinte, mientras ese mismo nodo realiza la compactación de archivos.
Con los datos de referencia guardados en Azure Blob Storage, la plataforma levanta bajo demanda tantas réplicas virtuales de lectura (virtual read replicas) como haga falta. No forman parte del quórum de escritura: cada nodo calienta su caché local directamente desde Blob Storage (recibiendo ya el estado compactado) y concilia en segundo plano los cambios con el almacenamiento en la nube. Cuando leí los resultados de sus pruebas internas, lo que más me impresionó fue el detalle del banco de carga: el generador de carga distribuido de GitHub, que antes chocaba siempre contra el techo de la arquitectura antigua, con las réplicas virtuales de lectura agotó por primera vez sus propios límites antes de que flaquearan los servidores del repositorio.
Inmutabilidad de los objetos Git y el camino hacia los siguientes mil millones de repositorios
Esta arquitectura de transición tiene sus propios límites. Si decenas de agentes hacen push a la vez a una misma rama compartida refs/heads/main, siguen teniendo que esperar turno y lidiar con pushes no fast-forward rechazados. Además, la conciliación en segundo plano entre las réplicas virtuales de lectura y Blob Storage no sirve para todos los casos: para garantizar lectura inmediata justo después de escribir, la conciliación pasa a modo síncrono (in-line reconciliation), trayendo solo las referencias y datos modificados.
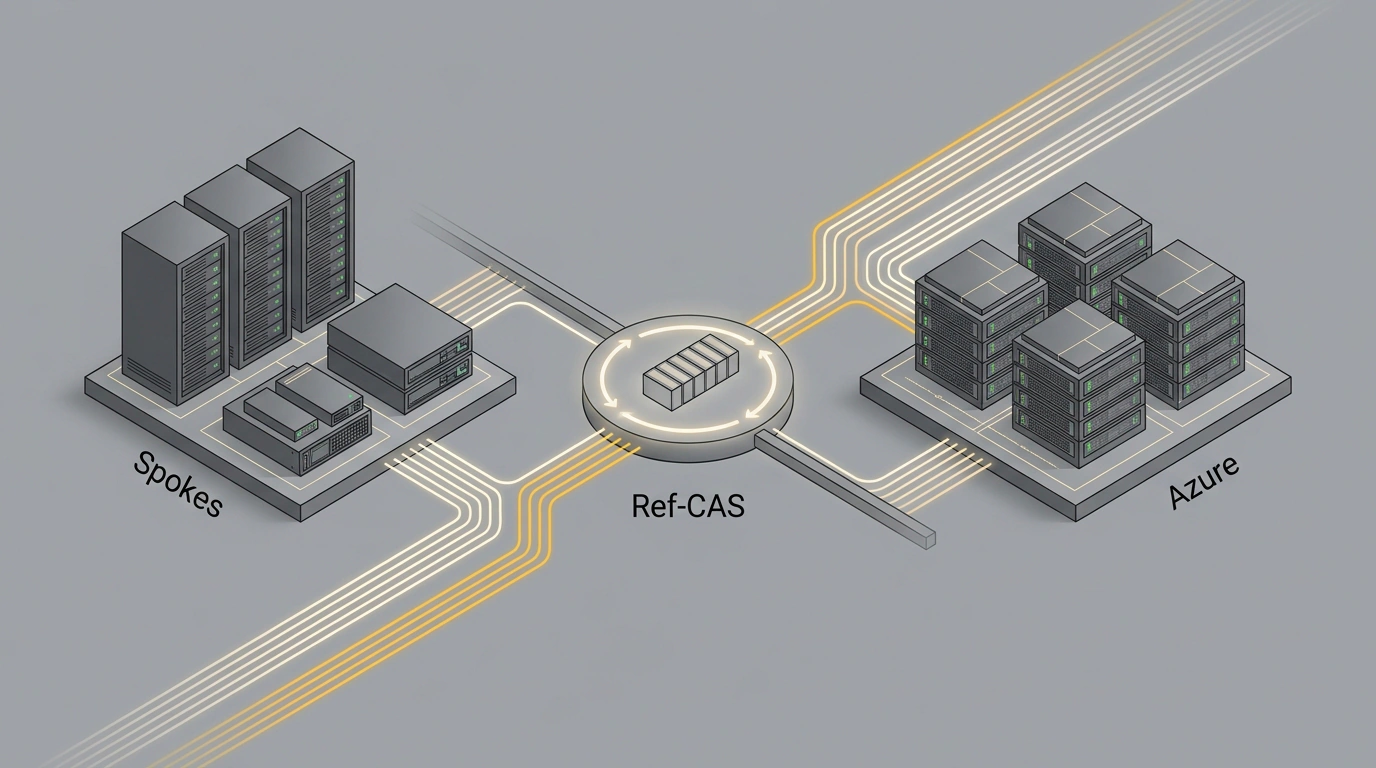
Hoy Spokes procesa más de 100 000 millones de operaciones al día y gestiona la recuperación en segundo plano («sweepers») de mil millones de repositorios, pero un protocolo basado en copias completas del repositorio no aguantará los siguientes mil millones de proyectos. Por suerte, en Git los propios objetos (blobs de archivos, árboles y commits) son inmutables (immutable) y se direccionan por el hash de su contenido (un modelo que permite guardar dentro del árbol de objetos incluso rastreadores distribuidos como git-bug). Se pueden guardar en paralelo sin votaciones.
Lo único que necesita ordenarse en el tiempo es el diminuto puntero mutable de cada referencia. Como explican los ingenieros Kartik Raman y Brian Selenza en la presentación de la arquitectura objetivo Project Rubicon, para ello se aísla un servicio ligero de consenso llamado Ref-CAS (Reference Compare-And-Swap), que actualiza de forma atómica un registro replicado de referencias mientras un pool aislado de workers compacta los packfiles en segundo plano. El diseño está pensado para soportar hasta 5000 agentes autónomos y hasta 7200 pushes por segundo en un único repositorio.
En mi opinión, la experiencia de GitHub deja muy claro hacia dónde se mueve toda la infraestructura de desarrollo: cuando los agentes autónomos convierten la escritura y verificación de código en una cadena de montaje continua de 24 horas, los sistemas de almacenamiento abandonan los bloqueos globales. En la carrera hacia los próximos mil millones de repositorios gana la arquitectura que separa la masa inmutable de objetos de un núcleo diminuto de estado y sincroniza por red únicamente esos pocos bytes imprescindibles.