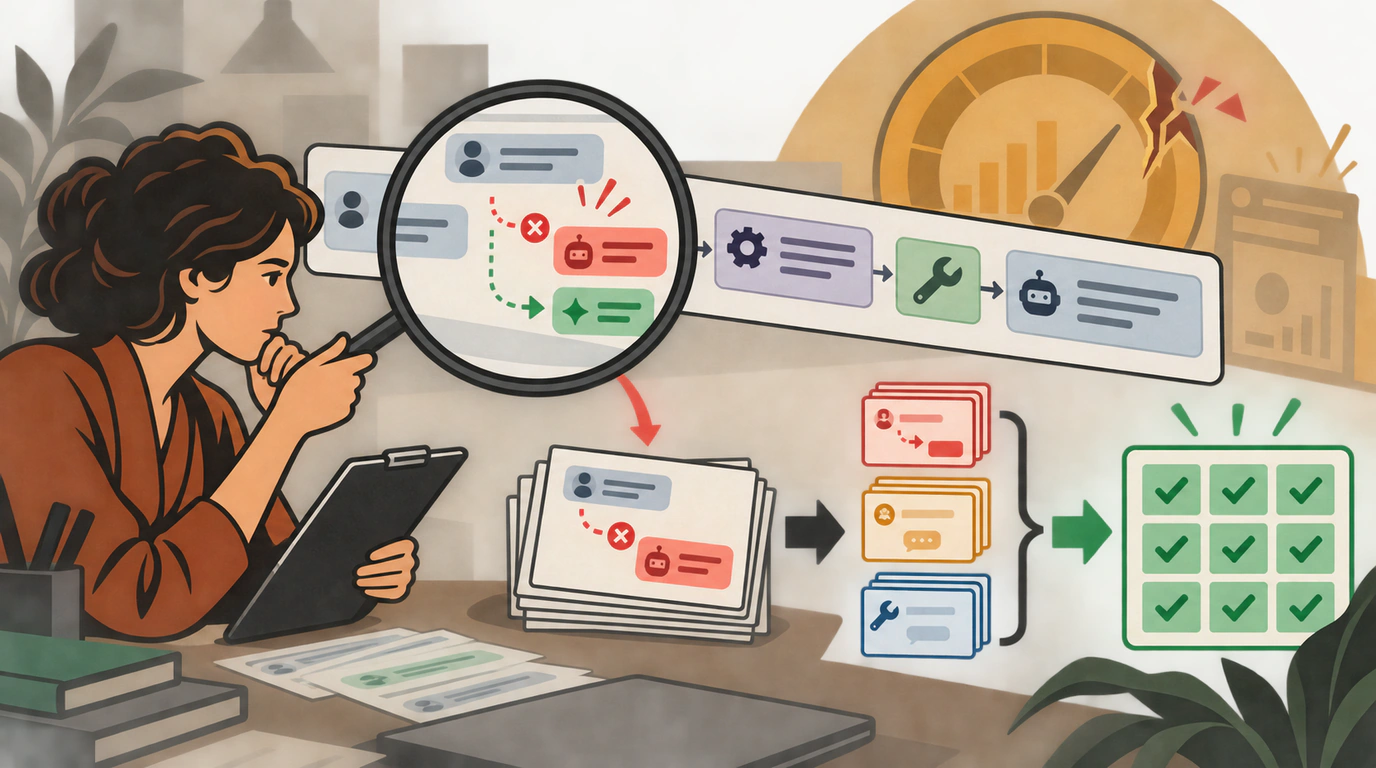

Инженерные команды, создающие продукты на базе больших языковых моделей, регулярно сталкиваются с парадоксом: любое изменение системного промпта, смена модели или обновление логики вызова инструментов способно улучшить один сценарий диалога и одновременно сломать десяток других. Традиционное программное обеспечение подчиняется детерминированным тестам, однако генеративный ИИ ведет себя иначе. Чтобы вернуть управляемость разработке, индустрия переходит к эвалам (evals) — воспроизводимым процедурам проверки качества и надежности поведения моделей перед выпуском обновлений.
Венчурные инвесторы и руководители лабораторий называют эвалы главным конкурентным преимуществом ИИ-проектов. Бывший директор по продукту Anthropic Майк Кригер прямо отмечает, что навык построения систем оценки стал ключевой компетенцией продуктовых специалистов, а глава Y Combinator Гарри Тан подчеркивает, что именно эвалы формируют технологический ров стартапов. Опыт лидеров рынка подтверждает прямую финансовую отдачу:
- В Shopify системные эвалы помогли создать ИИ-конструктор процессов, который работает в 2,2 раза быстрее и обходится на 68% дешевле прежней системы;
- Команда Cursor оптимизировала алгоритм маршрутизации Auto Balance, снизив расходы на вычисления на 41% при росте удовлетворенности пользователей;
- Финтех-сервис Ramp поднял точность автоматического распознавания чеков с 35% до 83%;
- В юридическом сервисе Harvey переработка ассистента по проверке контрактов с опорой на эвалы почти вдвое увеличила показатель качества ответов.
Однако за этими цифрами скрывается опасная методологическая ловушка. Консультируя более 50 ИИ-компаний, исследователи Хамель Хусейн и Шрейя Шанкар обратили внимание на системный антипаттерн: разработчики спешат немедленно закодировать числовые метрики и построить дашборды. В результате команды тратят недели на автоматизацию проверки вторичных параметров, пропуская фундаментальные дефекты пользовательского опыта.
Ловушка дрейфа критериев и этап Error Discovery
Ручной разбор длинных журналов сессий кажется медленным занятием, тогда как числовые метрики дают ощущение инженерной строгости. Однако если метрики формулируются до глубокого погружения в данные, команда закладывает в них абстрактные теоретические предположения.
Этап исследования ошибок (Error Discovery) представляет собой аналог продуктового исследования (Product Discovery). Подобно тому как Product Discovery выявляет реальные проблемы клиентов, Error Discovery показывает, какие категории отказов модели критичны для продукта и требуют постоянного контроля.
Попытка переложить первичный поиск сбоев на автономных кодинг-агентов наталкивается на препятствие — дрейф критериев (criteria drift). Представления о том, как выглядит «качественный ответ», не существуют в готовом виде: они кристаллизуются только по мере чтения реальных сессий.
Показателен опыт работы с ИИ-ассистентом для аренды недвижимости Nurture Boss. В одной из пользовательских сессий произошел диалог:
- Арендатор: «Это выходит за рамки моего бюджета. Спасибо за уделенное время».
- ИИ-ассистент: «Пожалуйста! Если ваша ситуация изменится или возникнут вопросы, обращайтесь. Хорошего дня!»
С точки зрения базовых метрик связности речи и вежливости ответ безупречен. Автоматический судья поставил бы высший балл: ассистент вежлив и корректно попрощался. Однако цель сервиса — содействие сделкам. Ассистент допустил грубую ошибку: не предложил более доступные квартиры или варианты в соседних комплексах компании.
Если бы требование к отработке ценовых возражений было известно заранее, агент легко нашел бы подобные случаи. Но осознать необходимость этого критерия разработчики смогли только после личного чтения диалогов. В этом и заключается суть дрейфа критериев.
Границы автоматизации в анализе трейсов
Анализ 100 реальных сессий ассистента аренды вскрыл четкое разделение возможностей человека и программных инструментов:
- Агенты отлично выявляют противоречия внутри контекста сессии. Если вызов функции вернул статус «квартира сдана», а модель в тексте пишет «свободна», агент мгновенно фиксирует галлюцинацию;
- Агенты упускают ошибки, требующие продуктового контекста вне текста: лишнее Markdown-форматирование в SMS, несвоевременный перевод на оператора или срыв сценария продаж;
- Автоматические оценщики создают шум, нередко помечая удачные нестандартные ответы как сбои.
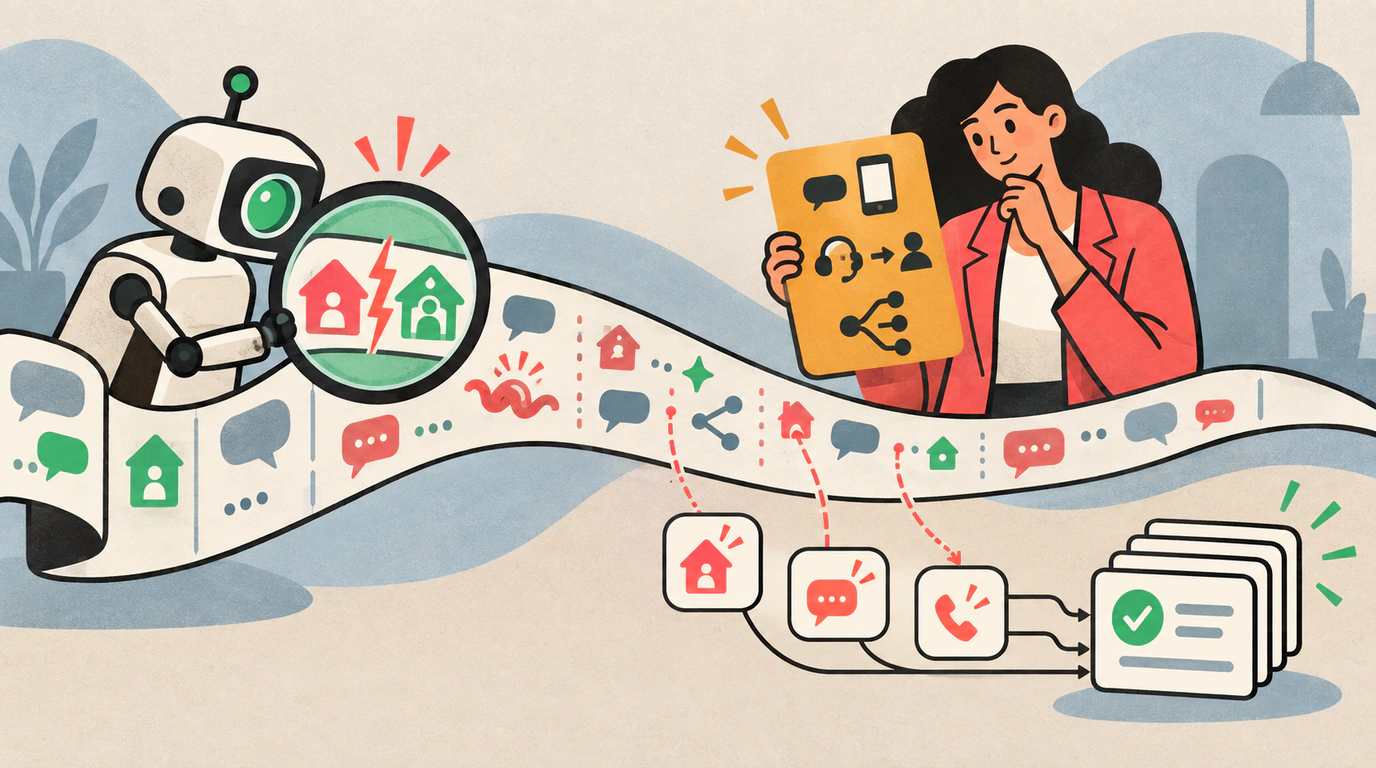
Поэтому эффективный пайплайн строится на активном обучении (active learning), где человек задает вектор, а код берет на себя масштабирование.
Шаг 1. Инструментация и сбор трейсов
Первое условие тестирования — фиксация трейсов сессий (traces). Трейс включает запрос пользователя, системный промпт, промежуточные вызовы инструментов (tool calls) с сырыми ответами и финальный результат, выданный человеку.
Данные можно отправлять на внешние платформы или сохранять локально в файл JSON Lines (traces.jsonl). Ниже приведен базовый пример инструментации сессии:
import json
import time
from pathlib import Path
from typing import Any, Dict, List

def log_session_trace(
    session_id: str,
    user_input: str,
    system_prompt: str,
    tool_calls: List[Dict[str, Any]],
    model_output: str,
    metadata: Dict[str, Any],
    log_path: str = "traces/traces.jsonl"
) -> Dict[str, Any]:
    """Фиксирует полную сессию взаимодействия для последующего аудита эвалов."""
    trace_record = {
        "session_id": session_id,
        "timestamp": int(time.time()),
        "system_prompt": system_prompt,
        "user_input": user_input,
        "tool_calls": tool_calls,
        "model_output": model_output,
        "metadata": metadata
    }
    output_file = Path(log_path)
    output_file.parent.mkdir(parents=True, exist_ok=True)
    with output_file.open("a", encoding="utf-8") as f:
        f.write(json.dumps(trace_record, ensure_ascii=False) + "\n")
    return trace_record
Если реального трафика еще недостаточно, синтетические запросы генерируют по фиксированным осям: типу задачи, профилю пользователя и характеру формулировки.
В следующем примере сценарий расширяется генератором, комбинирующим параметры для тестирования граничных случаев:
import itertools

# Фиксированные оси сценариев для контролируемой генерации синтетики
SCENARIO_AXES = {
    "task": ["запрос цены", "запись на просмотр", "вопрос о животных"],
    "persona": ["студент с ограниченным бюджетом", "семья с детьми", "первичный арендатор"],
    "request_type": ["прямой вопрос", "неоднозначная реплика", "возражение по стоимости"]
}

def generate_synthetic_evaluation_scenarios(axes: Dict[str, List[str]]) -> List[Dict[str, str]]:
    """Создает декартово произведение параметров для тестирования граничных случаев."""
    keys = list(axes.keys())
    combinations = itertools.product(*(axes[k] for k in keys))
    scenarios = [dict(zip(keys, combo)) for combo in combinations]
    return scenarios

# Пример формирования тестового пула сессий
test_scenarios = generate_synthetic_evaluation_scenarios(SCENARIO_AXES)
print(f"Сформировано {len(test_scenarios)} уникальных сценариев для синтетического стресс-теста.")
Шаг 2. Разметка данных и правила продуктивного аудита
Для ускорения разметки открыт плагин evals-skills, устанавливаемый командой:
npx skills add https://github.com/ai-evals-course/evals-skills
Плагин изучает схему записей, разворачивает локальный веб-интерфейс и адаптирует отображение данных под конкретный тип продукта.
Чтобы исключить когнитивное смещение (automation bias), действует строгое правило: инженер или продакт-менеджер должен лично просмотреть и разметить первые 10 трейсов до того, как ИИ начнет предлагать собственные гипотезы.
При разметке важно соблюдать три практических принципа:
- Формулировать симптом на языке пользовательского опыта: замечание должно быть проверяемым («Ассистент согласился с отказом вместо предложения квартир в соседнем корпусе»);
- Не пытаться проводить внутренний анализ первопричин (root cause analysis) в момент разметки: важно зафиксировать внешнее проявление проблемы;
- Всегда останавливаться на первой ошибке в цепочке (upstream error): исправление ранней ошибки автоматически устраняет каскад вторичных дефектов.
Шаг 3. Кластеризация и перевод ошибок в инженерные задачи
После того как эксперт разметил около 100 трейсов, система группирует пометки по схожим семантическим паттернам и выводит частотную статистику отказов.
Только теперь, когда слабые места продукта подтверждены реальными данными, наступает время писать автоматические метрики и формировать регрессионные тесты. Эвалы, выросшие из анализа ошибок, превращают настройку моделей в строгую и воспроизводимую инженерную практику.