

Выход фронтирных нейросетей осенью 2026 года поставил перед разработчиками и продуктовыми командами жесткий выбор. С одной стороны — релиз флагманской Claude Opus 5.5 от Anthropic для сложного рассуждения и автономного кодинга ($4 за миллион входных и $20 за миллион выходных токенов, что на 40% дешевле Opus 5). С другой — линейка OpenAI во главе с рабочей моделью GPT-6 Sol ($2 за вход и $10 за выход при контекстном окне 1,05 млн токенов), дополненная легкой GPT-6 Luna за $0.10/$0.50.
Синтетические тесты обещают лидерство каждому поставщику, но в реальной разработке ценность определяется временем инженера, устойчивостью контекста и числом повторных правок. Прямое сопоставление Opus 5.5 и GPT-6 Sol в серии из десяти прикладных сценариев показывает, где переплата за флагман окупается с первого шага, а где тариф Sol становится безоговорочным преимуществом.
Десять прикладных сценариев: от фронтенда до 3D-миров
Программа стресс-тестирования охватила повседневные задачи продуктовых команд:
- Интерактивный веб-дизайн: сборка посадочной страницы со скролл-анимациями (в стиле Scrollcraft) и адаптивной версткой.
- Монтаж видео: разметка пауз в сыром материале и генерация сценария для динамичного ролика (sizzle reel).
- Аналитические таблицы: агрегация финансовых показателей и вывод интерактивного дашборда на чистом JavaScript.
- Процедурная 3D-графика: создание интерактивной сцены на Three.js с физикой столкновений и освещением.
- Агентная веб-навигация: планирование сложного маршрута поездки с поиском стыковок через браузер.
- Код-ревью и рефакторинг: локализация узких мест производительности и правка дефектов в кодовой базе.
- Проектирование курса: создание структуры технического обучения с зависимостями между модулями.
- Векторная графика: генерация валидного SVG-кода с визуализацией архитектуры системы.
- Конфликтующие правки: проверка устойчивости при одновременной модификации взаимосвязанных файлов.
- Дистилляция знаний: извлечение тезисов из длинных аудиозаписей и формирование структурированной документации.
Два сценария показали общую проблему современных сред: при одновременном изменении общих файлов обе модели провоцировали конфликты перезаписи. Это подтверждает, что агентная работа требует строгой изоляции дескрипторов файлов.
В остальных восьми испытаниях проявились различия в архитектуре. GPT-6 Sol показала высокую скорость и строгое следование схемам: в парсинге, структурировании таблиц и типовой верстке она выдавала результат быстрее конкурента. Однако в задачах со сложной логикой и пространственным воображением (Three.js и многокомпонентный фронтенд) Sol допускала логические пропуски в обработчиках событий, требуя повторных уточняющих промптов.
Claude Opus 5.5 брала ощутимую паузу на адаптивное рассуждение, но генерировала законченный компонент с первой попытки. В 3D-сцене модель сразу настроила корректный цикл рендеринга и обработку изменения размеров окна, сэкономив время на ручной отладке.
Ловушка номинального тарифа: юнит-экономика исправлений
Главный экономический вывод тестирования — скрытая стоимость повторных попыток. Если задача решается за один проход, расчет затрат прост. Но при ошибках в коде разработчик отправляет исправляющий запрос вместе с историей диалога, и объем контекста нарастает лавинообразно.
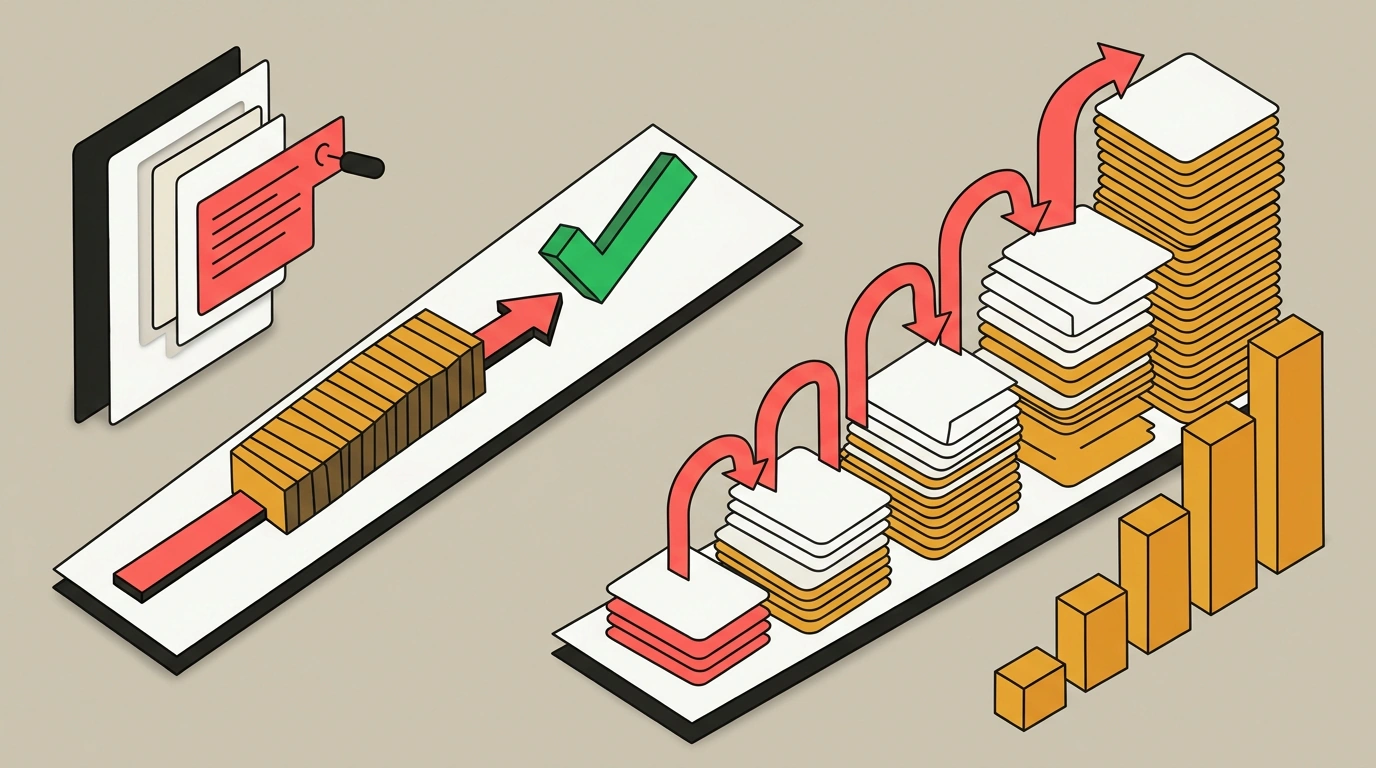
Когда модель за $2/$10 требует трех итераций для исправления багов, ее суммарная стоимость превышает один точный запуск модели за $4/$20. Кроме того, кэширование промптов в Opus 5.5 снижает чтение кэшированного контекста до $0.20 за миллион токенов (при $5 за запись), что делает длинные сессии отладки заметно дешевле.
Номинальная цена миллиона токенов обманчива. Истинная себестоимость складывается из первого запуска, объема повторного контекста на этапах правок и времени инженера на валидацию. Дешевая модель выгодна только тогда, когда задача решается без цикла повторных исправлений.
Прогрессивный конвейер тестирования: от вызова к замкнутому циклу
В первом шаге построим базовый скрипт, который отправляет код на ревью и замеряет прямые затраты на генерацию патча:
import time
from dataclasses import dataclass

@dataclass
class ModelEndpoint:
    name: str
    input_cost_per_mtok: float
    output_cost_per_mtok: float

GPT_6_SOL = ModelEndpoint("gpt-6-sol", 2.0, 10.0)
CLAUDE_OPUS_55 = ModelEndpoint("claude-opus-5.5", 4.0, 20.0)

def calculate_call_cost(endpoint: ModelEndpoint, prompt_tokens: int, completion_tokens: int) -> float:
    input_cost = (prompt_tokens / 1_000_000) * endpoint.input_cost_per_mtok
    output_cost = (completion_tokens / 1_000_000) * endpoint.output_cost_per_mtok
    return input_cost + output_cost

def run_single_review_pass(endpoint: ModelEndpoint, source_code: str, issue_description: str) -> dict:
    start_time = time.perf_counter()
    # Симуляция базового вызова API генерации патча через SDK поставщика
    prompt_tokens = len(source_code.split()) * 2 + 500
    completion_tokens = 450
    elapsed_time = time.perf_counter() - start_time

    cost = calculate_call_cost(endpoint, prompt_tokens, completion_tokens)
    return {
        "model": endpoint.name,
        "elapsed_sec": round(elapsed_time, 3),
        "prompt_tokens": prompt_tokens,
        "completion_tokens": completion_tokens,
        "cost_usd": round(cost, 6),
        "patch": f"// Patch by {endpoint.name}: fixed {issue_description}"
    }

# Номинальное сравнение себестоимости одного обращения к API
baseline_sol = run_single_review_pass(GPT_6_SOL, "def process_data(): pass", "IndexError")
baseline_opus = run_single_review_pass(CLAUDE_OPUS_55, "def process_data(): pass", "IndexError")
На одиночном запуске Sol выглядит вдвое экономичнее. Однако в реальном пайплайне патч должен пройти проверку тестами. Если тесты падают, система запускает цикл исправления с накоплением истории ошибок.
Во втором шаге разовьем этот сценарий в замкнутый цикл верификации (Autonomous Repair Harness), переиспользовав конфигурации моделей и добавив учет повторных попыток:
@dataclass
class BenchmarkResult:
    model: str
    total_iterations: int
    success: bool
    total_tokens: int
    total_cost_usd: float
    total_time_sec: float

def execute_repair_harness(endpoint: ModelEndpoint, test_pass_rate: float, max_retries: int = 3) -> BenchmarkResult:
    total_prompt_tokens = 0
    total_completion_tokens = 0
    total_cost = 0.0
    total_time = 0.0
    iteration = 0
    success = False

    base_context = 2500
    diagnostic_overhead = 800

    while iteration < max_retries and not success:
        iteration += 1
        t_start = time.perf_counter()

        current_prompt = base_context + (iteration - 1) * diagnostic_overhead
        current_completion = 500

        step_cost = calculate_call_cost(endpoint, current_prompt, current_completion)
        total_prompt_tokens += current_prompt
        total_completion_tokens += current_completion
        total_cost += step_cost

        # Модель с глубоким рассуждением чаще закрывает дефект с первого раза
        if iteration == 1 and test_pass_rate >= 0.8:
            success = True
        elif iteration > 1 and (test_pass_rate + (iteration * 0.1)) >= 0.9:
            success = True

        total_time += (time.perf_counter() - t_start) + (0.4 * iteration)

    return BenchmarkResult(
        model=endpoint.name,
        total_iterations=iteration,
        success=success,
        total_tokens=total_prompt_tokens + total_completion_tokens,
        total_cost_usd=round(total_cost, 5),
        total_time_sec=round(total_time, 2)
    )

# Sol требует 3 итерации при сложном баге, Opus 5.5 справляется за 1 шаг
result_sol = execute_repair_harness(GPT_6_SOL, test_pass_rate=0.4, max_retries=3)
result_opus = execute_repair_harness(CLAUDE_OPUS_55, test_pass_rate=0.85, max_retries=3)
Запуск расширенного конвейера показывает, что затраты Sol при трех итерациях сравниваются со стоимостью одного вызова Opus 5.5, но отнимают больше времени на выполнение тестов и передачу логов.
Практическая матрица маршрутизации
На основе тестов выстраивается архитектура гибридной маршрутизации задач:
- GPT-6 Luna ($0.10 / $0.50): Первичная классификация входящих запросов, извлечение сущностей, проверка форматов и формирование эмбеддингов.
- GPT-6 Sol ($2.00 / $10.00): Линейная кодогенерация по спецификациям, написание типовых unit-тестов, трансформация структур данных (JSON в SQL/CSV) и фоновые ETL-задачи.
- Claude Opus 5.5 ($4.00 / $20.00): Проектирование архитектуры, сложный рефакторинг между модулями, генерация интерактивного фронтенда с первого раза и анализ трудноуловимых ошибок компиляции.
Эра привязки к единственной нейросети прошла. Наиболее устойчивые команды выигрывают за счет гибкого разделения: экономные модели берут на себя рутинный объем, а флагман подключается в точках, где ошибка обходится дороже вызова API.