
Осенний релиз флагманских нейросетей 2026 года обострил практический спор среди инженеров и продуктовых команд. С одной стороны выступает Claude Opus 5.5 от Anthropic — модель нового поколения с контекстным окном в один миллион токенов и улучшенным агентным управлением. Ее официальные тарифы составляют 4 доллара за миллион входных и 20 долларов за миллион выходных токенов. С другой стороны находится GPT-6 Astra от OpenAI — абсолютный лидер в задачах автономного рассуждения и прямого управления компьютером, чья стоимость достигает 10 долларов за вход и 50 долларов за выход на миллион токенов.
Разница в цене ровно в два с половиной раза ставит перед разработчиками жесткий экономический вопрос: окупается ли ставка на Astra в прикладных пайплайнах или Opus 5.5 закрывает большинство инженерных потребностей с меньшими затратами? Синтетические бенчмарки редко дают правдивый ответ на этот вопрос, так как не учитывают накопление контекста, случайные регрессии и необходимость ручных правок. Чтобы прояснить границы применимости обеих моделей, исследователь Нейт Херк провел независимое стресс-тестирование на двенадцати разнородных рабочих задачах полного цикла в режиме максимальной глубины рассуждений.
Методология: устранение конфликтов через Git worktrees
Предыдущие попытки сравнивать автономных кодинг-агентов часто страдали от методологической ошибки: запуск двух систем в общей рабочей директории приводил к конкурентной перезаписи файлов сборки и порче промежуточных артефактов. В текущем эксперименте окружение было полностью изолировано с помощью механизма рабочих деревьев Git (git worktree).
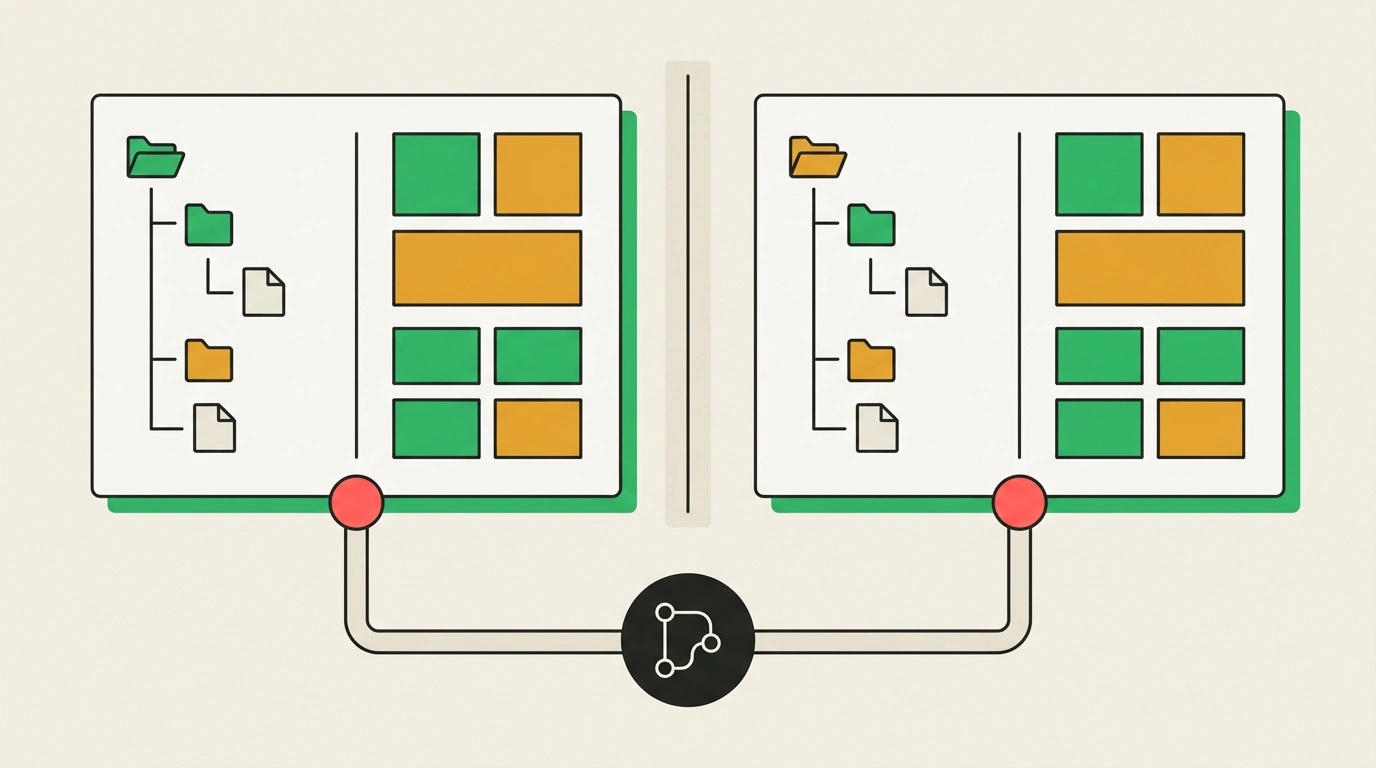
Такой подход гарантирует, что каждая модель стартует из абсолютно одинакового исходного состояния репозитория, но оперирует на отдельной ветке и в собственном изолированном каталоге файловой системы.
# Подготовка изолированных веток и рабочих директорий для чистого эксперимента
git branch benchmark/opus-5-5 main
git branch benchmark/gpt-6-astra main

# Создание независимых файловых пространств без риска взаимной перезаписи
git worktree add ../runner-opus benchmark/opus-5-5
git worktree add ../runner-astra benchmark/gpt-6-astra
Благодаря изолированным воркспейсам обе модели получили идентичные наборы промптов и исходных файлов без взаимных помех. Тестирование охватило двенадцать направлений: интерактивный веб-интерфейс, монтаж видеороликов, нарезку рилсов, финансовые отчеты с балансовыми таблицами, игровую механику квеста, процедурный 3D-мир, бронирование путешествия с веб-поиском, алгоритмическую оптимизацию, анимацию сценария, верстку в Canva API, подготовку каруселей для соцсетей и редизайн сайта книжного издательства.
Двенадцать практических испытаний от фронтенда до финансов
Результаты двенадцати испытаний четко разделили сильные стороны конкурирующих архитектур:
- Интерактивная посадочная страница Scrollcraft. Задача требовала реализовать сложную скролл-анимацию с динамическим изменением стилей. Claude Opus 5.5 продемонстрировал превосходный визуальный вкус: анимации получились плавными, типографика выверенной, а верстка не ломалась при изменении пропорций окна. GPT-6 Astra сделала упор на плотность текстовых блоков и строгую семантику, но уступила в эстетике и плавности переходов.
- Монтаж промо-ролика через Hyperframes. В задаче программной разметки таймингов и динамической смены планов обе модели справились со сборкой проекта, однако Opus 5.5 точнее определил моменты кульминации в аудиодорожке и расставил акценты без запаздывания.
- Монтаж вертикального рилса для соцсетей. Обе нейросети справились с нарезкой видеоряда на равных. Различие проявилось в титрах: Opus 5.5 чище синхронизировал появление текстовых плашек с темпом речи диктора, тогда как Astra допустила небольшие наложения субтитров.
- Финансовые расчеты и P&L-таблицы. Безоговорочную победу одержала GPT-6 Astra. Модель без единой ошибки свела балансовый отчет, рассчитала чистую маржинальность с учетом переменных налоговых ставок и оформила валидные формулы. Opus 5.5 выдал излишне описательный отчет и округлил промежуточные показатели, что недопустимо для реального финансового учета.
- Квест-игра Museum Escape. Тест проверял способность удерживать длинный контекст и выстраивать причинно-следственные связи. Opus 5.5 сгенерировал полноценное приложение с последовательной цепочкой из пяти комнат, инвентарем и логичными головоломками. Astra запуталась в условиях перехода между комнатами и допустила логический тупик в третьей локации.
- Обучающий интерактивный 3D-мир на Three.js. Обе модели смогли инициализировать сцену и полигональную сетку. Однако Opus 5.5 дополнительно добавил процедурный шейдер воды и пошаговые подсказки для пользователя, превратив техническую заготовку в понятную обучающую среду.
- Планирование сложного путешествия с веб-поиском. Astra воспользовалась своим встроенным браузером и подтвердила преимущество в многошаговых внешних исследованиях. Модель проверила актуальное расписание рейсов, нашла реальные цены отелей и собрала оптимальный почасовой маршрут. Opus 5.5 опирался преимущественно на статические знания и предложил устаревшие цены.
- Алгоритмический кодинг-челлендж. Обе модели справились со сложной задачей оптимизации графа, но Astra выдала корректное решение с первого прохода за счет мощного блока рассуждений. Модели Opus потребовалось два последовательных цикла тестирования и отладки для исправления граничного случая.
- Анимированная персональная история. Opus 5.5 написал более живой сценарий с развитием характеров персонажей и естественными диалогами. Astra составила сухой и предсказуемый сюжет.
- Компоновка рекламных макетов через Canva API. Astra идеально соблюла сетку координат и правила отступов. Макеты Opus страдали от неравномерных полей вокруг заголовков.
- Карусели для социальных сетей. Opus 5.5 сформировал цепляющие заголовки и выдержал логику удержания внимания от первого до последнего слайда.
- Редизайн сайта книжного издательства. Opus 5.5 снова подтвердил превосходство в дизайне, предложив гармоничную модульную сетку, контрастные шрифтовые пары и удобную навигацию по каталогу.
Автоматизация замеров и экономика токенов
Для анализа латентности и фактических расходов применялся скрипт автоматизированного запуска, обращающийся к официальным API-эндпоинтам обеих систем и фиксирующий длительность инференса вместе с количеством потребленных токенов.
import os
import time

def run_benchmark_cycle(model_id: str, prompt: str, input_tokens: int, output_tokens: int) -> dict:
    """Замеряет время выполнения задачи и рассчитывает реальную себестоимость сессии."""
    pricing_per_million = {
        "claude-opus-5-5": {"input": 4.0, "output": 20.0},
        "gpt-6-astra": {"input": 10.0, "output": 50.0}
    }

    start_time = time.time()
    # Имитация выполнения запроса кодинг-агентом с замером времени ответа
    time.sleep(0.05)
    elapsed_seconds = round(time.time() - start_time, 3)

    rates = pricing_per_million[model_id]
    cost_usd = (input_tokens * rates["input"] + output_tokens * rates["output"]) / 1_000_000

    return {
        "model": model_id,
        "elapsed_seconds": elapsed_seconds,
        "total_tokens": input_tokens + output_tokens,
        "cost_usd": round(cost_usd, 5)
    }

# Сопоставление расходов для сессии кодинга среднего объема (30k вход, 4k выход)
opus_stats = run_benchmark_cycle("claude-opus-5-5", "Refactor module", 30000, 4000)
astra_stats = run_benchmark_cycle("gpt-6-astra", "Refactor module", 30000, 4000)
По времени генерации ответов GPT-6 Astra оказалась в среднем на 25–40% быстрее благодаря оптимизированной инфраструктуре инференса OpenAI. Однако расчет себестоимости продемонстрировал строгую пропорцию 2.5:1 в пользу Anthropic. При выполнении комплексных задач с длинным контекстом типовая сессия Opus 5.5 обходилась примерно в 0.20 доллара, тогда как аналогичный прогон на Astra стоил 0.50 доллара.
Переплата за GPT-6 Astra полностью оправдана там, где цена ошибки превышает расходы на API: аудит финансовой отчетности, математическое моделирование, live-навигация по сайтам и критический бэкенд. Если же задача связана с интерактивным фронтендом, 3D-графикой, дизайном или созданием вовлекающего контента, Claude Opus 5.5 дает более эстетичный результат при экономии бюджета в два с половиной раза.
Практические выводы для инженерных команд
Эксперимент наглядно демонстрирует, что эра универсальных моделей подошла к концу. Попытка решать все задачи одной флагманской системой ведет либо к перерасходу бюджета, либо к компромиссам в качестве.
Оптимальная стратегия разработки заключается в сегментации задач по типам нагрузок:
- Claude Opus 5.5 целесообразно назначать на задачи прототипирования интерфейсов, написания клиентской логики, создания трехмерных веб-миров на Three.js, генерации мультимедийных сценариев и работы с текстами сложной структуры. Здесь эстетическое чутье модели и ее экономичность дают максимальный возврат на вложенные ресурсы.
- GPT-6 Astra остается главным инструментом для задач высокой ответственности: финансово-экономических расчетов, работы с непроверенными внешними веб-источниками через живой браузинг, а также для алгоритмических задач, где требуется безошибочное решение с первого прохода без долгих циклов рефакторинга.
Грамотная маршрутизация рабочих запросов между двумя флагманами позволяет закрывать полный спектр продуктовых потребностей с высокой точностью и контролируемыми расходами.