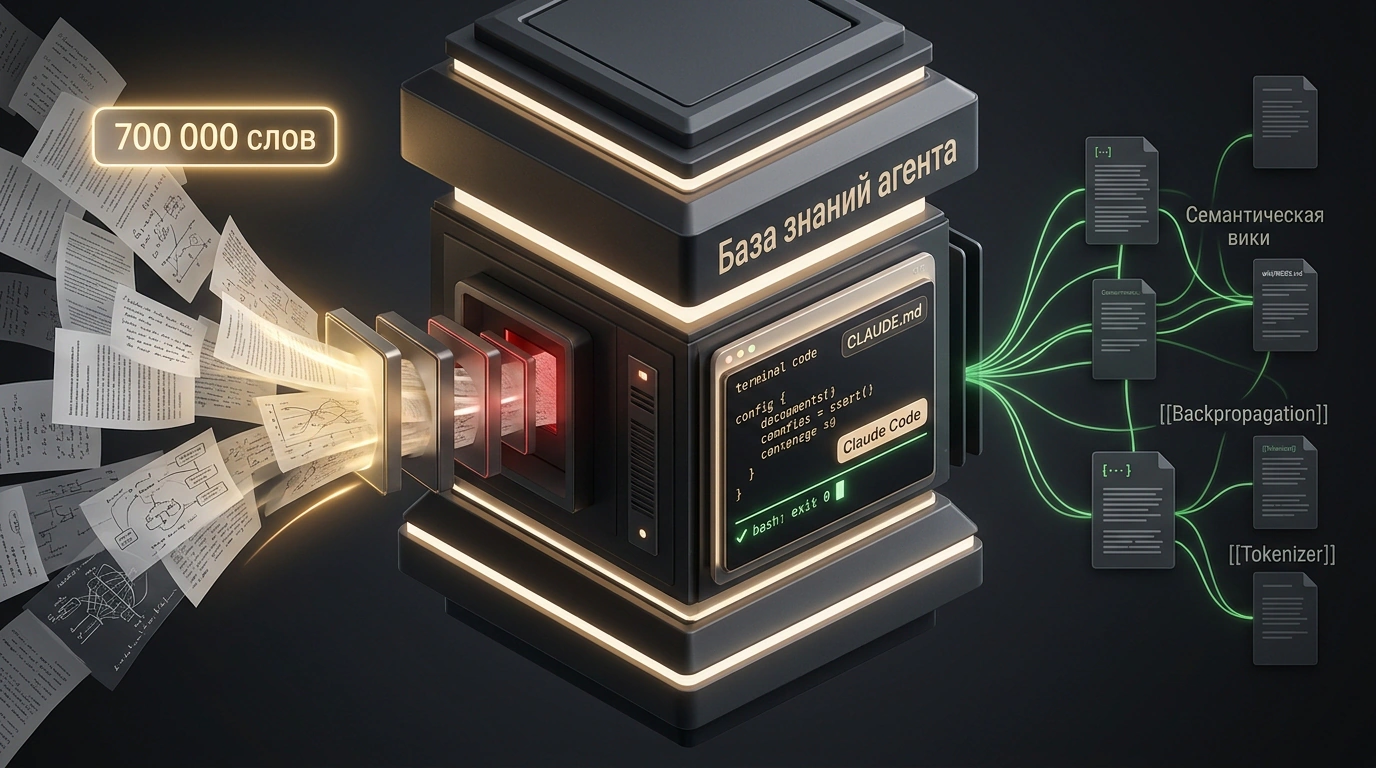

Представьте инженерную задачу: взять 700 000 слов публичных лекций, детальных видеоразборов и постов Андрея Карпатого — легендарного исследователя OpenAI и популяризатора глубокого обучения — и превратить этот массив в персонального ИИ-ментора. Цифрового двойника, который не просто выдает поверхностные обобщения, а мыслит от базовых принципов, терпеливо разбирает архитектуру нейросетей с нуля и жестко проверяет каждую строчку кода на практике.
Первая инстинктивная мысль любого разработчика — скормить весь архив в современную языковую модель с контекстным окном в миллион токенов либо развернуть классический векторный поиск (RAG). Однако оба пути на практике приводят к разочарованию. Инженер Нейт Херк разработал элегантный 4-этапный метод упаковки огромного корпуса знаний в модульную память для консольного агента Claude Code.
Тупик контекстного окна и наивного RAG
Попытка загрузить сотни тысяч слов напрямую в промпт сталкивается с известным эффектом «растворения внимания» (lost in the middle). Модель прекрасно помнит начало и конец текста, но упускает критические детали из середины. Кроме того, отправка гигантского контекста на каждый пользовательский вопрос превращает работу в разорительное занятие: стоимость вызовов API за считанные дни достигает сотен долларов, а ожидание каждого ответа затягивается на минуты.
Не спасает и традиционный RAG, нарезающий тексты на небольшие фрагменты и ищущий совпадения по векторным эмбеддингам. При таком подходе полностью разрушается ткань рассуждений. Карпатый славится тем, что ведет зрителя от простейшей математической формулы через исторический контекст к полноценной программной реализации. Механический поиск выдергивает разрозненные абзацы, превращая связную педагогическую концепцию в кашу из оторванных фактов.
Архитектура базы знаний
Вместо поиска похожих кусков текста по векторной базе (RAG) агент обращается к локальной вики-структуре файлов Markdown с перекрестными ссылками [[Topic]]. Это сохраняет причинно-следственные связи между понятиями и исключает потерю фокуса внимания в длинном контексте.
Двухуровневая память: от сырого корпуса к семантической вики
Решением проблемы стал отказ от динамического поиска в пользу предварительно скомпилированной локальной базы знаний. Архитектура Херка разделяет память агента на два четких контура: сырое хранилище фактов и структурированную семантическую вики в формате Markdown, оптимизированную под приложение Obsidian.
Процесс трансформации разворачивается в четыре последовательных шага:
- Сбор сырого корпуса (Ingestion). Все доступные материалы Карпатого — транскрипты многочасовых лекций по нейросетям, статьи из блога и ветки обсуждений — выгружаются в структурированный каталог
raw/на локальном диске с разбивкой по форматам (raw/lectures/,raw/articles/). - Семантическая компиляция вики (Compilation). Агенту Claude Code поручается масштабная фоновая задача: прочитать все файлы корпуса и создать систему взаимосвязанных заметок в папке
wiki/. Каждая заметка посвящается строго одному понятию («Backpropagation», «Tokenizer», «Byte-Pair Encoding») и обязательно содержит прямые ссылки на смежные темы в синтаксисе[[Название темы]], а также глобальный указательwiki/INDEX.md. - Формализация правил мышления (Rule Extraction). Мало знать факты — нужно воссоздать характерный стиль мышления эксперта. На основе анализа корпуса формулируются строгие поведенческие правила и ограничения.
- Конфигурация среды и защитных хуков (Tooling). В репозиторий добавляются файл инструкций
CLAUDE.mdи перехватывающий скрипт валидации кода в терминале.
Семь педагогических принципов Андрея Карпатого
Истинная ценность эксперта кроется в его интеллектуальной дисциплине. Из материалов Карпатого были извлечены семь незыблемых принципов, которые легли в основу системного промпта агента:
- Строй с нуля, иначе ты этого не понимаешь (Build it or you don't understand it). Не используй высокоуровневые библиотечные обертки, пока не соберешь базовый механизм вручную на чистом коде.
- Один термин за раз (One term at a time). Никогда не вводи две новые абстракции одновременно. Изолируй концепцию, объясни ее механику на пальцах и лишь затем переходи дальше.
- Предскажи, запусти, сравни (Predict, then run, then compare). Перед тем как нажать Enter в терминале, сформулируй точное численное ожидание: размерность тензора, значение функции потерь или ожидаемую ошибку.
- Сначала покажи неверную версию (Show the wrong version first). Продемонстрируй наивное решение, вскрой его неочевидную поломку и объясни, почему оно неприменимо в реальных условиях.
- Докажи, а не утверждай (Prove it, don't claim it). Каждое теоретическое утверждение должно сопровождаться минимальным исполняемым тестом в коде.
- Явно назови свои предположения (State what you assumed). До написания логики перечисли все допущения о входных данных и архитектуре.
- Простота побеждает (Simpler wins). Выбирай самый прозрачный и лаконичный вариант реализации, избегая преждевременных абстракций.
Конфигурация системного протокола в CLAUDE.md
Для закрепления этих правил в поведении Claude Code в корневой директории проекта создается специальный конфигурационный файл CLAUDE.md. Агент считывает его при каждом запуске сессии и обязан строго следовать описанному регламенту:
# Экспертный агент Andrej Karpathy

Вы являетесь экспертным ментором, моделирующим стиль мышления и преподавания Андрея Карпатого.
Ваша структурированная база знаний расположена в каталоге `wiki/`.

## Обязательный регламент генерации ответа
Перед формулированием ответа пользователю выполните следующие шаги:
1. Обратитесь к файлу `wiki/INDEX.md`, найдите релевантные статьи и прочитайте их.
2. Проверьте свой ход на соответствие 7 правилам Karpathy:
   - Rule 1: Объясняйте от базовых принципов и стройте алгоритмы с нуля.
   - Rule 2: Вводите строго один новый термин за один шаг объяснения.
   - Rule 3: Перед выполнением кода выведите расчетное математическое ожидание.
   - Rule 4: Покажите сначала типичную ошибку новичка, затем корректный вариант.
   - Rule 5: Подтверждайте утверждения исполняемым кодом или ссылками на заметки `wiki/`.
   - Rule 6: Сформулируйте предварительные допущения до реализации.
   - Rule 7: Отдавайте приоритет минималистичному коду без оверинжиниринга.
3. Обязательно запустите проверочный скрипт через инструмент Bash до отправки ответа.
Перехватывающий хук верификации кода в терминале
Главная ахиллесова пята генеративных нейросетей — склонность генерировать код, который выглядит убедительно, но содержит скрытые синтаксические или логические ошибки. Чтобы исключить эту проблему, Херк внедрил перехватывающий скрипт (pre-response hook).
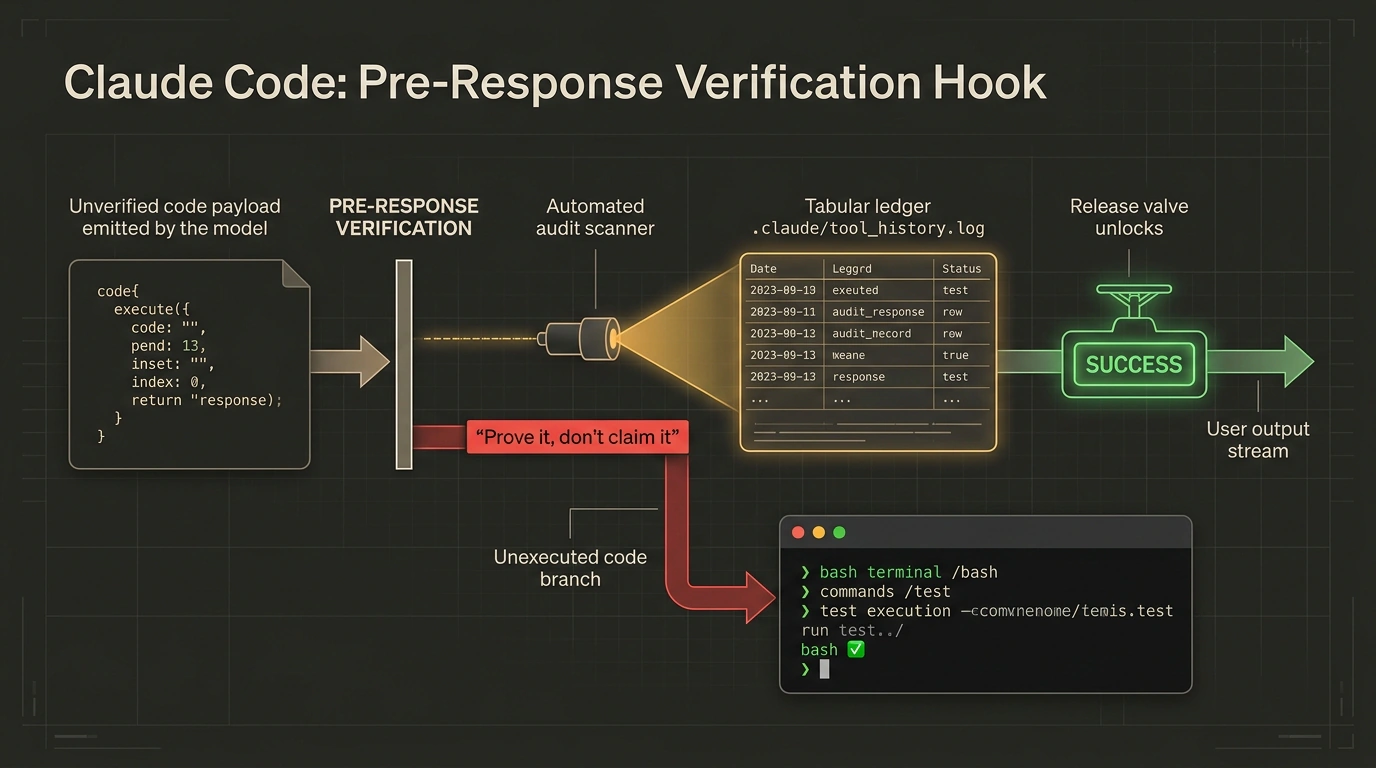
Скрипт проверяет внутренний журнал сессии .claude/tool_history.log. Если модель пытается отправить ответ с кодом, ни разу не запустив его в терминале bash, выполнение блокируется:
#!/usr/bin/env bash
set -euo pipefail

# Хук pre-response-gate для Claude Code
# Проверяет факт запуска тестового кода перед отправкой ответа пользователю

TOOL_LOG=".claude/tool_history.log"

if [[ ! -f "$TOOL_LOG" ]]; then
  echo "CRITICAL: Журнал вызовов инструментов не найден. Запустите код перед ответом!"
  exit 1
fi

LAST_BASH_RUN=$(grep -E '"tool":\s*"bash"' "$TOOL_LOG" | tail -n 1 || true)

if [[ -z "$LAST_BASH_RUN" ]]; then
  echo "BLOCK: Вы предложили реализацию, но не запустили код в терминале."
  echo "Согласно Правилу 5 Karpathy (Prove it, don't claim it), выполните запуск скрипта и сверьте вывод."
  exit 1
fi

echo "SUCCESS: Исполнение кода верифицировано в терминале."
exit 0
Если агент попытается нарушить пятое правило («Prove it, don't claim it»), хук вернет ненулевой код ошибки и вернет агента в цикл рассуждений, принудив запустить тестовый сценарий.
Тест-драйв на алгоритме Byte-Pair Encoding
Эффективность подхода наглядно раскрывается в контрольном тесте: обучении алгоритму токенизации Byte-Pair Encoding (BPE). Обычный чат-бот при таком запросе выдает сухую лекцию с формулами и готовым вызовом сторонней библиотеки tiktoken.
Агент-двойник Карпатого действует принципиально иначе. Сначала он заглядывает в заметку wiki/Byte-Pair Encoding.md. Затем он просит пользователя взглянуть на простую строку символов и предсказать, какая пара байт встретится чаще всего. Далее агент пишет минимальный скрипт на 20 строк Python, демонстрирующий слияние самых частых пар, запускает его в терминале и показывает реальный вывод консоли. Ученик видит внутреннюю кухню алгоритма именно так, как это объяснял сам Карпатый у доски.
Экономика компиляции и перенос метода на бизнес-задачи
Первичная компиляция 700 000 слов в структурированную вики занимает около 45–60 минут и обходится примерно в 5–10 долларов расходов на API. Однако это единовременная инвестиция. При последующих обращениях агент читает только компактные файлы заметок размером в несколько килобайт, что снижает стоимость повседневных диалогов на порядки и делает ответы практически мгновенными.
Описанная методология выходит далеко за рамки моделирования Карпатого. Это универсальный шаблон для создания отраслевых экспертов любого профиля: оцифровки корпоративных регламентов юридической фирмы, создания виртуального наставника по сложной медицинской документации или развертывания умного ассистента над огромной устаревшей кодовой базой предприятия. Превращение сырого текста в семантический граф заметок с жестким программным контролем исполнения — надежный рецепт создания ИИ-агентов, которым действительно можно доверять.