
Долгое время в индустрии больших языковых моделей негласно действовало правило: если вам нужен настоящий интеллект первого эшелона, способный решать сложнейшие задачи репозиторного программирования и математических рассуждений, вы вынуждены обращаться к закрытым американским API. Европейские компании и независимые исследовательские лаборатории в основном довольствовались дообучением чужих открытых весов — преимущественно китайских архитектур вроде Qwen или DeepSeek. Французская компания Mistral AI решила сломать эту субординацию. Их новый релиз — флагманская мультимодальная модель Mistral Large 4, ласково названная разработчиками «le Chonk» («Толстяк»), — насчитывает один триллион параметров и обучена полностью с нуля на территории Европейского союза.
«Толстяк» спроектирован не просто как демонстрация мускулов европейской вычислительной инфраструктуры. Это прямой вызов закрытым монополиям, предлагающий сопоставимое качество логических выводов при сохранении открытых весов для исследовательских команд и корпоративных контуров.
Как устроена архитектура: смесь экспертов вместо монолитной глыбы
Один триллион параметров звучит устрашающе для любого инженера, представляющего счета за серверное оборудование. Если бы вся эта сеть активировалась целиком при обработке каждого слова, инференс превратился бы в непозволительно медленное и расточительное занятие. Чтобы обойти это физическое ограничение, инженеры Mistral использовали гранулярную разреженную смесь экспертов (Sparse Mixture-of-Experts, MoE).
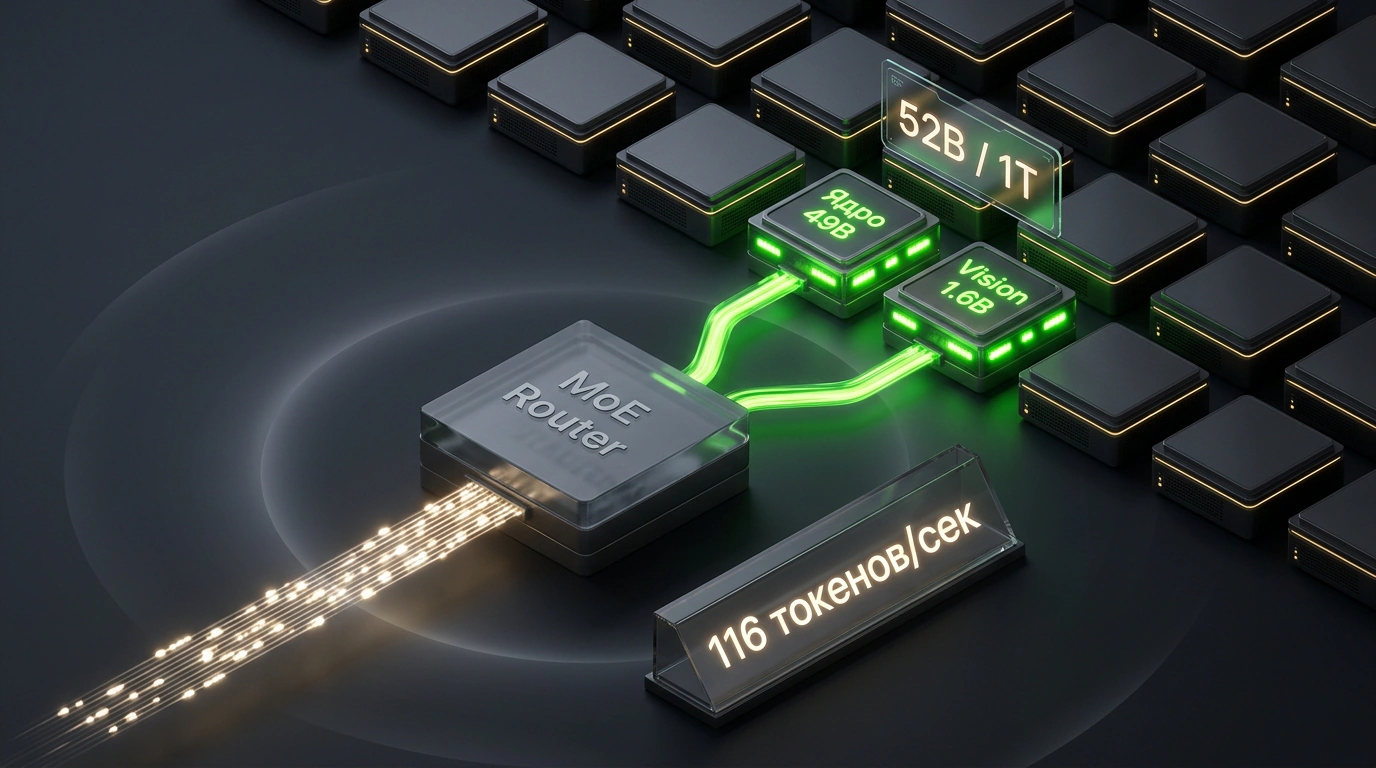
Принцип работы MoE можно сравнить с многопрофильным исследовательским госпиталем. Представьте медицинский центр, где работают сотни узких специалистов: кардиологи, неврологи, хирурги, фармакологи. Когда поступает конкретный пациент с болью в суставах, на консилиум не собирают всех врачей клиники — специальный диспетчер направляет запрос только двум-трем профильным докторам.
Внутри Le Chonk при общем «весе» в 1 триллион параметров на каждый поступающий токен активируется лишь около 52 миллиардов параметров (49 миллиардов языкового ядра плюс нативный мультимодальный энкодер на 1,6 миллиарда параметров). Благодаря такой динамической маршрутизации модель генерирует текст со скоростью до 116 токенов в секунду, не уступая по отзывчивости куда более компактным монолитным сетям. А встроенное визуальное зрение позволяет модели на лету считывать сложные технические чертежи, графики, интерфейсные макеты и многостраничные сканы документов без внешних прослоек оптического распознавания.
Европейский вычислительный суверенитет и обучение с нуля
Обучение архитектуры такого масштаба потребовало развертывания колоссальных вычислительных мощностей. Mistral развернула собственный европейский суперкомпьютерный кластер из 3800 графических процессоров NVIDIA Grace Blackwell. Все дата-центры физически расположены в Европе и функционируют в строгом соответствии с европейскими регламентами о защите данных (GDPR) и законом об искусственном интеллекте (EU AI Act).
Для корпоративного сектора и государственных институтов это меняет правила игры. До сих пор бизнес находился в постоянном напряжении: внезапное изменение политик американских технологических гигантов, отзыв ключей доступа или введение экспортных ограничений могли в любой момент парализовать критические внутренние процессы. Le Chonk возвращает технологическую автономию: архитектура обучена независимо, не содержит скрытых заимствований и полностью подконтрольна локальным юрисдикциям.
Инженерная зрелость: бенчмарки и честная кибербезопасность
В бенчмарках прикладной разработки программного обеспечения Le Chonk демонстрирует результаты, выводящие открытые европейские модели на совершенно новый уровень:
- Тест репозиторной разработки DeepSWE v1.1: модель успешно решает 61,7% реальных задач из открытых репозиториев (GitHub Issues), обгоняя открытые модели за пределами Китая.
- Терминальные операции Terminal-Bench 4: 28,3% точности в комплексных сценариях командной строки Linux, где требуется последовательный запуск утилит, анализ логов и сборка пакетов.
- Анализ кодовой базы SWE-Atlas-QnA: 59,4% верных ответов при исследовании связей и зависимостей в незнакомых программных проектах.
- Бизнес-автоматизация AutomationBench: 59,9% завершенных сквозных сценариев в офисных приложениях (Google Workspace, CRM-системы, корпоративные мессенджеры).
Особенно примечателен индекс кибербезопасности Artificial Analysis Cyber Index, где Le Chonk вошла в пятерку сильнейших мировых систем. В отличие от закрытых флагманов вроде Claude Opus 5.5 или GPT-6 Astra, страдающих чрезмерными ограничениями безопасности и отказывающихся анализировать вредоносный код или проводить аудит уязвимостей, Mistral сделала ставку на профессиональное применение. Модель не блокирует запросы белых хакеров и специалистов по безопасности, позволяя находить ошибки переполнения буфера, уязвимости use-after-free и автоматически конструировать защитные патчи.
Практическое развертывание: запуск и управление рассуждениями
Публичный превью-доступ к Le Chonk открыт в Mistral Studio API по цене $1,36 за миллион входных токенов и $4,18 за миллион выходных токенов. Публикация открытых весов намечена на конец октября 2026 года. Однако подготовить серверную инфраструктуру к локальному инференсу можно уже сейчас.
Для запуска триллионной модели с квантованием FP8 требуется узел с распределенным тензорным параллелизмом на 8 графических процессорах уровня NVIDIA H100 или B200. Минимальный запуск инференс-сервера через оптимизированный движок vLLM выглядит следующим образом:
# Развертывание сервера vLLM с распределением весов на 8 GPU и квантованием FP8
python3 -m vllm.entrypoints.openai.api_server \
  --model mistralai/Mistral-Large-4-Preview \
  --tensor-parallel-size 8 \
  --quantization fp8 \
  --max-model-len 65536 \
  --gpu-memory-utilization 0.92 \
  --trust-remote-code \
  --port 8000
Когда сервер инициализирован и веса распределены по видеокартам, клиентский скрипт отправляет запросы на глубокий анализ кода. При работе с агентными средами инженеры обязательно ограничивают параметр max_tokens и контролируют цепочки промежуточных рассуждений, чтобы модель не тратила лишний контекст на избыточные самокопания.
import os
from openai import OpenAI

# Инициализация клиента для локального узла Mistral Le Chonk
client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local-token-auth"
)

# Формирование задачи на аудит уязвимости и генерацию защитного патча
system_instruction = (
    "Ты ведущий инженер по информационной безопасности. "
    "Проанализируй фрагмент кода, выяви уязвимости работы с памятью и напиши минимальный патч."
)

source_snippet = """
char *read_config(FILE *f) {
    char *buf = malloc(256);
    if (!buf) return NULL;
    fgets(buf, 256, f);
    if (buf[0] == '#') { free(buf); }
    return buf; // Потенциальный use-after-free / dangling pointer
}
"""

response = client.chat.completions.create(
    model="mistralai/Mistral-Large-4-Preview",
    messages=[
        {"role": "system", "content": system_instruction},
        {"role": "user", "content": f"Найди дефект и исправь:\n{source_snippet}"}
    ],
    temperature=0.1,
    max_tokens=1500
)

print("Анализ и патч от Mistral Le Chonk:\n")
print(response.choices[0].message.content)
В этом примере модель точно определяет возврат освобожденного указателя и генерирует корректный вариант обнуления ссылки перед выходом из функции, не прерывая сессию предупреждениями об опасном коде.
Аппаратные аппетиты и компромиссы архитектуры
Несмотря на впечатляющую скорость MoE-маршрутизации, Le Chonk остается колоссальной нейросетью. Полный массив весов в несжатом представлении FP16 требует более двух терабайт быстрой видеопамяти. Даже при использовании 8-битного квантования FP8 для локального инференса необходима серверная стойка стоимостью в сотни тысяч долларов. Для запуска на одиночных рабочих станциях инженерам придется дождаться агрессивного квантования до 3–4 бит от сообщества, что неизбежно срежет часть тонких математических способностей модели.
Вторым компромиссом выступает размер контекстного окна: 512 000 токенов (500K). Для подавляющего большинства прикладных задач этого более чем достаточно — в такое окно свободно помещается несколько сотен файлов исходного кода или пара увесистых томов документации. Однако флагманские конкуренты вроде Claude Opus 5.5 и GLM 5.3 уже предлагают стандарт в один миллион токенов, что дает им преимущество при пакетном анализе огромных репозиториев за один проход.
Место в индустрии и практический вывод
Появление Mistral Le Chonk доказывает: эра абсолютной монополии закрытых API на высший уровень машинного интеллекта подходит к концу. Европа показала, что способна создавать суверенные открытые супермодели первого эшелона без оглядки на чужие веса и лицензии. Для бизнеса и инженеров это сигнал: пора тестировать превью-интерфейсы в Mistral Studio, рассчитывать емкость серверных стоек и готовиться к выгрузке открытых весов в конце октября. Открытый триллион параметров уже реальность, и он работает на удивление быстро.