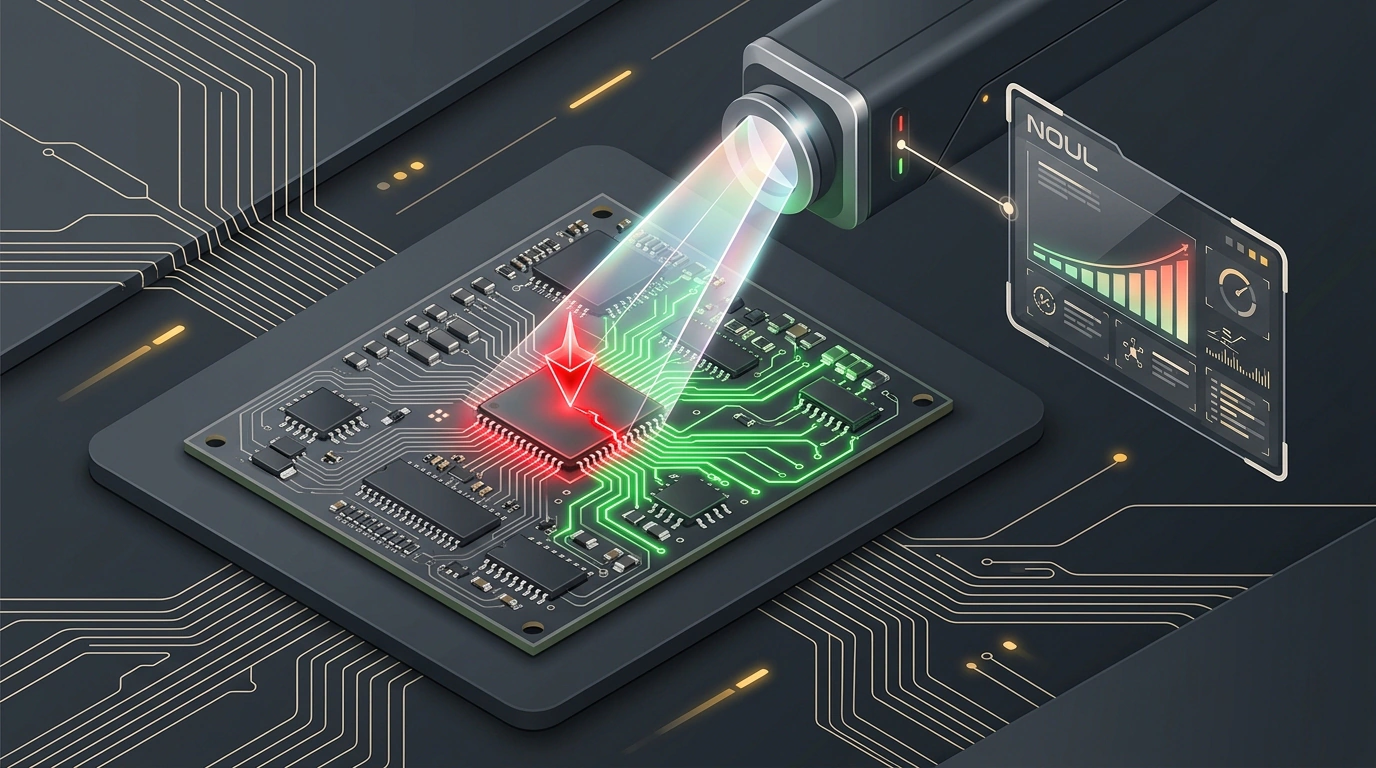

Когда перед инженерами встает задача проверить качество пайки на конвейере или определить подлинность чека в мобильном приложении, стандартным решением часто становится вызов тяжелой мультимодальной нейросети. Однако этот подход содержит архитектурный изъян: чтобы ответить на простой вопрос «есть ли здесь дефект», авторегрессионная языковая модель вынуждена генерировать текстовые токены рассуждений, тратя секунды драгоценного времени и раздувая расходы на инфраструктуру.
Стартап Liquid AI предложил альтернативу, выпустив семейство моделей d1 и его мультимодальную версию d1 Vision (включающую открытую весовую категорию d1-3b на Hugging Face). Это специализированные модели принятия решений (decision models), которые анализируют изображения и текст за один прямой проход (single forward pass), полностью отказываясь от генерации выходных токенов.
Зачем заставлять нейросеть писать эссе ради одного ответа
В обычных мультимодальных системах каждое изображение кодируется сотнями визуальных токенов, после чего генератор начинает медленно выводить буквы. Liquid AI d1 Vision устроена иначе: на выходе трансформерного блока расположен вероятностный классификатор (probability head). Сеть не сочиняет предложения, а сразу выдает калиброванное распределение вероятностей по заданным гипотезам.
Такой подход дает колоссальный выигрыш в скорости и экономике:
- Задержка инференса: 8–16 миллисекунд на одном ускорителе против 1500–4000 мс у авторегрессионных мультимодальных LLM;
- Нулевая стоимость генерации: тарифицируются только входные данные, что делает вызов в 200 раз дешевле;
- Идеальная стабильность: модель физически не может «забыть закрыть JSON-скобку» или выдать неструктурированную реплику.
В серии тестов из шести прикладных производственных сценариев (отбраковка плат с дефектами пайки, сортировка сканов документов и клиентских тикетов с фото чеков) d1 Vision превзошла флагманскую GPT-6.1 Sol в четырех тестах из шести.
Первичная проверка дефектов через REST API
Для контроля качества на производстве достаточно передать растровое изображение и вопрос в бинарном режиме noul:
import requests

api_url = "https://api.liquid.ai/v1/decisions"
headers = {"Authorization": "Bearer YOUR_LIQUID_API_KEY"}

# Отправка фотографии микросхемы на экспресс-инспекцию
with open("circuit_board.jpg", "rb") as image_file:
    payload = {
        "question": "Is there a short-circuit soldering bridge between the pins?",
        "primitive": "noul",
        "confidence_threshold": 0.90
    }
    response = requests.post(
        api_url,
        headers=headers,
        files={"image": image_file},
        data=payload
    )

result = response.json()
print(f"Дефект обнаружен: {result['decision']}, вероятность: {result['probability']:.3f}, время: {result['latency_ms']} мс")
Категоризация и маршрутизация инцидентов
Если первичный фильтр подтвердил наличие аномалии, второй вызов классифицирует конкретный тип дефекта по списку категорий через примитив choice:
# Уточняющая классификация обнаруженного брака
with open("circuit_board.jpg", "rb") as image_file:
    category_payload = {
        "question": "Identify the primary manufacturing defect type",
        "options": ["solder_bridge", "missing_component", "misaligned_chip", "contamination"],
        "primitive": "choice"
    }
    cat_response = requests.post(
        api_url,
        headers=headers,
        files={"image": image_file},
        data=category_payload
    ).json()

print(f"Классификация брака: {cat_response['result']}")
print(f"Распределение вероятностей: {cat_response['distribution']}")
Ограничения архитектуры и сфера применения
Узкая специализация определяет и границы применимости d1 Vision: она не предназначена для открытого диалога, составления отчетов или творческого редактирования картинок. Список проверяемых вариантов должен быть четким и взаимоисключающим.
Тем не менее для систем компьютерного зрения, систем модерации контента и edge-устройств появление бестокеновых мультимодальных моделей знаменует смену парадигмы. Перенос рутинной классификации на специализированные decision models позволяет сократить аппаратные расходы на два порядка без потери точности.