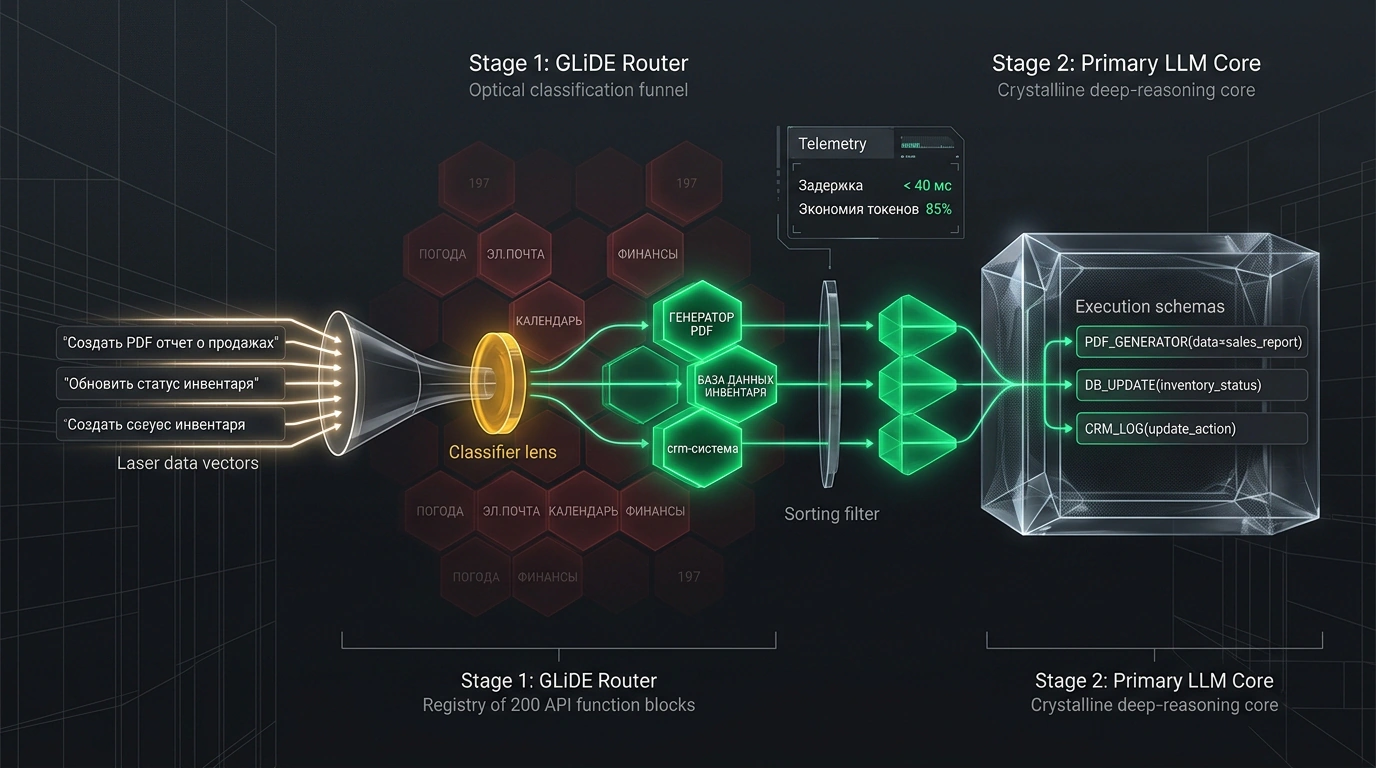

По мере того как автономные ИИ-агенты выходят за рамки демонстрационных скриптов и интегрируются в корпоративную инфраструктуру, инженеры сталкиваются с феноменом, получившим название «деградация контекста инструментов» (Tool Context Starvation). Представьте корпоративного агента службы поддержки: ему доступны функции проверки баланса клиента, отмены заказа, формирования накладных, запроса выписок из банка, отправки SMS и еще 250 различных эндпоинтов микросервисов компании.
Если передать описания всех двухсот инструментов в системный промпт флагманской языковой модели вроде GPT-4o или Claude Sonnet на каждом шаге диалога, система моментально сталкивается с тремя барьерами: задержка ответа подскакивает до 4–6 секунд, расходы на токены растут в геометрической прогрессии, а вероятность галлюцинации параметров и ложного вызова неподходящей функции возрастает на порядок.
Решением этой архитектурной проблемы стала модель принятия решений GLiDE (Graph & Language-integrated Decision Engine). Это легковесная специализированная нейросеть, выполняющая роль высокоскоростного диспетчера перед основной языковой моделью.
Двухэтапная маршрутизация вызова функций
Вместо того чтобы заставлять тяжелую модель перебирать весь каталог API компании, архитектура GLiDE разделяет процесс принятия решений на два независимых этапа:
- Семантический отбор инструментов (Decision Routing): входящий запрос пользователя сначала поступает в модель GLiDE. Модель за 20–40 миллисекунд анализирует намерение пользователя и сопоставляет его с графом зависимостей зарегистрированных инструментов. На выходе формируется компактный список из 2–4 наиболее релевантных функций.
- Точное заполнение параметров и исполнение (Execution): основная рассуждающая LLM получает только отфильтрованные схемы отобранных инструментов. Имея перед глазами чистый контекст, модель безошибочно генерирует валидные аргументы для вызова API.
В бенчмарках на больших каталогах корпоративных сервисов такой подход позволяет снизить объем входных токенов на 80%, сократить общую задержку агентного цикла более чем в три раза и повысить точность корректного вызова инструментов (Tool Calling Accuracy) на 16%.
Реализация клиентского шлюза GLiDE на Python
Рассмотрим программную реализацию шлюза маршрутизации на Python. В первом блоке кода мы создаем класс роутера GLiDEToolRouter, который отправляет намерение пользователя в локальный сервис принятия решений и фильтрует массив инструментов:
from typing import List, Dict, Any
import requests

class GLiDEToolRouter:
    """Шлюз быстрой фильтрации инструментов перед вызовом основной LLM."""
    def __init__(self, endpoint_url: str, confidence_threshold: float = 0.82):
        self.endpoint = endpoint_url
        self.threshold = confidence_threshold

    def filter_relevant_tools(self, user_prompt: str, catalogue: List[Dict[str, Any]]) -> List[Dict[str, Any]]:
        """Отбор топ-3 релевантных инструментов через легковесный эндпоинт."""
        # Передаем только легкие метаданные (имя и краткое описание)
        payload = {
            "query": user_prompt,
            "candidates": [{"id": t["name"], "description": t["description"]} for t in catalogue],
            "top_k": 3
        }

        try:
            response = requests.post(f"{self.endpoint}/v1/route", json=payload, timeout=0.25)
            response.raise_for_status()
            decision_data = response.json()
        except requests.RequestException as e:
            # Защитный fallback: при недоступности роутера возвращаем базовый набор
            print(f"Ошибка роутинга GLiDE: {e}. Используется дефолтный профиль инструментов.")
            return catalogue[:5]

        # Фильтрация по порогу уверенности модели решений
        allowed_ids = {
            item["id"] for item in decision_data.get("matches", [])
            if item["score"] >= self.threshold
        }

        return [tool for tool in catalogue if tool["name"] in allowed_ids]
Теперь интегрируем наш роутер в цикл выполнения агента. Представьте, что в пуле системы зарегистрировано 200 инструментов, а пользователь просит выставить закрывающий акт:
# Моделируем большой корпоративный пул инструментов (200 функций)
enterprise_tools_pool = [
    {"name": f"system_util_{i}", "description": f"Вспомогательная утилита номер {i}", "parameters": {}}
    for i in range(200)
]
# Добавляем целевую бухгалтерскую функцию
enterprise_tools_pool.append({
    "name": "generate_closing_invoice",
    "description": "Формирование бухгалтерского акта выполненных работ и счета-фактуры в PDF",
    "parameters": {
        "type": "object",
        "properties": {
            "customer_id": {"type": "string", "description": "ИНН или номер договора клиента"},
            "reporting_period": {"type": "string", "description": "Отчетный период в формате YYYY-MM"}
        },
        "required": ["customer_id", "reporting_period"]
    }
})

# Инициализация роутера и фильтрация под конкретный запрос
router = GLiDEToolRouter("http://localhost:8080")
user_query = "Сформируй закрывающий акт за сентябрь для клиента ИНН 7701234567"

# Отбираем только необходимые схемы
selected_tools = router.filter_relevant_tools(user_query, enterprise_tools_pool)
print(f"Из 201 инструмента отобрано: {[t['name'] for t in selected_tools]}")

# Теперь передаем в тяжелую LLM только selected_tools вместо гигантского пула
# llm_client.chat.completions.create(model="gpt-4o", tools=selected_tools, messages=[...])
Благодаря предварительной фильтрации основная модель получает компактный запрос, лишенный сотен ненужных параметров. Это практически исключает галлюцинации и гарантирует быстрое выполнение задачи.
Границы применимости и компромиссы
При внедрении GLiDE важно учитывать особенности архитектуры. Если запрос пользователя охватывает сразу несколько несвязанных доменов (например: «Выстави счет клиенту и сразу создай задачу в Jira на закупку серверов»), слишком жесткий порог уверенности (confidence_threshold) может отсечь второстепенную, но необходимую функцию. В таких сценариях порог снижают либо настраивают итеративный добор инструментов в цикле агента.
Для подавляющего большинства корпоративных агентов вынесение логики принятия решений в специализированный фильтр вроде GLiDE является обязательным шагом для перехода от нестабильных прототипов к надежному и экономически оправданному продакшену.