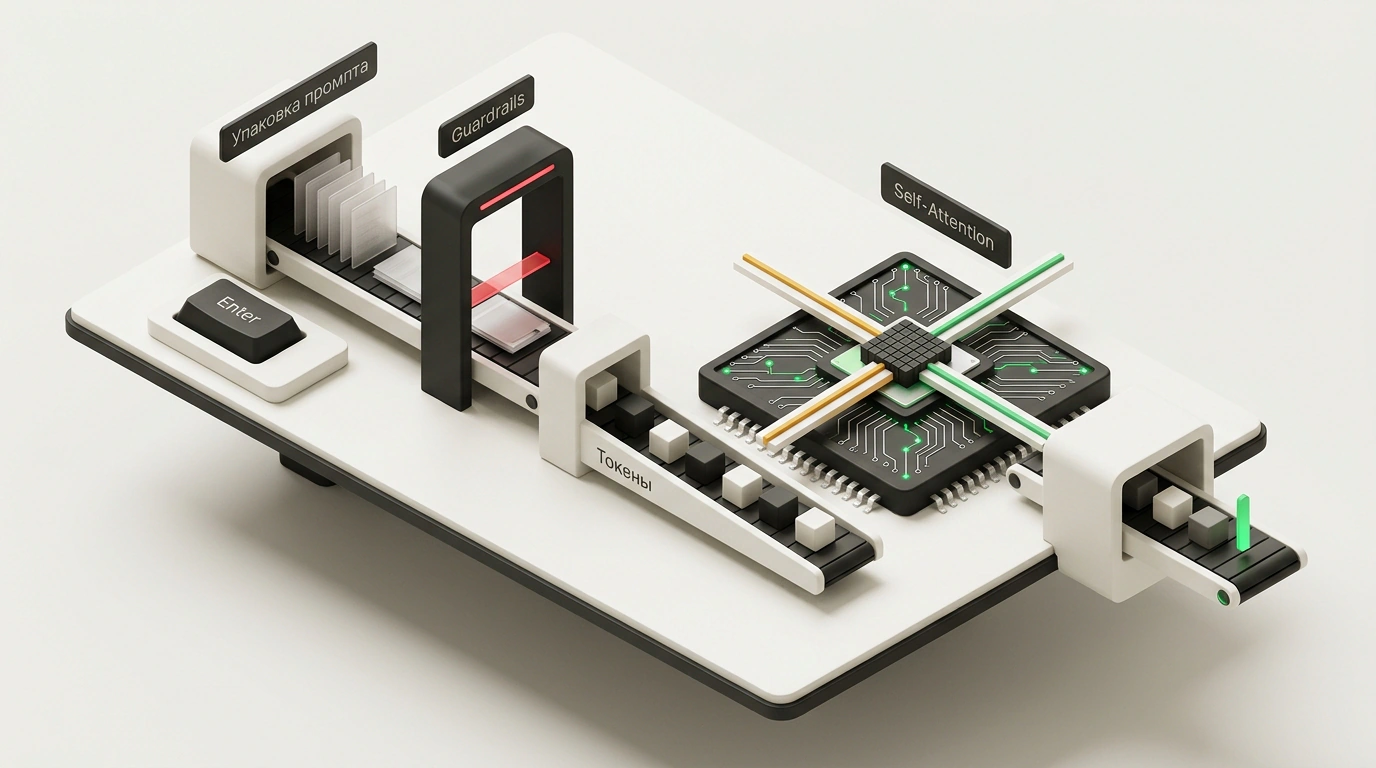

Представь привычную картину: ты открываешь браузер, вбиваешь в строку ввода ChatGPT простой вопрос — например, «Объясни, почему небо голубое», — нажимаешь клавишу Enter и через пару секунд наблюдаешь, как курсор бодро выводит ровные строчки текста.
В массовом сознании этот процесс окутан туманом научной фантастики. Людям кажется, что где-то в темном серверном шкафу сидит сверхразумный цифровой мозг, который прочитал весь интернет, «подумал» над твоим вопросом и выдал мудрое экспертное суждение.
Давай снимем этот глянец и включим инженерный рентген. За те полторы секунды, пока моргает курсор, твой запрос совершает сложнейшее путешествие через десяток независимых программных и аппаратных систем. Исследователь Ник Сараев провел наглядную декомпозицию этого пути, и сегодня я предлагаю тебе разобрать этот механизм буквально по винтикам: от невидимых метаданных в твоем браузере до перемножения матриц на кремниевых кристаллах в дата-центре.
Слой 1: Невидимый чемодан — упаковка контекста в клиенте
Первая иллюзия, с которой пора расстаться: модель никогда не получает твой запрос в чистом виде. Когда ты отправляешь фразу из пяти слов, клиентское приложение формирует увесистый скрытый пакет — так называемый Prompt Packing.
В этот цифровой «чемодан» упаковывается колоссальный объем служебной информации:
- Системный промпт (System Instructions): базовые директивы разработчиков, определяющие характер модели, тон речи, форматирование и запреты. У передовых систем вроде Claude от Anthropic объем этого невидимого текста превышает 3000 слов!
- Временные и географические метки: точная дата запроса, день недели, часовой пояс пользователя и приблизительная локация, чтобы модель понимала, какой сейчас год и какое время суток на дворе.
- Долговременная память: блок сохраненных фактов о тебе (твоя профессия, стек технологий, любимый стиль ответов). О том, как эффективно управлять этим слоем памяти на практике, мы подробно разбирали в руководстве по ChatGPT Work.
- История предыдущей переписки: вся текущая ветка диалога со всеми прошлыми вопросами и ответами, аккуратно размеченная служебными тегами ролей (
system,user,assistant).
В итоге твои пять невинных слов превращаются в многостраничный технический документ еще до того, как пакет покинет сетевую карту твоего ноутбука.
Слой 2: Церберы у входа — пре-классификаторы безопасности
Прежде чем пустить тяжелый запрос к вычислительному сердцу системы, облачная инфраструктура обязана убедиться, что ты не пытаешься ее взломать. Запрос попадает на рубеж Guardrails — легковесных классификаторов безопасности.
Зачем городить отдельный барьер? Дело в чистой экономике. Прогонять каждый входящий текст через флагманскую модель стоимостью в десятки центов слишком расточительно. Вместо этого на входе стоят миниатюрные специализированные модели, обученные на одну узкую задачу: мгновенно детектировать вредоносные интенты (джейлбрейки, попытки выведать закрытые системные инструкции, запросы на синтез токсичных веществ или вредоносного ПО).
У Anthropic внедрение таких пред-классификаторов позволило сократить успешность атак на систему с 90% до скромных 4–5%, при этом фильтры расходуют менее 1% от общего вычислительного бюджета сессии. Если guardrail-модель чует неладное, запрос либо немедленно блокируется стандартной заглушкой, либо мягко перенаправляется на ультраконсервативную ветку с повышенной строгостью модерации.
Слой 3: Мясорубка смыслов — токенизация и ее подвохи
Если проверка безопасности пройдена, наступает этап токенизации. Это один из самых контринтуитивных моментов для новичков: нейросети физически не умеют читать буквы, слоги или слова. Для кремниевого процессора буквы — пустой звук. Компьютер понимает только числа.
Специальный алгоритм (например, Byte-Pair Encoding со словарем примерно на 200 000 токенов у современных моделей OpenAI) нарезает сплошной текст на кусочки — токены, каждому из которых присвоен уникальный целочисленный идентификатор.
В английском языке один токен в среднем покрывает около 4 символов (примерно 70% типичного слова). Но с кириллицей, математическими формулами и редкими терминами начинаются интересные аномалии. И именно здесь кроются разгадки двух главных «детских болезней» искусственного интеллекта:
- Почему ИИ не может посчитать буквы в слове? Вспомни знаменитый мем про слово strawberry («клубника»), в котором модели упорно не могли найти три буквы «r». Дело в том, что токенизатор разрезает это слово на три готовых числовых блока:
st(токен 499),raw(токен 4492) иberry(токен 9467). Модель видит последовательность трех чисел, но понятия не имеет, из каких отдельных букв они состоят внутри! - Почему языковые модели хромают в арифметике? Числа нарезаются токенизатором хаотично, в зависимости от того, как часто они встречались в обучающей выборке. Число
1984может быть одним токеном, а соседнее19845будет разрублено на198и45. Для модели это не числа на числовой прямой, а абстрактные символы, поэтому перемножение в столбик превращается в мучительную угадайку.
Слой 4: Кластерный батчинг и кремний дата-центра
Превратившись в плотный массив чисел, запрос по трансконтинентальным оптоволоконным магистралям прилетает в дата-центр. Там его встречают не персональные компьютеры, а монструозные серверные стойки, укомплектованные графическими ускорителями NVIDIA H100 или B200, связанными сверхскоростными шинами NVLink.
И здесь инженеры сталкиваются с суровой физикой: графическому процессору категорически невыгодно обрабатывать твой запрос в гордом одиночестве. Если гонять матрицы весов ради одного пользователя, 95% вычислительных ядер чипа будут банально простаивать в ожидании выборки данных из памяти.
Чтобы загрузить кремний на 100%, серверный диспетчер (использующий фреймворки вроде vLLM или TensorRT-LLM) объединяет запросы сотен разных пользователей в один общий параллельный пакет — батч (Batch). Твой вопрос про кота, чей-то скрипт на Python и перевод кулинарного рецепта склеиваются в единый гигантский тензор и одновременно прокачиваются через вычислительные блоки GPU.
Чтобы миллиарды параметров современной модели физически поместились в быструю видеопамять, веса подвергают квантованию: числовые значения переводят из тяжелого 16-битного формата с плавающей запятой (FP16) в компактные 8-битные (FP8) или даже 4-битные (INT4) форматы с ювелирной калибровкой, исключающей деградацию логики.
Слой 5: Механизм Self-Attention — как вычисляется смысл
Теперь мы подошли к главному технологическому триумфу XXI века — архитектуре Transformer, предложенной исследователями Google в эпохальной статье 2017 года «Attention Is All You Need» (Vaswani et al.).
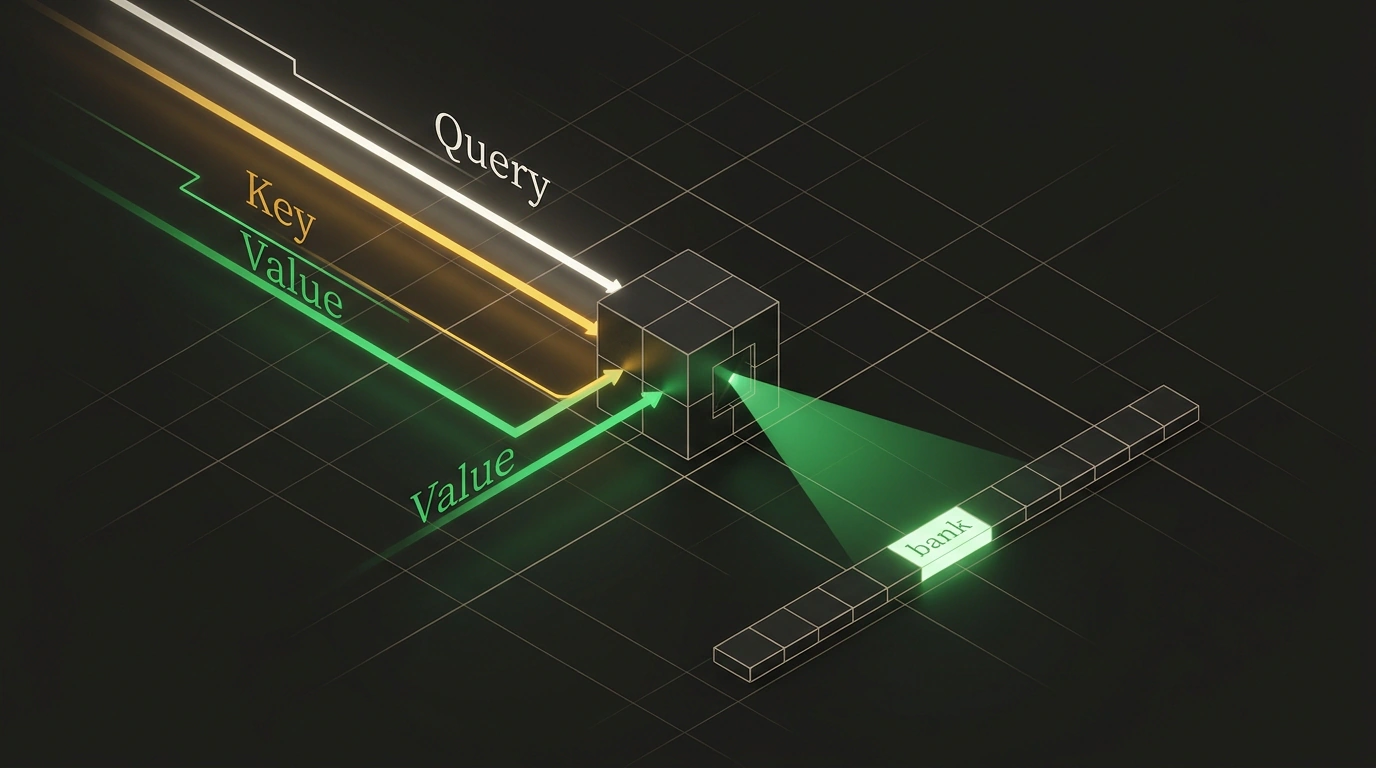
Каждый слой трансформера выполняет фундаментальную операцию: механизм внутреннего внимания (Self-Attention). Для каждого токена создаются три вектора:
- Query (Запрос): «Что я ищу в этом контексте?»
- Key (Ключ): «Какой смысл я несу другим словам?»
- Value (Значение): «Какую смысловую информацию я передам дальше?»
Давай разберем это на классической бытовой аналогии. Представь английское слово bank. Что оно означает: насыпь у реки (river bank) или финансовое учреждение, выдающее кредиты (bank loan)?
Когда слово bank оказывается в предложении, его вектор Query перемножается с векторами Key всех остальных слов в тексте. Если рядом оказывается слово river или water, их математическое скалярное произведение резко возрастает — между ними возникает высокий коэффициент внимания. Слово bank впитывает векторные свойства реки. Если же рядом стоит слово deposit или money, вектор внимания перетягивает смысл в сторону финансов. Именно так, без единого грамма человеческого сознания, через чистое матричное перемножение алгоритм кристально точно понимает контекст каждого слова.
Слой 6: Авторегрессионное рождение ответа и спасительный KV-кэш
После прохождения десятков слоев внимания модель выходит на финальный слой. И здесь кроется фундаментальный принцип работы современных LLM: модель никогда не знает финал своего предложения. Она работает строго авторегрессионно — то есть предсказывает ровно один следующий токен!
На выходе получается гигантский массив вероятностей для всех 200 000 токенов словаря (логиты, пропущенные через функцию Softmax). Алгоритм сэмплирования выбирает одно наиболее статистически уместное слово (или кусок слова) и выводит его на экран.
Но что происходит дальше? Чтобы сгенерировать второй токен, модель обязана прогнать через себя весь исходный запрос плюс свежесгенерированный первый токен! Для третьего токена процедура повторяется заново.
Если бы инженеры делали это «в лоб», время генерации росло бы в геометрической прогрессии, а серверы моментально бы расплавились. Спасением стал механизм KV-кэширования (Key-Value Cache). Все вычисленные векторы ключей и значений для предыдущих слов заботливо сохраняются в сверхбыстрой памяти HBM3e на графическом чипе. При каждом новом шаге модель считает внимание только для одного нового токена, обращаясь к уже готовому кэшу прошлого контекста.
Слой 7: Развилка решений — точка останова или вызов инструмента
Каждый раз, сгенерировав очередной токен, модель оценивает развилку служебных инструкций:
- Токен конца текста (
<end_of_text>): алгоритм понимает, что мысль завершена, авторегрессионный цикл разрывается, и соединение с клиентом закрывается. - Токены скрытого рассуждения (Chain-of-Thought): в reasoning-моделях (семейства OpenAI o1 или Gemini 4 Argon) токен может принадлежать к блоку скрытых размышлений. Модель продолжает диалог сама с собой во внутреннем монологе, проверяя гипотезы, и не выводит этот текст пользователю до финализации ответа.
- Токен вызова инструмента (Tool Call): если модели для ответа требуются свежие котировки акций или запуск калькулятора, она генерирует специальный управляющий токен. В этот момент генерация текста замирает. Модель выплевывает структурированный JSON с названием функции и аргументами. Внешний рантайм подхватывает этот JSON, делает реальный HTTP-запрос к внешнему API или запускает Python-код в песочнице, забирает результат и подмешивает его обратно в контекст как новое сообщение от роли
tool. После этого генерация возобновляется.
Часто можно услышать возмущенное: «Нейросеть мне нагло соврала!». Понимание конвейера объясняет природу этого явления. Модель физически не способна «врать», потому что у нее нет концепции правды или лжи. Внутри трансформера происходит постоянный выбор статистически наиболее вероятного продолжения текстового распределения. Если в обучающей выборке или переданном контексте нет точных данных, модель не замолкает в смущении — она берет математически ближайший вектор, рождая убедительную, но вымышленную галлюцинацию.
В следующий раз, когда ты нажмешь Enter в строке ввода, вспомни эту грандиозную кремниевую симфонию. За пару секунд твой вопрос успел обрасти системным контекстом, пройти сквозь фильтры безопасности, распасться на числовые токены, объединиться в пакет с тысячами чужих мыслей, прокачаться сквозь терабайты матриц внимания и по крупицам собраться обратно в понятные человеческие фразы. Это не магия — это триумф прикладной инженерной мысли.