

Когда в технологических соцсетях заходит речь об автономных ИИ-агентах в разработке, разговор обычно быстро скатывается к двум крайностям. С одной стороны — восторженные фаундеры с хакатонов, обещающие уволить всех программистов к следующему понедельнику. С другой — уставшие сеньоры, которые пробовали скормить агенту легаси-код и получили взамен сломанные тесты и пачку выдуманных библиотек.
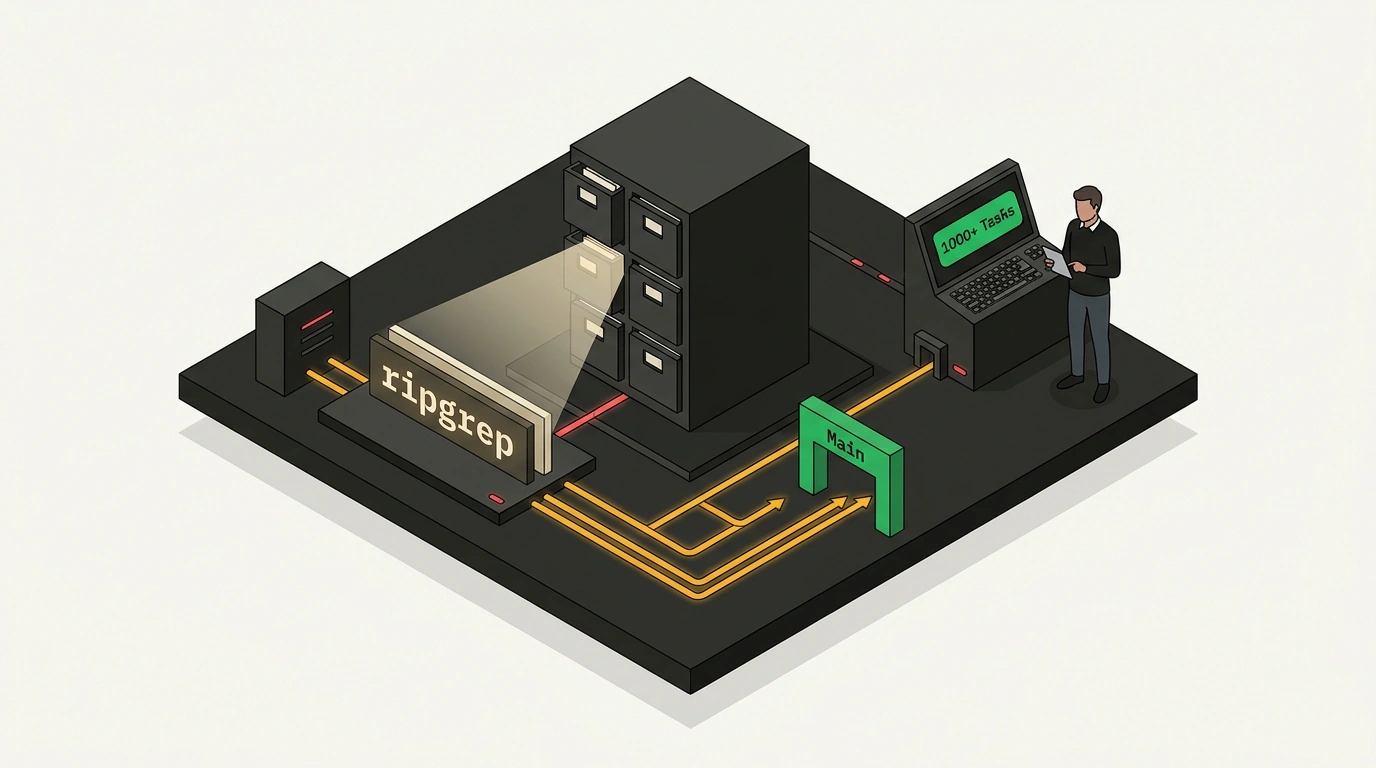
Тем интереснее смотреть на реальные производственные цифры крупного enterprise-сектора. На московской конференции AI Native Conf соруководитель бизнес-направления в Райффайзенбанке Андрей Усенко представил опыт сквозной трансформации инженерных процессов. Главный итог зафиксировал архитектор Алексей Рыбак: с августа 2026 года команда закрыла более 1000 производственных задач без единого ручного коммита от человека.
Смотри, что здесь самое поучительное: реальная архитектура работающего конвейера полностью перечеркнула популярные хайповые стереотипы.
Одинокий агент против зоопарка ролей
Если ты следил за фреймворками вроде CrewAI или LangGraph, то наверняка помнишь классическую схему: давайте заведём отдельного «агента-архитектора», «агента-тестировщика» и «агента-ревьюера», пусть они переписываются между собой в чате.
Инженеры банка быстро выяснили: в проде этот зоопарк порождает каскадные ошибки. Агенты начинают играть в испорченный телефон, путают промежуточные состояния и сжигают бюджет на бесконечные взаимные споры. В итоге команда сделала радикальный выбор в пользу единого автономного агента, но обеспечила его максимально полным системным контекстом.
Смерть микросервисов и победа grep
Второй сюрприз касается структуры кодовой базы. Чтобы агент понимал зависимости и не ломал смежные контракты, департамент консолидировал 200 разрозненных микросервисов всего в десяток монорепозиториев. Когда весь проект лежит в одном месте, модели не нужно угадывать, как устроена схема данных в соседней команде: дерево типов доступно целиком.
А ещё команда полностью выбросила тяжеловесные векторные базы данных (RAG) и семантические эмбеддинги кода. Оказалось, что векторный поиск постоянно приносит размытые и нерелевантные фрагменты. Его заменили старым добрым быстрым текстовым поиском — обычным grep и ripgrep. В монорепозитории детерминированный поиск по именам классов, интерфейсов и путям импорта даёт стопроцентную точность совпадений без промахов.
Роль Product Engineer и петля самообучения
Но главное изменение произошло в людях. Классическая эстафета, где тикет неделями кочует от продакта к системному аналитику, потом бэкендеру, фронтендеру, ручному QA и релиз-инженеру, была ликвидирована.
Вместо неё появилась роль Product Engineer. Продакт-овнер ставит бизнесовую задачу прямо в специализированной агентской среде, а продакт-инженер сопровождает её сквозное прохождение по конвейеру, отвечая за итоговый результат. Ключевая операционная метрика системы — процент задач, решённых агентом с первого прохода. Если тесты падают, агент сам изучает диагностику, переписывает код и кристаллизует удачный опыт в базу шаблонов.
Ранее мы уже анализировали инженерию автономных контуров и архитектурные обвязки harness, и опыт Райффайзенбанка подтверждает фундаментальный вывод: автономная разработка держится не на магии больших моделей, а на строгой инженерной гигиене. Без исчерпывающего покрытия тестами и надёжной песочницы агентский конвейер просто разнесёт прод. Но если дисциплина выстроена, ручной набор символов в IDE окончательно уходит в прошлое.