

Привычный интернет, построенный вокруг классического поиска, стремительно уходит в прошлое. Четверть века правила игры оставались неизменными: пользователь вбивал запрос, поисковик показывал десять синих ссылок, а сайты боролись за первые строчки органической выдачи, получая взамен прямой реферальный трафик.
Сегодня этот фундамент трещит по швам. Генеральный директор Google Сундар Пичаи прямо заявил: веб-поиск поглощается «агентским слоем» (Agentic Layer). Поисковая строка превращается в единое диалоговое окно (one-box), где алгоритмы ИИ агрегируют факты из десятков источников, синтезируют готовый ответ и выполняют действия. Перед каждым создателем контента встает вопрос: останется ли место для живых читателей, или открытый веб станет закрытой сырьевой базой для обучения роботов?
Чтобы отделить эмоции от фактов, я изучил масштабные эмпирические исследования: анализ 380 000 генеративных ответов от Foundation Marketing Росса Симмондса, базу цитирований Ahrefs на 168 миллионов ссылок, бюллетень SEOFOMO Алейды Солис и разъяснения инженеров Google Search Central. Картина оказалась гораздо глубже, чем принято считать.
1. Конец эпохи десяти синих ссылок: агентский слой поиска
Заявление Сундара Пичаи фиксирует тектонический сдвиг: поиск больше не стремится быть витриной чужих сайтов. Если раньше человек искал инструкцию по настройке сервера, кликал на статью и читал материал на сайте автора, то теперь Google AI Overviews или диалоговый AI Mode сразу выводят готовый список команд прямо в выдаче.
По данным исследования платформы SE Visible (выборка из 1000 брендовых и категорийных запросов в США), блок AI Overviews активируется уже в 42% случаев. Последствия для сайтов вполне осязаемы: появление генеративного ответа в верхней части экрана снижает средний CTR органических позиций на 32%. Пользователь получает справку за пять секунд и закрывает вкладку.
В индустрии заговорили о катастрофе эпохи «нулевых кликов» (zero-click search). Но если препарировать механику отбора источников нейросетями, выясняется главное: клики не исчезли — они перераспределились по новым законам.
Если ты перестраивал стратегию продвижения под новые алгоритмы, тебе наверняка знакомы наши разборы про отслеживание показов страниц в AI Overviews через Google Search Console, трансформацию пути клиента в статье про поиск без кликов и генеративный ИИ, а также новые правила в материале про концепцию GEO и цитирование в AI Search. Взглянем на эти механизмы сквозь призму сотен тысяч запросов.
2. Раскол двух интернетов: почему Google выбирает YouTube, а ChatGPT — Reddit
Поразительное открытие последних месяцев — феномен существования двух изолированных экосистем генеративного поиска. Сопоставление 168.5 миллионов ссылок из базы Ahrefs Site Explorer выявило раскол между поисковыми корпорациями и создателями диалоговых ассистентов.
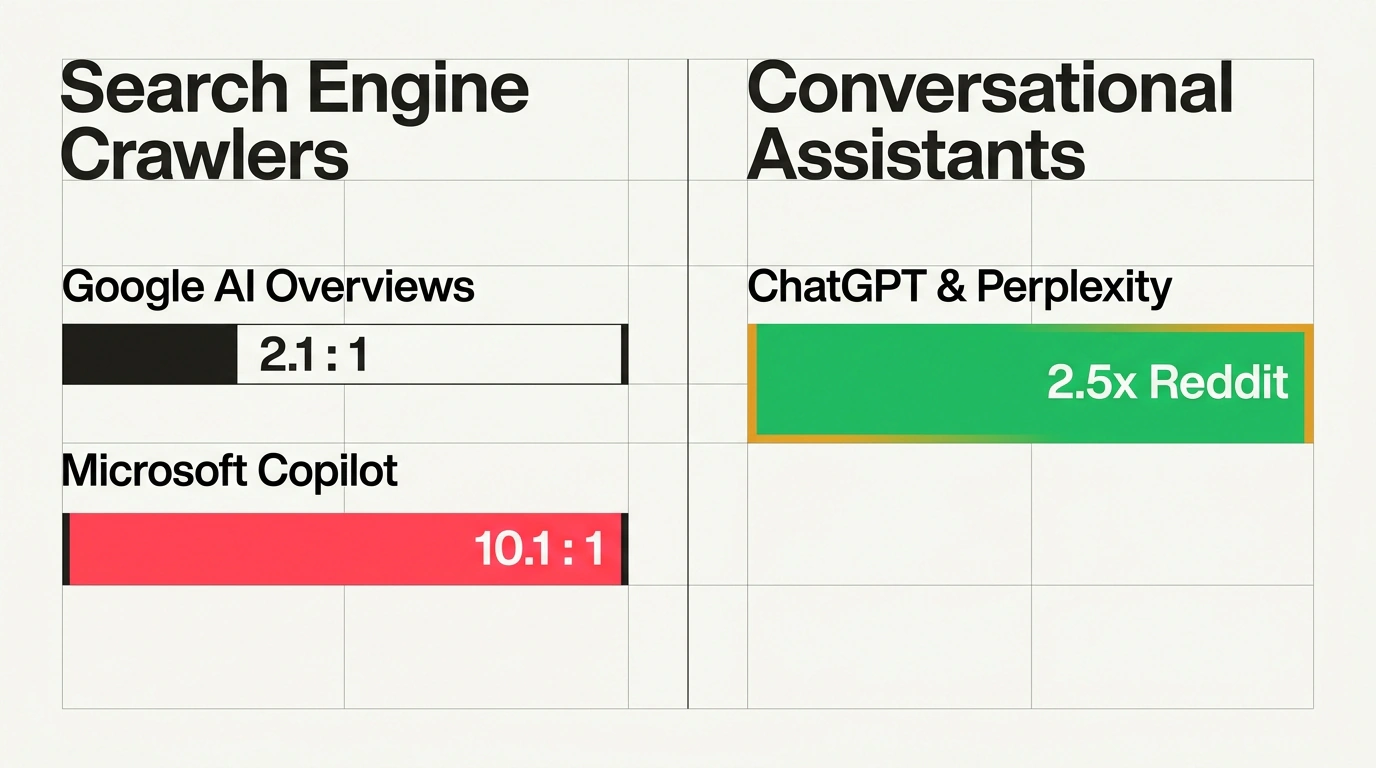
Взгляни на цифры соотношения цитирований видеохостинга YouTube и форума Reddit:
- Поисковые поверхности Google (AI Overviews и AI Mode) отдают от 5.6% до 5.8% всех внешних цитат платформе YouTube. В ответах со ссылками на первоисточники YouTube упоминается в 38%–47% случаев. Соотношение ссылок на YouTube к Reddit составляет 2.1 к 1 в пользу видео.
- Microsoft Copilot демонстрирует ещё более резкий уклон: соотношение цитат YouTube к Reddit достигает 10.1 к 1. Поисковые движки Microsoft и Google жадно сканируют видеоконтент.
- Диалоговые ассистенты (ChatGPT Search, Perplexity, Claude) живут в противоположной вселенной. В ответах Perplexity соотношение цитат YouTube к Reddit составляет 0.6 к 1, а в ChatGPT — 0.4 к 1. Здесь Reddit цитируется в 2.5 раза чаще видеохостинга Google!
Причина разлома кроется в архитектуре. Поисковые генераторы Google опираются на классический веб-индекс, где отлажены расшифровка видео, разбивка роликов на главы и извлечение кадров. Видео для Google — плотный, структурированный массив данных, защищенный от текстового SEO-спама.
В то же время OpenAI и Perplexity делают упор на исследование нефильтрованного человеческого опыта. Лицензионное соглашение с Reddit открыло моделям доступ к пульсу дискуссий. Когда человек спрашивает ChatGPT о реальном опыте владения автомобилем или выборе CMS, модель ищет ветки живых обсуждений на Reddit и Quora, игнорируя глянцевые промо-ролики.
Вывод однозначен: выпуская только текстовые статьи в блоге, ты отсекаешь себя от половины поискового ландшафта. Без присутствия на YouTube ты невидим для Google AI Overviews; без участия в сообществах ты невидим для ChatGPT.
3. Формула попадания в ответ: анатомия 380 000 поисковых генераций
Команда Foundation Marketing под руководством Росса Симмондса препарировала выборку из 380 000 ответов генеративного ИИ в B2B-сегменте программного обеспечения.
Анализ показал, что алгоритмы цитирования в AI Overviews подчиняются трем структурным паттернам:
Первый закон — «Принцип доминирования топ-1 в веерных запросах». Когда пользователь задает сложный промпт («сравни CRM для ритейла с ценами и поддержкой 1С»), поисковый агент разбивает вводную на серию подзапросов (fan-out queries): архитектура, прайс-листы, интеграции. В каждом таком поиске источник на первой позиции забирает 58% всех последующих цитат в синтезированном блоке! Второму месту достается 16%, третьему — 9%, а позиции ниже пятой практически выпадают. Если материал не закрывает конкретный интент с исчерпывающей полнотой, шансы попасть в ответ минимальны.
Второй закон — «Структурные списки и модульность». Статьи, оформленные в виде списков с явными критериями сравнения, цитируются в 64% сравнительных ответов ИИ. Модели трансформера сложно вычленять факты из сплошного текста без подзаголовков. Когда на странице есть четкая структура («Параметр 1: Лимиты», «Параметр 2: Стоимость»), алгоритм переносит этот блок в выдачу без искажений.
Третий закон — «Определительные якоря (Definitional Anchors)». Материалы, начинающиеся с концентрированного определения сути концепции в первых двух предложениях, становятся главными донорами для вводных абзацев AI Overviews. Модель ищет плотную формулировку, которую можно вставить сразу под строкой ввода.
Оформляй тезисы в виде самодостаточных блоков: подзаголовок четко формулирует проблему, первое предложение дает строгое определение без воды, а список из 3–4 пунктов раскрывает параметры или шаги. Именно такие кирпичики поисковый агент переносит в сводку в первую очередь.
4. Технические барьеры и протокол: иллюзия защиты через robots.txt
На фоне тревоги авторов многие площадки начали закрывать доступ краулерам через файл robots.txt. Однако технический разбор инженеров Google Search Central (Гэри Иллиса и Черри Проммавин) вскрывает опасные иллюзии этой практики.
Спецификация RFC 9309 создавалась исключительно для регулирования скачивания страниц поисковыми ботами. Она не запрещает использование уже находящихся в индексе данных для обучения нейросетей. Если страница была проиндексирована ранее, добавление директивы Disallow не сотрет ее из базы знаний модели.
Более того, запрет на обход сайта специализированными краулерами (Google-Extended, GPTBot, PerplexityBot) лишает ресурс присутствия в источниках ответов. При этом модель не перестает генерировать ответы о бренде — она просто начинает опираться на пересказы конкурентов и отзывы на внешних площадках.
Инженеры Google также напомнили: пути в директивах robots.txt для нелатинских символов обязаны кодироваться в стандарте percent-encoding. Ошибки в синтаксисе приводят к тому, что краулеры игнорируют правила или отсекают валидные разделы сайта от поисковой базы.
Блокировка краулеров нового поколения через robots.txt не защищает данные от использования, но гарантированно лишает компанию присутствия в блоках рекомендаций. Дальновидной стратегией становится подача структурированных данных и фактов через открытые API.
5. Новая экономика внимания: от прямого клика к семантическому консенсусу
Как выстраивать работу в эпоху, когда клики перестают отражать реальность? Поисковые аналитики Джанлука Фиорелли, Сайрус Шепард и Эли Шварц предлагают пересмотреть оптику эффективности.
Оценивать присутствие в ИИ-поиске только по последнему клику (last-click attribution) — тупик. Прямой трафик из сноски в AI Overviews невелик, но косвенное влияние колоссально. Когда покупатель видит рекомендацию платформы в синтезированном ответе ChatGPT или Google, формируется доверие. Спустя два дня человек введет брендовый запрос или перейдет к оформлению заказа. Аналитика фиксирует рост ассоциированных конверсий и прямого трафика именно там, где бренд регулярно цитируется генеративными системами.
Для победы требуется стратегия «семантического консенсуса» Росса Симмондса. Нейросеть доверяет факту, когда встречает его подтверждение на нескольких независимых узлах сети. Экспертиза должна присутствовать на пяти уровнях:
- Экспертный лонгрид на собственном домене — первоисточник терминов, цифр и методологии.
- Обучающее видео на YouTube — транскрипты и визуальные данные для Google и Copilot.
- Живые ветки на форумах и Reddit — доказательная база социального одобрения для диалоговых LLM.
- Структурированные карточки в каталогах — однозначные машиночитаемые атрибуты.
- Отраслевые цитирования в профильных медиа — подтверждение авторитетности для ранжирования.
Эпоха наполнения сайтов водянистым текстом ради органических кликов завершилась. Но для тех, кто умеет создавать доказательный контент и распространять его по экосистеме каналов, агентский поиск открывает мощный мультипликатор узнаваемости.