
Если ты когда-нибудь пытался автоматизировать разработку или сложную аналитику с помощью языковых моделей, то наверняка ловил себя на ощущении усталости от постоянного надзора. Ты сидишь перед терминалом, пишешь запрос, ждешь ответ, видишь ошибку в кодовой базе, копируешь ее обратно в чат, объясняешь модели контекст — и так по кругу двадцать раз за вечер. Вроде бы ИИ пишет код, но главным «передаточным звеном» и диспетчером остаешься ты сам.
С появлением Claude Opus 5.5 от Anthropic этот ручной пинг-понг наконец-то уходит в историю. Модель получила нативную способность удерживать логику непрерывных автономных циклов (agentic loops), работая без участия оператора на дистанциях в десятки последовательных итераций.
Мы уже подробно исследовали, как работают градации рассуждений в Claude Opus 5.5 на разных уровнях усилий, а также наблюдали за наступлением персональных ИИ-коллег Claude Duet и Open Duet. Теперь давай разберем по винтикам, как организовать надежный автономный цикл, который не зависает в бесконечных петлях и не сжигает бюджет компании впустую.
Четырехтактный цикл: почему линейный диалог больше не нужен
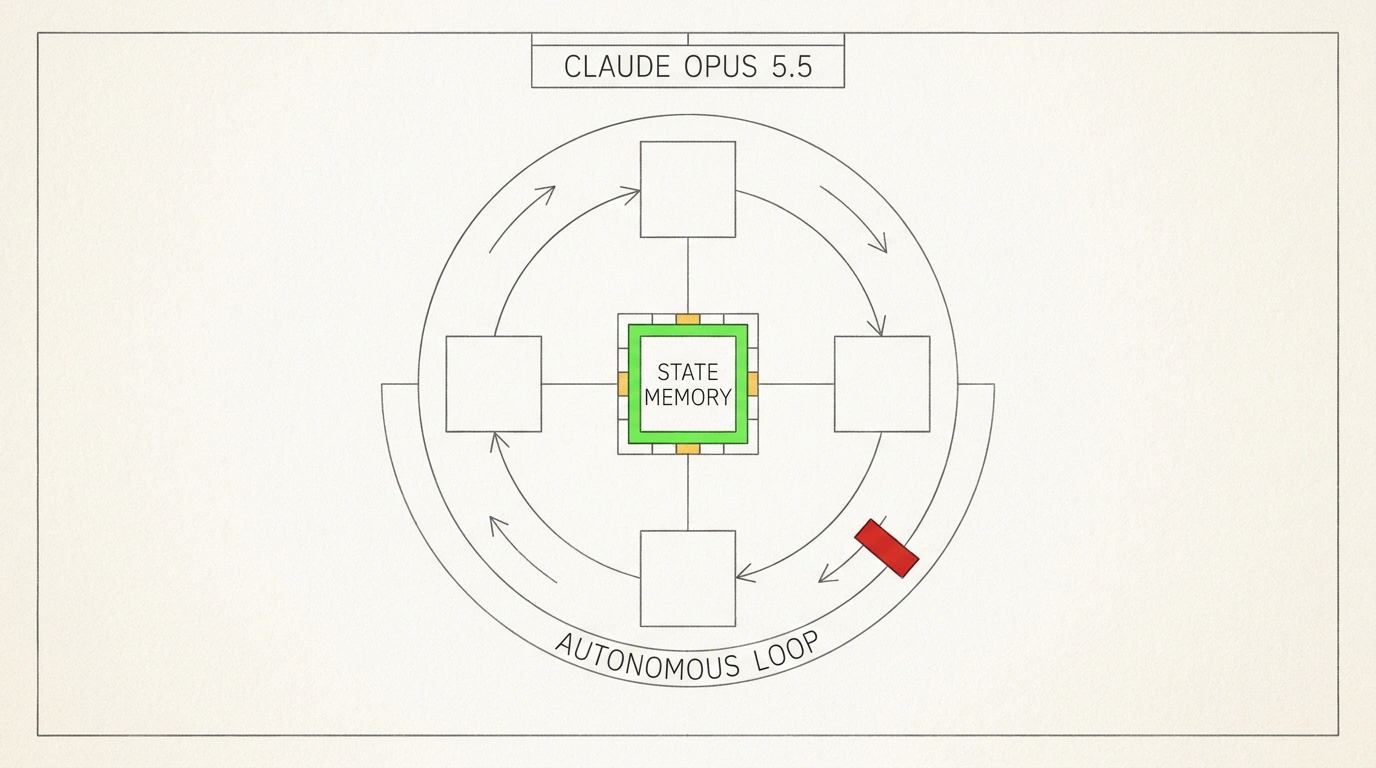
В классической парадигме общения с LLM взаимодействие линейно: вопрос пользователя порождает ответ ассистента. В автономном цикле эта схема заменяется на четырехтактный двигатель:
- Планирование (Plan). Получив высокоуровневую цель (например, «найти и устранить утечку памяти в микросервисе авторизации»), модель декомпозирует ее на список проверяемых подзадач и фиксирует критерии успешности.
- Действие (Act). Модель выбирает подходящий инструмент из системного манифеста (выполнить grep по коду, прочитать файл, запустить профайлер памяти или скомпилировать бинарник) и отдает структурированную команду.
- Оценка (Evaluate). Получив вывод инструмента обратно в контекст, модель сравнивает его с ожидаемым результатом. Если тесты упали, она не бросает работу, а переходит к анализу стектрейса.
- Коррекция (Refine). На основе реальной обратной связи алгоритм модифицирует план или правит строки исходного кода, после чего цикл повторяется.
Такой подход меняет саму суть работы с моделью. Ты задаешь общее направление и уходишь пить кофе, пока агент методично перебирает гипотезы, локализует баг и запускает юнит-тесты до получения чистого зеленого отчета.
Структурированная память и протокол работы с инструментами
Главный враг любого длинного цикла — замусоривание контекстного окна (context drift). Если складывать в один поток весь сырой вывод терминала, логи сборки и промежуточные рассуждения, уже через 15 шагов модель теряет исходную цель и начинает блуждать по кругу.
В связке с Claude Opus 5.5 ключевую роль играет внешняя структурированная память, часто реализуемая в виде рабочего блокнота (scratchpad):
- В начале каждого шага агент обновляет системный блок
<current_state>, где коротко фиксирует: что уже проверено, какая гипотеза опровергнута и какой шаг выполняется прямо сейчас. - Тяжелые логи выполнения утилит сжимаются до ключевых строк ошибок, а исходные файлы читаются только фрагментами через построчный пейджинг.
- Протокол вызова инструментов стандартизирован через жесткие JSON-схемы (tool definitions), что исключает галлюцинации в синтаксисе параметров командной строки.
Благодаря мощному механизму рассуждений Opus 5.5 уверенно удерживает причинно-следственные связи даже тогда, когда задача требует 30–40 последовательных вызовов внешних утилит.
Борьба с галлюцинациями и зацикливанием: критерии остановки
Каждый разработчик автономных систем сталкивался с кошмаром «вечного цикла»: модель находит ошибку, пытается исправить ее, ломает соседний модуль, откатывает изменение, снова сталкивается с первой ошибкой — и крутит этот хоровод, пока не закончатся деньги на балансе API.
Чтобы исключить подобные сценарии, архитектура должна опираться на жесткие программные предохранители (stopping criteria):
- Счетчик итераций без прогресса. Если за последние три цикла хеш измененных файлов совпал с предыдущими состояниями или количество упавших тестов не уменьшилось, цикл принудительно останавливается с запросом вмешательства человека.
- Бюджет токенов на задачу. Для каждого автономного запуска устанавливается жесткий лимит суммарных затрат (например, не более 500 000 токенов на сессию).
- Внешний верификатор. Окончательное решение о завершении задачи принимает не сам агент («я все починил»), а детерминированный системный процесс — прогон полного набора интеграционных тестов в изолированном контейнере.
Экономика токенов: кэширование промптов и оптимизация затрат
Если гонять автономный цикл «в лоб», затраты на вызовы API могут повергнуть в шок даже щедрый стартап. Представь: на каждом из сорока шагов в модель отправляется вся системная инструкция, описание инструментов и накопленная история шагов. Это сотни тысяч токенов, умноженные на тариф флагманской модели.
Спасением здесь выступает технология кэширования промптов (Prompt Caching), нативно поддержанная в API Anthropic. Статическая часть контекста — архитектура системы, документация проекта, системные правила и описания инструментов — помечается специальным флагом кэширования:
- При повторном обращении в рамках 5 минут стоимость чтения закэшированного контекста падает на 90% по сравнению с базовым тарифом.
- Время до первого токена (TTFT) сокращается с 8–10 секунд до доли секунды.
В результате себестоимость сложного тридцатиминутного сеанса автономной отладки падает с десятков долларов до пары сотен центов. Это делает автономные циклы не просто красивой демо-игрушкой, а коммерчески оправданным решением для реального продакшена.