
С момента выхода исторической статьи «Attention Is All You Need» в 2017 году индустрия искусственного интеллекта жила в условиях жесткой технологической монополии. Механизм внимания (Self-Attention) внутри архитектуры Transformer стал фундаментом для всех без исключения фронтирных сетей — от GPT-4o до Claude и Gemini. Масштабирование работало безотказно: насыпай больше слоев, закупай кластеры ускорителей H100 и получай прирост интеллекта.
Но у этой триумфальной формулы есть неустранимый физический барьер: квадратичный рост вычислительной сложности внимания и ненасытный аппетит к оперативной памяти видеокарт. Каждый сгенерированный токен требует сохранения векторов ключей и значений в так называемый KV-кэш (Key-Value Cache). При длинном контексте кэш разрастается до десятков гигабайт, превращая запуск моделей на периферийных устройствах — смарт-очках, автономных дронах или портативных микрокомпьютерах — в невыполнимую инженерную задачу.
Стартап Liquid AI, созданный исследователями из лаборатории CSAIL Массачусетского технологического института (MIT) во главе с Рамином Хасани, Матиасом Лехнером и Даниэлой Рус, бросил вызов общепринятому догмату. Они представили семейство фундаментальных моделей третьего поколения LFM3 (Liquid Foundation Models). Новинка доказывает: компактная не-трансформерная сеть класса 2 миллиардов параметров способна на равных конкурировать с трансформерами, превосходящими ее по размеру в шесть раз. Разбираем математику этой архитектуры и практические последствия для периферийного ИИ.
Жидкие нейросети и три-гибридная архитектура: математика за пределами трансформера
В основе разработки Liquid AI лежит концепция «жидких» нейросетей (Liquid Neural Networks, LNN). В отличие от классических искусственных сетей с зафиксированными на этапе обучения синаптическими весами, жидкие сети моделируются аппаратом непрерывных динамических систем и нелинейных дифференциальных уравнений. Их скрытые состояния и временные константы способны адаптивно подстраиваться под изменяющийся поток входных сигналов непосредственно во время инференса.
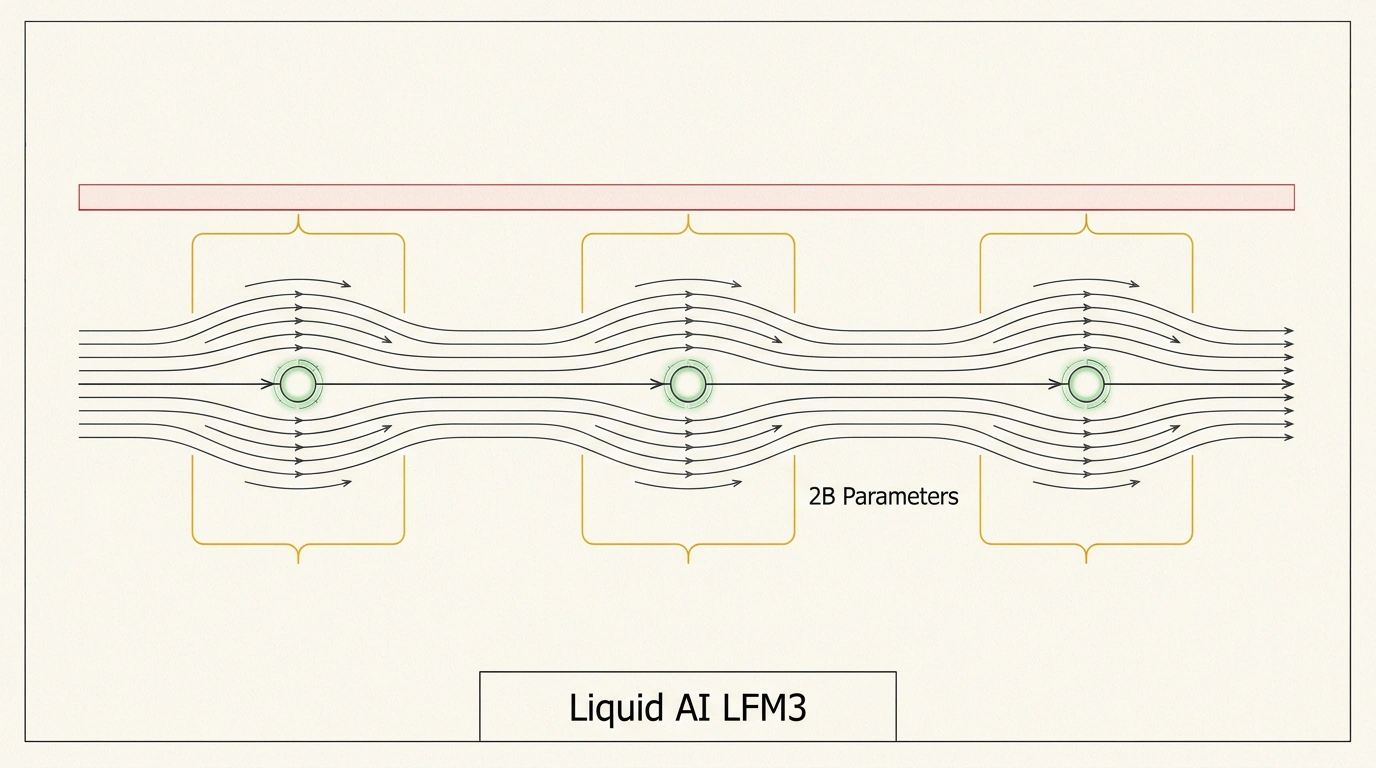
Главным прорывом линейки LFM3 стал отказ от однородных слоев внимания в пользу три-гибридной архитектуры (Tri-Hybrid Architecture). Вместо того чтобы заставлять каждый токен смотреть на все предыдущие символы, вычислительный блок разделен на три взаимодополняющих компонента:
- Стробированные короткие свертки (gated short convolutions). Они берут на себя улавливание локальных морфологических и синтаксических паттернов между соседними токенами. Свертки выполняются за константное время и не требуют сохранения промежуточного кэша.
- Скользящее окно внимания (sliding-window attention). Внимание сохраняется, но действует только на коротком локальном горизонте в несколько сотен токенов, отвечая за точное согласование близлежащих понятий.
- Глобальное линейное сжатие памяти. Вместо раздувания гигантского KV-кэша долговременная память организована в виде компактного математического пространства состояний (State Space), куда непрерывно интегрируется суть прочитанного текста через дифференциальные уравнения.
Такой гибридный подход позволил сократить размер KV-кэша более чем на 70% по сравнению со стандартным трансформером. О том, как эта механика сжимает аппаратные требования, мы подробно рассказывали в материале про мультимодальное семейство Liquid AI LFM 3.
Линейка LFM3: зрительная модель 2B против гигантов 12B и ультралегкий агент
Семейство LFM3 построено на базе единого унифицированного ядра LFM3-1.7B-Base и включает шесть специализированных моделей:
Флагманом мультимодального направления стала модель LFM3-VL-2B (фактический вес 1.9 млрд параметров). Чтобы проверить ее жизнеспособность, разработчики провели масштабное тестирование по 62 независимым бенчмаркам компьютерного зрения. Результаты оказались сенсационными: компактная сеть показала среднее качество распознавания и пространственного ориентирования, идентичное классическим трансформерам класса 12 миллиардов параметров. Модель безошибочно считывает стрелочные приборы, анализирует динамику дорожной обстановки в потоковом видео ряду и уверенно справляется с навигацией роботизированных манипуляторов.
Текстовая модель LFM3-1.7B совершила аналогичный рывок в агентных сценариях:
- Модель поддерживает контекстное окно до 256 000 токенов;
- В 4-битном квантовании (GGUF, Apple MLX, ONNX Runtime) полный вес модели в оперативной памяти составляет всего 1 гигабайт;
- Архитектура специально оптимизирована под частый вызов внешних инструментов (Tool-Calling), парсинг строгих структур JSON и веб-навигацию.
Кроме того, линейка включает аудио-модель LFM3-Audio-2B, сквозную мультимодальную модель LFM3-Omni-2B и специализированные детерминированные классификаторы d1-2B. Принципы работы таких компактных арбитров решений мы разбирали в статье про динамические модели принятия решений Liquid AI d1.
Революция Edge AI: почему энергоэффективность важнее грубой силы
Появление LFM3 меняет расклад сил в индустрии встроенных систем и интернета вещей:
- Полная автономность периферии (Edge AI). Робот-пылесос, дрон видеомониторинга или умные очки больше не зависят от стабильности сотового подключения и задержек облачных серверов. Интеллект уровня современных ассистентов работает локально на недорогих мобильных чипах.
- Энергетическая эффективность. В портативных гаджетах каждый ватт-час аккумулятора на счету. Линейные слои жидкой архитектуры требуют в разы меньше вычислительных тактов на генерацию токена, предотвращая нагрев устройств и продлевая время автономной службы.
- Пропускная способность серверной инфраструктуры. В облачных кластерах устранение тяжелого KV-кэша позволяет разместить на одной видеокарте класса NVIDIA A100 или H100 в 5–10 раз больше параллельных пользовательских сессий, снижая себестоимость инференса на порядок.
Границы возможностей и практические компромиссы
Несмотря на технологический триумф, чудес не бывает, и жидкие нейросети требуют трезвой оценки своих ограничений:
- Емкость фактических знаний. Модель с 1.7–2 млрд параметров математически не способна вместить в свои веса весь объем энциклопедических данных Википедии или миллионов научных монографий. Для фактологических справок ей требуется внешний поиск или база знаний.
- Сложная логическая дедукция. В решении нестандартных олимпиадных задач по математике или написании многостраничных архитектурных эссе LFM3 уступает тяжелым рассуждающим сетям фронтира вроде GPT-5 или Claude Opus.
- Поддержка в экосистеме софта. Интеграция кастомных ядер для дифференциальных слоев жидких сетей требует установки оптимизированных библиотек, хотя базовая поддержка в ONNX и MLX снимает остроту проблемы.
Семейство Liquid AI LFM3 убедительно доказало: эра слепого наращивания параметров подходит к концу, уступая место изящным динамическим архитектурам, где важна не масса нейросети, а ее внутренняя организация.