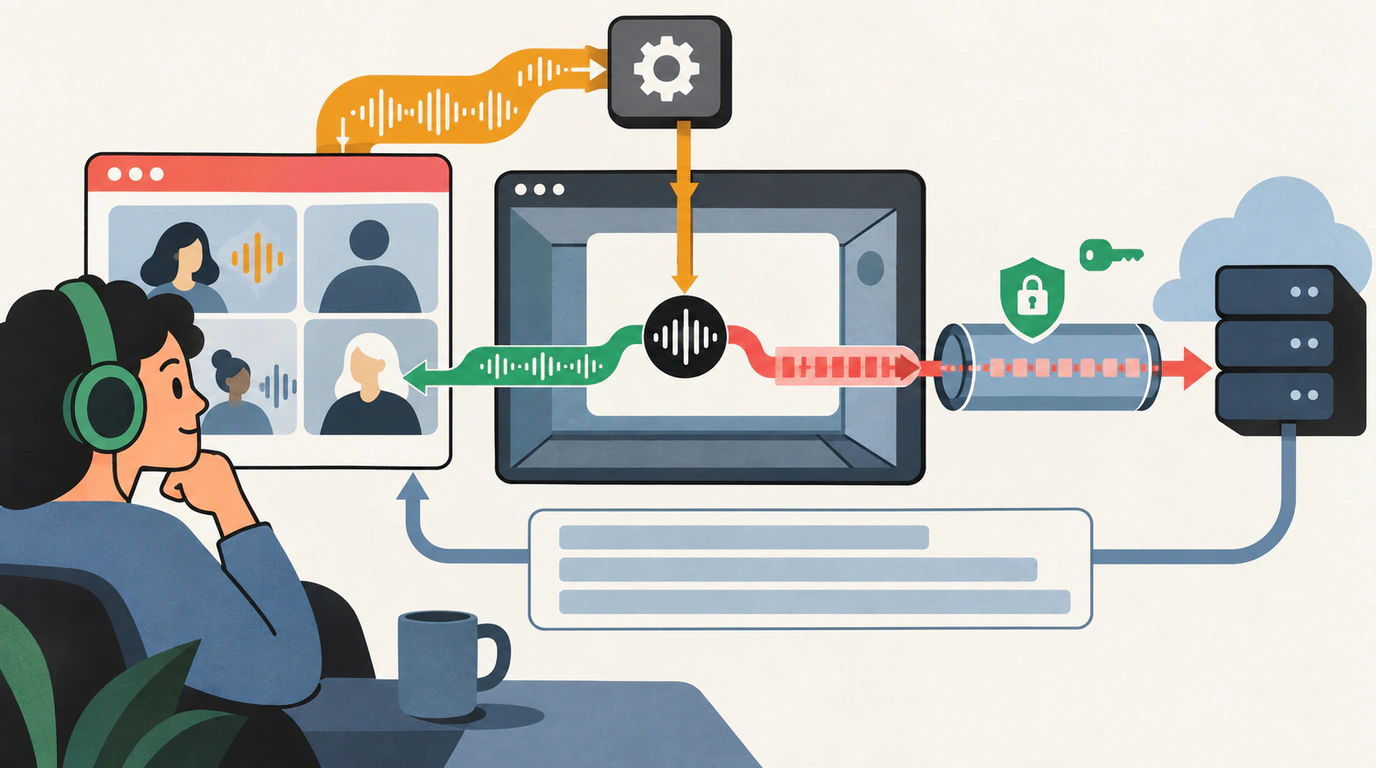

Перевод живой речи во время видеоконференций — одна из самых востребованных задач для специалистов, работающих в распределенных интернациональных командах. Традиционный подход к созданию таких инструментов опирается на подключение виртуальных ботов-участников: программа авторизуется в Google Meet, Zoom или Microsoft Teams под видом отдельного собеседника, перехватывает медиапоток встречи и транслирует текстовую расшифровку.
Однако появление бота в закрытом созвоне вызывает массу организационных и юридических трений: организаторы часто блокируют сторонних ботов из соображений конфиденциальности, а корпоративные политики безопасности прямо запрещают передачу звука внешним интеграциям. Естественной альтернативой становится разработка клиентского расширения для Google Chrome. Расширение функционирует локально на компьютере пользователя, перехватывает звук прямо из активной вкладки браузера и накладывает плавающие субтитры поверх интерфейса звонка.
При реализации такой архитектуры на современной платформе Manifest V3 разработчики сталкиваются с серией жестких платформенных барьеров, а экономика потокового распознавания речи способна неприятно удивить многотысячными счетами от облачных провайдеров.
Ловушки Manifest V3: Service Worker и невидимый offscreen-документ
Исторически расширения Chrome на базе Manifest V2 использовали постоянную фоновую страницу (background page), имевшую полный доступ к DOM-дереву и мультимедийным интерфейсам браузера. В Manifest V3 фоновые страницы полностью упразднены: их заменил фоновый Service Worker.
Служебный воркер запускается по требованию и автоматически выгружается из памяти при отсутствии событий. Главная проблема для аудио-инженерии заключается в том, что в контексте Service Worker полностью отсутствуют интерфейсы Web Audio API, объект AudioContext и метод navigator.mediaDevices.getUserMedia(). Попытка инициализировать аудио-пайплайн внутри воркера приводит к фатальной ошибке выполнения.
Штатный механизм Chrome для решения этой проблемы — использование специализированных offscreen-документов. Это скрытые HTML-страницы без видимого графического интерфейса, создаваемые расширением для выполнения специфических задач с DOM или медиапотоками.
Пайплайн инициализации перехвата звука делится на два изолированных этапа:
- Фоновый Service Worker вызывает API
chrome.tabCapture.getMediaStreamId(), передавая идентификатор вкладки с видеозвонком. Браузер генерирует уникальный токен доступа к аудиопотоку. - Service Worker проверяет наличие активного документа и создает offscreen-страницу с декларативной причиной
USER_MEDIA, после чего отправляет полученный токен через систему внутренних сообщенийchrome.runtime.sendMessage().
Ниже представлен первый блок прогрессивной цепочки — логика фонового скрипта, связывающего перехват вкладки и жизненный цикл скрытого документа:
// background.js — фоновый Service Worker расширения
const OFFSCREEN_DOCUMENT_PATH = 'offscreen.html';

// Проверка и создание offscreen-документа для работы с аудио
async function ensureOffscreenDocument() {
  const existingContexts = await chrome.runtime.getContexts({
    contextTypes: ['OFFSCREEN_DOCUMENT'],
  });

  if (existingContexts.length === 0) {
    await chrome.offscreen.createDocument({
      url: OFFSCREEN_DOCUMENT_PATH,
      reasons: ['USER_MEDIA'],
      justification: 'Перехват и обработка PCM-аудиопотока из активной вкладки звонка',
    });
  }
}

// Запуск процесса перехвата звука из целевой вкладки
export async function startCapture(targetTabId) {
  await ensureOffscreenDocument();

  // Получаем уникальный идентификатор медиапотока для вкладки
  const streamId = await chrome.tabCapture.getMediaStreamId({
    targetTabId: targetTabId,
    consumerTabId: targetTabId,
  });

  // Передаем токен потока в offscreen-контекст для инициализации Web Audio
  chrome.runtime.sendMessage({
    type: 'START_AUDIO_PIPELINE',
    streamId: streamId,
  });
}
Проблема внезапной тишины и арбитраж потока
Сразу после успешного получения медиапотока разработчик сталкивается с неожиданным побочным эффектом: звук в наушниках пользователя мгновенно исчезает. Механизм tabCapture устроен так, что при перехвате звука вкладки браузер отключает ее стандартный вывод на системные динамики, чтобы избежать зацикливания эха.
Чтобы пользователь продолжал слышать собеседников во время созвона, аудиопоток внутри offscreen-документа необходимо принудительно раздвоить через Web Audio API. Один маршрут отправляется на системный выход audioContext.destination, а второй направляется в рабочий узел AudioWorklet для оцифровки и нарезки на непрерывные сырые PCM-чанки.
Второй критический подводный камень кроется в жизненном цикле медиапотоков. Если пользователь закрывает звонок или повторно кликает по иконке перевода, вызов getMediaStreamId() завершается ошибкой: Cannot capture a tab with an active stream. Браузер считает, что предыдущий поток все еще активен, даже если вкладка перезагружена. Простая расстановка задержек через setTimeout здесь бессильна. Надежное решение требует активного опроса состояния через chrome.tabCapture.getCapturedTabs() с коротким интервалом в 50 миллисекунд и явной остановки всех аудиотреков (track.stop()) перед переинициализацией.
Второй блок кода демонстрирует обработку звука внутри offscreen-страницы: восстановление слышимости и извлечение сырых бинарных данных:
// offscreen.js — обработчик аудиопотока в изолированном контексте
let audioContext = null;
let mediaStream = null;

chrome.runtime.onMessage.addListener(async (message) => {
  if (message.type === 'START_AUDIO_PIPELINE') {
    await initAudioGraph(message.streamId);
  }
});

async function initAudioGraph(streamId) {
  // Захватываем поток по ранее сгенерированному браузером токену
  mediaStream = await navigator.mediaDevices.getUserMedia({
    audio: {
      mandatory: {
        chromeMediaSource: 'tab',
        chromeMediaSourceId: streamId,
      },
    },
    video: false,
  });

  audioContext = new AudioContext({ sampleRate: 16000 });
  const source = audioContext.createMediaStreamSource(mediaStream);

  // Важнейший шаг: возвращаем звук в динамики пользователя, снимая заглушение
  source.connect(audioContext.destination);

  // Создаем узел захвата для отправки сырых PCM-семплов на распознавание
  const processor = audioContext.createScriptProcessor(4096, 1, 1);
  source.connect(processor);
  processor.connect(audioContext.destination);

  processor.onaudioprocess = (e) => {
    const inputData = e.inputBuffer.getChannelData(0);
    // Преобразуем Float32 в 16-битный Int16 PCM для передачи в WebSocket
    const pcmData = convertFloatToInt16(inputData);
    sendAudioChunkToStream(pcmData);
  };
}

function convertFloatToInt16(buffer) {
  const pcm = new Int16Array(buffer.length);
  for (let i = 0; i < buffer.length; i++) {
    const s = Math.max(-1, Math.min(1, buffer[i]));
    pcm[i] = s < 0 ? s * 0x8000 : s * 0x7FFF;
  }
  return pcm.buffer;
}
Экономика потока: раздельные сервисы против монопотока
Архитектура серверной части распознавания и перевода определяет финансовую жизнеспособность всего продукта. Классический конвейер большинства расширений состоит из двух раздельных звеньев:
- Потоковое распознавание речи (STT) через сервис вроде Deepgram.
- Машинный перевод полученного текста через API DeepL или Google Translate.
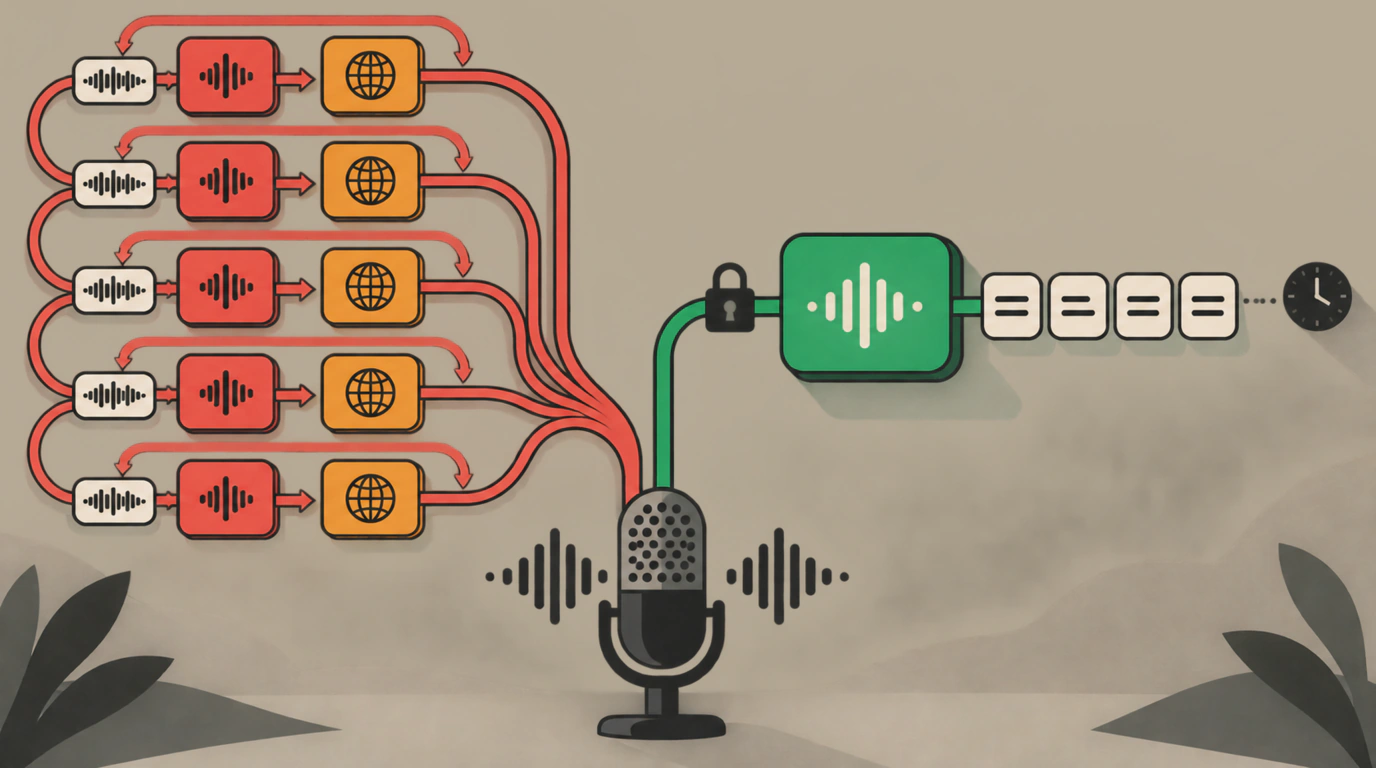
На первый взгляд такая схема выглядит логичной, однако в реальном времени она порождает взрывной рост затрат. Движок распознавания речи в потоке выдает промежуточные гипотезы (interim results): фраза пересчитывается по мере произнесения каждого нового слова. Если отправлять каждую промежуточную гипотезу в API перевода, одно и то же предложение переводится повторно от 5 до 12 раз.
В реальных замерах на часовом созвоне связка Deepgram и DeepL сжигала в среднем $2,55 за каждый час аудио. При регулярной работе инженера (3–4 часа встреч в день) ежемесячный счет превышал $200 на одного человека, делая публичный запуск сервиса нерентабельным.
Решением стал переход на модель сквозного потокового перевода (единый аудио-стрим), где распознавание исходной речи и генерация перевода выполняются одной монолитной нейросетевой моделью (в данном кейсе — Soniox stt-rt-v5). Аудиоданные непрерывно транслируются через защищенный WebSocket, а обратно приходят готовые токены переведенного текста.
Сравнение двух подходов по итогам 202,6 часа практических созвонов:
| Параметр | Двухзвенный пайплайн (Deepgram + DeepL) | Монопоток (Soniox stt-rt-v5) |
|---|---|---|
| Стоимость часа созвона | ~$2,55 | $0,154 (снижение в 16,5 раз) |
| Итоговый счет за 202,6 часа | ~$516,60 | $31,23 |
| Задержка появления черновика | 1,8 – 2,2 секунды | 2,5 – 3,5 секунды |
| Задержка финальной фразы | 2,1 – 2,8 секунды | 4,3 – 7,6 секунды |
| Устойчивость к шумам звонка | Высокая | Высокая |
Переход на сквозной стриминг снизил расходы почти в 17 раз ценой контролируемого компромисса: финальная переведенная фраза появляется на экране с небольшой задержкой (около 4–7 секунд). Для формата субтитров это полностью приемлемо: собеседник успевает договорить мысль, а читающий получает выверенный, грамматически согласованный перевод всего предложения.
Завершающий фрагмент кода иллюстрирует потоковую передачу PCM-данных через WebSocket и прием переведенных токенов:
// audioStreamer.js — передача аудиопотока в единый сервис распознавания и перевода
let socket = null;

export function connectStreamSocket(temporaryApiKey) {
  // Подключаемся к WebSocket-шлюзу модели прямого перевода
  socket = new WebSocket(`wss://api.soniox.com/transcribe-stream?key=${temporaryApiKey}`);
  socket.binaryType = 'arraybuffer';

  socket.onopen = () => {
    // Конфигурируем поток: целевой язык перевода и параметры квантования
    const config = {
      model: 'stt-rt-v5',
      target_language: 'ru',
      audio_format: 'pcm_s16le',
      sample_rate: 16000,
    };
    socket.send(JSON.stringify({ type: 'CONFIG', data: config }));
  };

  socket.onmessage = (event) => {
    const response = JSON.parse(event.data);
    if (response.tokens && response.tokens.length > 0) {
      // Отправляем готовые фразы субтитров в UI контентного скрипта
      chrome.tabs.sendMessage(activeTabId, {
        type: 'RENDER_SUBTITLE',
        text: response.text,
        isFinal: response.is_final,
      });
    }
  };
}

// Отправка бинарного чанка звука, полученного из offscreen-документа
export function sendAudioChunkToStream(pcmBuffer) {
  if (socket && socket.readyState === WebSocket.OPEN) {
    socket.send(pcmBuffer);
  }
}
Синтетический стенд: тестирование WebRTC без участия людей
Финальной инженерной задачей стала организация нагрузочного и регрессионного тестирования расширения. Привлечение живых разработчиков для проверки каждой сборки в Google Meet непрактично: люди запинаются, меняют темп речи, а тестирование утечек памяти требует непрерывных многочасовых сессий.
Для автоматизации был развернут headless-стенд под управлением Linux. Стенд запускал три параллельных профиля Chromium под управлением Puppeteer:
- Первый профиль открывал созвон Google Meet и транслировал в микрофон студийную запись диалога на английском языке через виртуальное звуковое устройство ALSA/PulseAudio.
- Второй профиль выступал слушателем, на котором активировалось тестируемое расширение.
- Третий профиль логировал потребление оперативной памяти Service Worker, замерял тайминги прихода WebSocket-фреймов и сравнивал полученные субтитры с эталонной расшифровкой.
Такой испытательный полигон позволил выявить утечку слушателей событий в AudioWorklet, которая приводила к незаметному потреблению сотен мегабайт памяти к концу второго часа созвона, и точно откалибровать размер буфера отправки пакетов.
Никогда не храните постоянные секретные токены облачных провайдеров в кодовой базе браузерного расширения. Любой пользователь может декомпилировать пакет и извлечь ключ. Реализуйте собственный легковесный бэкенд, который авторизует пользователя и генерирует короткоживущие временные сессионные токены (scoped session keys) с ограничением по времени жизни и расходу баланса.
Опыт разработки субтитров для Manifest V3 доказывает, что браузерная среда способна справляться со сложными задачами медиа-обработки в реальном времени. Грамотное разделение контекстов между фоновым воркером и offscreen-документом, своевременная очистка системных треков и переход на унифицированные нейросетевые монопотоки позволяют создавать масштабируемые и экономически эффективные инженерные инструменты.