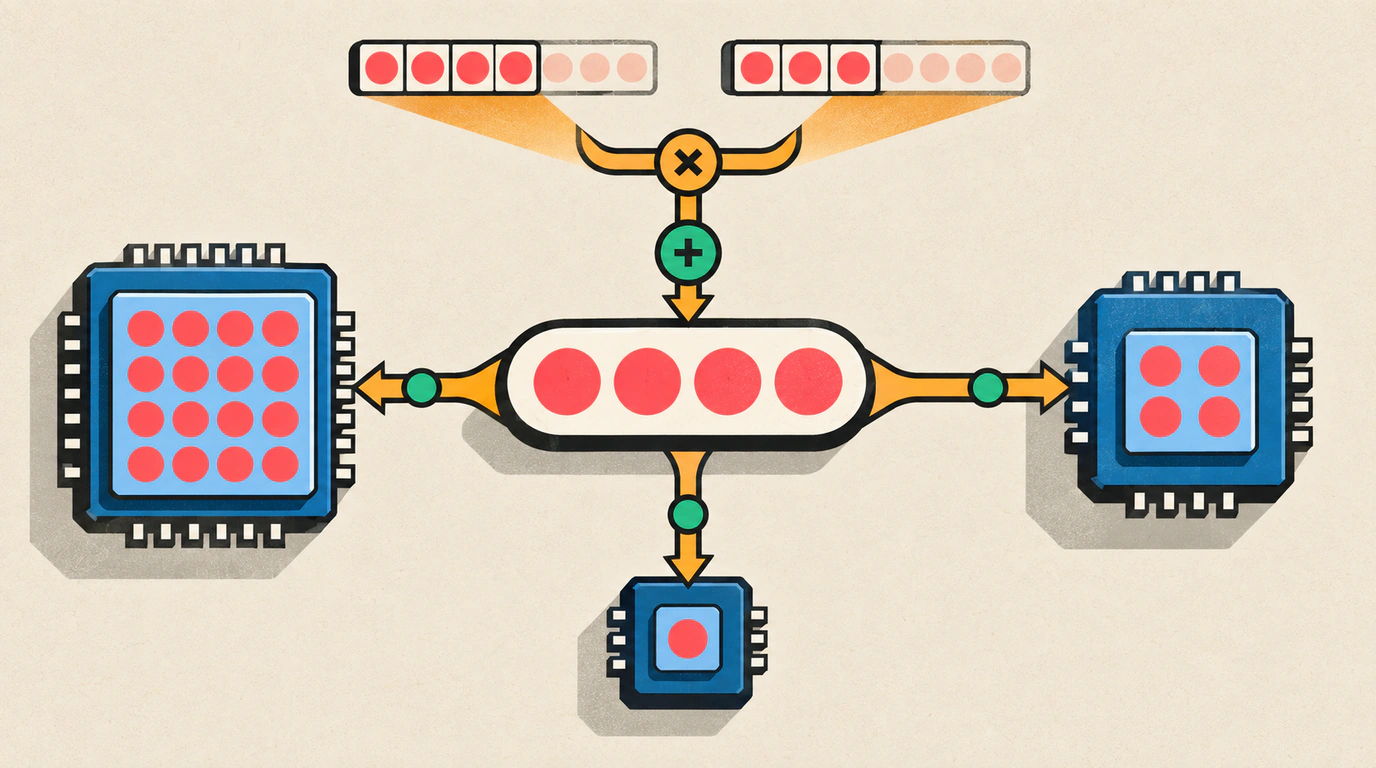

Аппаратная векторизация вычислений (Single Instruction, Multiple Data, или SIMD) лежит в основе производительности современных вычислительных систем. Принцип ее работы заключается в том, что процессор за один такт выполняет одну и ту же арифметическую операцию сразу над несколькими элементами массива данных, упакованными в широкий регистр (128, 256 или 512 бит). В таких задачах, как обработка звука и видео, машинное обучение, поиск по векторным базам данных, парсинг JSON и криптография, векторизация обеспечивает ускорение в три-восемь раз.
Однако разработчики на Go долгие годы оставались в стороне от прямого использования векторных инструкций. В стандартной библиотеке и компиляторе отсутствовали высокоуровневые примитивы для работы с регистрами процессора. Единственным путем оставалось написание низкоуровневых ассемблерных функций на диалекте Go assembly. Этот путь порождал массу проблем: код становился сложным в поддержке, требовал отдельной реализации под каждый процессор (x86 AVX, ARM NEON, WebAssembly) и лишал компилятор возможности встраивать функции (инлайнинг), из-за чего накладные расходы на вызов нивелировали часть выигрыша.
Ситуация кардинально изменилась с выходом релизов Go 1.26 и Go 1.27, где команда компилятора представила экспериментальную поддержку кроссплатформенного SIMD на уровне стандартных пакетов языка.
Эволюция компилятора: от низкоуровневых регистров к гибким абстракциям
Развитие векторных вычислений в Go шло в два этапа:
- В версии Go 1.26 появился внутренний пакет
simd/archsimd. Он предоставил прямой доступ к инструкциям архитектуры amd64 (наборы SSE, AVX, AVX2 и AVX-512). Пакет позволял оперировать жесткими типами вродеFloat32x4илиFloat64x8, жестко привязанными к разрядности аппаратных регистров конкретного чипа. Это позволило ускорить внутренние подсистемы среды исполнения, но не решало проблему переносимости прикладного кода. - В релизе Go 1.27 архитекторы Дэвид Чейз (David Chase) и Цзюньян Шао (Junyang Shao) представили новый высокоуровневый пакет
simd. Архитектура вдохновлена библиотекой Highway от Google для языка C++. Главная идея пакета — отказ от жесткой фиксации ширины регистров в коде программы.
Вместо типов с фиксированным числом элементов пакет simd оперирует абстрактными типами во множественном числе: simd.Float32s, simd.Float64s, simd.Int32s, simd.Uint8s. Количество элементов (полос, или lanes), обрабатываемых за один такт, определяется динамически в рантайме в зависимости от того, на каком процессоре запущен бинарный файл. Если программа запущена на сервере с поддержкой AVX-512, регистр вместит 16 чисел типа float32. На ноутбуке с процессором Apple Silicon и инструкциями ARM NEON ширина составит 4 числа, а на старом процессоре без векторных блоков код прозрачно выполнится через обычные скалярные инструкции без сбоев и паник.
Внутреннее устройство: компилятор SSA и интринсики
Вызовы функций пакета simd не являются обычными функциями Go с передачей параметров через стек. Компилятор Go на этапе генерации промежуточного представления (Static Single Assignment, SSA) распознает эти методы как платформенные интринсики (compiler intrinsics). Метод вычисления транслируется напрямую в одну ассемблерную инструкцию процессора (например, VFMADD231PS в архитектуре x86 или FMLA в архитектуре ARM).
Благодаря этому достигаются ключевые преимущества:
- Нулевые накладные расходы. Нет вызовов функций, переключения фреймов стека и лишних аллокаций памяти в куче.
- Поддержка оптимизатором. Компилятор свободно встраивает векторный код внутрь вызывающих функций, переупорядочивает инструкции и распределяет регистры процессора с учетом окружающего контекста.
- Интеграция со сборщиком мусора. Сама среда исполнения Go использует векторные инструкции в новом сборщике мусора Green Tea GC для мгновенного сканирования битовых карт живых объектов в куче.
Практическая реализация: скалярное произведение векторов
Рассмотрим классическую вычислительную задачу — расчет скалярного произведения двух срезов чисел (Dot Product). Эта операция лежит в основе поиска ближайших соседей (kNN) и косинусного расстояния в базах данных векторов.
В стандартном коде без векторизации алгоритм выглядит как простой цикл с последовательным накоплением суммы:
package main

// ScalarDotProduct вычисляет скалярное произведение в базовом последовательном цикле
func ScalarDotProduct(a, b []float32) float32 {
    if len(a) != len(b) {
        panic("длины срезов должны совпадать")
    }

    var sum float32
    for i := 0; i < len(a); i++ {
        sum += a[i] * b[i]
    }
    return sum
}
Процессор в этом случае вынужден выполнять умножение и сложение строго последовательно, ожидая завершения предыдущей инструкции.
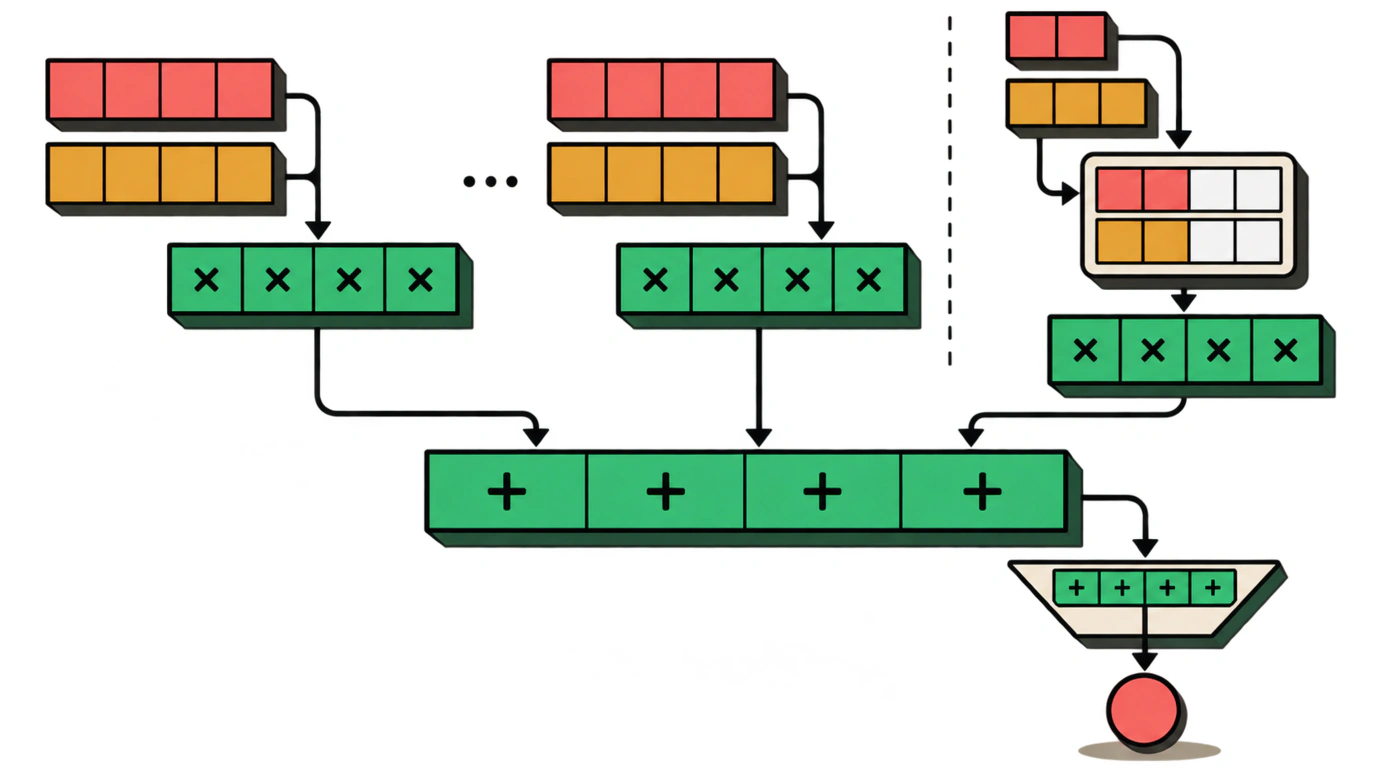
В Go 1.27 для перевода вычислений на векторные рельсы подключается экспериментальный пакет simd. Программа строится по трехчастной схеме: основной цикл по аппаратным векторным полосам, безопасная обработка краевого остатка (хвоста массива, не кратного ширине регистра) и горизонтальное сложение элементов аккумулятора:
//go:build goexperiment.simd

package main

import (
    "fmt"
    "simd"
)

// VectorDotProduct вычисляет скалярное произведение через кроссплатформенный SIMD
func VectorDotProduct(a, b []float32) float32 {
    if len(a) != len(b) {
        panic("длины срезов должны совпадать")
    }

    var acc simd.Float32s
    lanes := acc.Len()
    var i int

    // Основной векторизованный цикл: за шаг обрабатывается lanes элементов
    for i = 0; i <= len(a)-lanes; i += lanes {
        va := simd.LoadFloat32s(a[i : i+lanes])
        vb := simd.LoadFloat32s(b[i : i+lanes])
        // Выполняем совмещенное умножение со сложением: acc += va * vb
        acc = va.MulAdd(vb, acc)
    }

    // Обработка краевого остатка, если длина среза не кратна ширине регистра
    if i < len(a) {
        va, _ := simd.LoadFloat32sPart(a[i:])
        vb, _ := simd.LoadFloat32sPart(b[i:])
        acc = va.MulAdd(vb, acc)
    }

    // Горизонтальное суммирование элементов вектора в итоговое число
    return HorizontalSum(acc)
}

// HorizontalSum выгружает векторный регистр в локальный буфер и суммирует значения
func HorizontalSum(v simd.Float32s) float32 {
    buf := make([]float32, v.Len())
    v.Store(buf)
    var total float32
    for _, val := range buf {
        total += val
    }
    return total
}
Обратите внимание на метод LoadFloat32sPart. Это принципиальное новшество Go: метод безопасно считывает оставшиеся элементы среза без риска паники выхода за границы памяти (out of bounds) и заполняет недостающие полосы регистра нулями, благодаря чему умножение не искажает итоговый результат.
Сборка, флаги экспериментов и проверка сгенерированного ассемблера
Поскольку функционал находится в статусе экспериментального, его активация требует явного указания директив компилятора:
# Запуск тестов и замер производительности с включением эксперимента
GOEXPERIMENT=simd go test -bench=BenchmarkDotProduct -benchmem

# Проверка сгенерированного ассемблерного кода SSA на наличие векторных инструкций
GOEXPERIMENT=simd go build -gcflags="-S" main.go 2>&1 | grep -E "VFMADD|FMLA|VADDPS"
В выводе команды дизассемблирования будут видны инструкции VFMADD231PS для x86-64 или FMLA для систем ARM64, подтверждающие, что компилятор сгенерировал высокоэффективные команды без единого системного вызова.
Ограничения первой версии и перспективы развития
Эксперимент в Go 1.26 и 1.27 открывает огромные возможности, однако инженерам важно учитывать текущие компромиссы:
- Отсутствие нативной горизонтальной редукции. В текущей версии API нет встроенной функции быстрого сложения элементов внутри одного регистра (вроде
ReduceAdd). Разработчикам приходится временно использовать вспомогательную функциюHorizontalSumс выгрузкой в срез памяти. Полноценная горизонтальная редукция запланирована к выходу в релизе Go 1.28. - Размер обрабатываемых данных. Накладные расходы на инициализацию регистров и обработку краевых условий имеют смысл на массивах данных от нескольких десятков элементов. На микровычислениях (например, умножении двух-трех чисел) выигрыша не будет.
- Статус стабильности. Сигнатуры методов пакета
simdмогут незначительно корректироваться до момента окончательной стабилизации в составе стандартной библиотеки Go.
Внедрение платформонезависимого SIMD превращает Go в полноценный инструмент для создания высокопроизводительных систем обработки данных, позволяя конкурировать с решениями на C++ и Rust без потери фирменной простоты и надежности языка.