
Среди системных архитекторов и разработчиков высоконагруженных платформ существует негласное правило: выбирайте скучные, проверенные временем технологии. В мире баз данных нет ничего более «скучного» и надежного, чем SQLite. Это компактное встраиваемое ядро базы данных работает в миллиардах смартфонов, браузерах, автомобильных бортовых компьютерах и космических аппаратах. Тестовый набор SQLite превосходит по объему рабочий код в сотни раз, а его стабильность стала эталоном инженерной дисциплины.
Именно поэтому инженеры компании Tailscale, строящей глобальную ячеистую виртуальную сеть (mesh VPN), выбрали SQLite для хранения состояния координационного сервера. Однако в конце концов Tailscale столкнулась с серией необъяснимых аварий: базы данных на серверах спонтанно повреждались, приводя к фатальным сбоям.
Расследование этой аномалии растянулось на полгода и вскрыло дефект параллелизма в механизме журнала упреждающей записи (Write-Ahead Logging), который скрывался в недрах ядра SQLite на протяжении шестнадцати лет.
Загадочные аварии шардов координационного сервера
Архитектура управляющего контура Tailscale разбита на изолированные шарды. Каждый шард обслуживает группу виртуальных сетей клиентов (tailnets) и работает как независимый процесс на языке Go. Чтобы избежать сложностей с сетевыми распределенными транзакциями, шард хранит данные в локальном файле SQLite. Единственный поток Go выполняет операции записи, а множество фоновых потоков читают таблицы без взаимных блокировок.
Схема казалась неуязвимой, пока однажды дежурные инженеры не получили сигнал тревоги: координационный сервер внезапно упал с системной ошибкой повреждения базы данных (SQLITE_CORRUPT). Вызов стандартной встроенной диагностики PRAGMA integrity_check вернул неутешительный вердикт: нарушена структура B-дерева, указатели страниц ссылаются на поврежденные блоки.
Первым делом подозрение пало на аппаратную часть: битую оперативную память серверов или баги прошивки NVMe-накопителей в облаке AWS. Но проблема повторилась снова, затем еще раз. За шесть месяцев инженеры зафиксировали девятнадцать инцидентов повреждения баз на совершенно разных физических узлах. Никаких следов сбоев оборудования в системных журналах ядра Linux обнаружить не удалось. База повреждалась под воздействием самого программного кода.
Анатомия WAL: журнал упреждающей записи и разделяемая память
Чтобы понять природу ошибки, необходимо заглянуть в то, как SQLite управляет транзакциями в режиме Write-Ahead Logging (WAL).
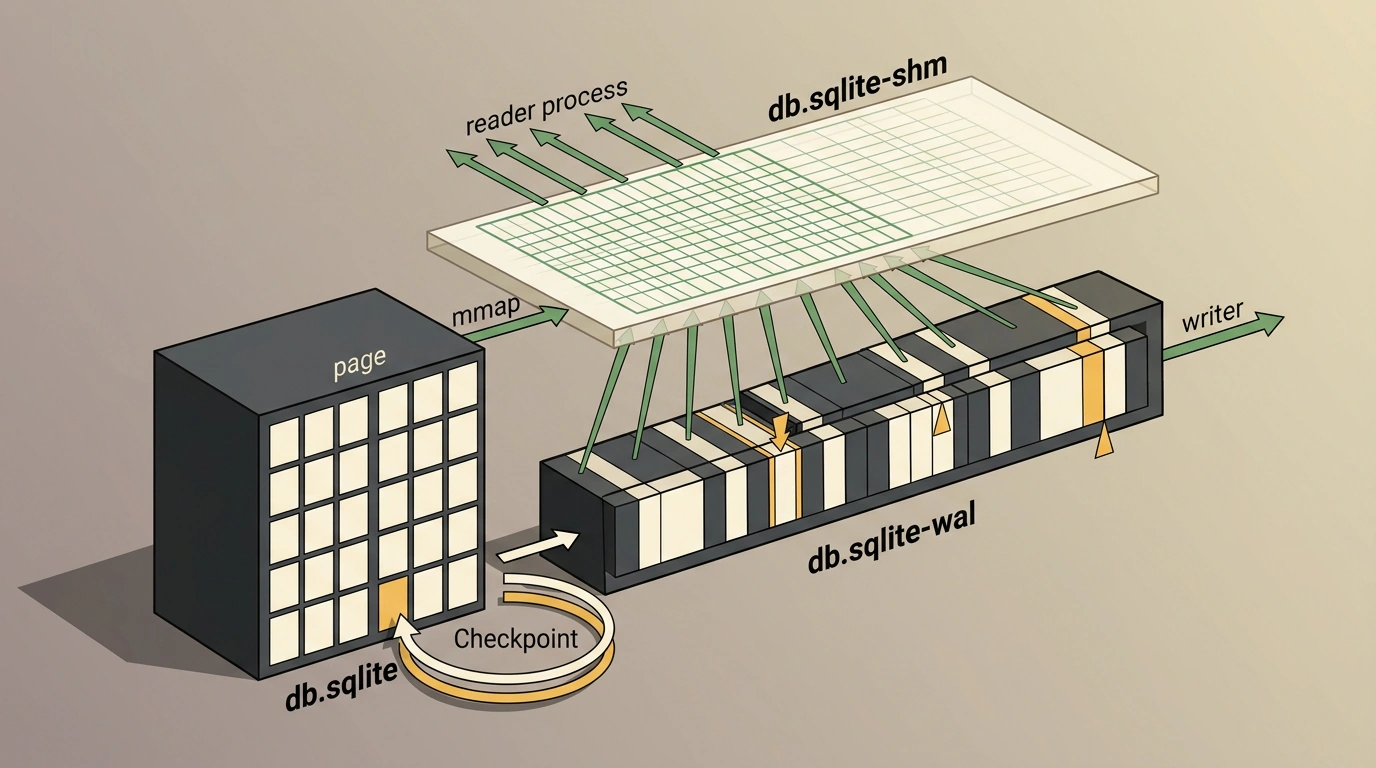
В классическом режиме отката SQLite при записи блокирует весь файл базы данных. В режиме WAL поведение кардинально меняется: читатели и писатели перестают мешать друг другу:
- Когда процесс сохраняет изменения, новые страницы данных не записываются в основной файл базы
db.sqlite. Вместо этого они последовательно дописываются в отдельный файл журналаdb.sqlite-wal. - Чтобы читающие процессы знали, где искать самую свежую версию конкретной страницы (в исходном файле или в журнале), SQLite задействует файл индекса
db.sqlite-shm. Этот индекс размещается в разделяемой оперативной памяти через системный вызовmmap. - Читатель смотрит в индекс разделяемой памяти, находит номер нужного фрейма в WAL и считывает актуальные данные. Писатель тем временем продолжает добавлять новые фреймы в конец журнала.
Разумеется, файл WAL не может расти бесконечно. Периодически в работу вступает операция контрольной точки — чекпоинт (checkpoint). Поток чекпоинта считывает накопившиеся страницы из файла WAL, переносит их в основной файл базы данных, а затем выполняет процедуру сброса журнала (WAL reset), чтобы следующие записи перезаписывали файл с нулевого смещения.
250 миллисекунд спешки: как Tailscale разбудила спящую проблему
Дефект в алгоритме чекпоинта присутствовал в кодовой базе SQLite с момента появления режима WAL в 2010 году. Почему же за шестнадцать лет активной эксплуатации на миллиардах устройств никто с ним не сталкивался?
Ответ крылся в необычном эксплуатационном профиле Tailscale. Для обеспечения катастрофоустойчивости компания организовала непрерывную репликацию баз данных в объектное хранилище Amazon S3. Чтобы моментальные снимки базы были максимально свежими, инженеры решили не полагаться на стандартный автоматический чекпоинт SQLite (который срабатывает при накоплении 1000 страниц). Они перехватили управление и настроили принудительный запуск чекпоинта с усечением файла:
package main

import (
    "database/sql"
    "fmt"
    "log"
    _ "github.com/mattn/go-sqlite3"
)

// Принудительный сброс всех фреймов WAL в основной файл базы
func performAggressiveCheckpoint(db *sql.DB) error {
    var busy, logFrames, checkpointedFrames int

    // Вызов контрольной точки каждые 250 миллисекунд
    row := db.QueryRow("PRAGMA wal_checkpoint(TRUNCATE);")
    if err := row.Scan(&busy, &logFrames, &checkpointedFrames); err != nil {
        return fmt.Errorf("ошибка чекпоинта: %w", err)
    }

    log.Printf("Чекпоинт завершен: занято=%d, фреймов_в_wal=%d, перенесено=%d",
        busy, logFrames, checkpointedFrames)

    // Проверка целостности файла после операции
    var integrityResult string
    if err := db.QueryRow("PRAGMA integrity_check;").Scan(&integrityResult); err != nil {
        return fmt.Errorf("сбой integrity_check: %w", err)
    }
    if integrityResult != "ok" {
        return fmt.Errorf("обнаружено повреждение базы: %s", integrityResult)
    }
    return nil
}
Координационный сервер вызывал PRAGMA wal_checkpoint(TRUNCATE) каждые 250 миллисекунд — четыре раза в секунду. То, что в обычных приложениях происходило раз в несколько часов, здесь повторялось миллионы раз в сутки под непрерывным потоком параллельных транзакций. Tailscale непреднамеренно создала идеальный стресс-тест для самых редких состояний гонки.
Микросекундная гонка при циклическом сбросе заголовка
В ходе совместного расследования инженера Tailscale Алекса Чана и создателя SQLite Ричарда Хиппа выяснилась точная последовательность событий, разрушающая базу данных:
- Чекпоинтер считывает страницы из WAL и переносит их в основной файл. Все фреймы скопированы.
- Чекпоинтер готовится перезагрузить заголовок WAL (WAL header reset), чтобы объявить журнал пустым. Для этого он меняет счетчик поколений (generation counter) в разделяемой памяти.
- В этот крошечный интервал времени (буквально несколько микросекунд) параллельный поток Go-писателя начинает новую транзакцию.
- Писатель видит, что чекпоинт завершился, и записывает новую страницу данных в первый фрейм журнала WAL, инкрементируя внутренний счетчик.
- Чекпоинтер просыпается, чтобы завершить свою работу. Но из-за неверной проверки граничных условий в коде SQLite он считывает уже обновленный счетчик писателя и ошибочно полагает, что этот свежий фрейм относился к старому, уже скопированному циклу.
- В результате контрольная точка сообщает операционной системе, что фрейм обработан, хотя физической записи на диск не было. При следующем усечении журнала свежие данные исчезают, а ссылки в B-дереве базы остаются указывать в пустоту.
Виртуальная файловая система: как tmstmpvfs поймала дефект
Поскольку воспроизвести ошибку в лабораторных условиях не удавалось (гонка требовала уникального совпадения таймингов системных вызовов), команда SQLite разработала специализированный отладочный инструмент — прослойку виртуальной файловой системы tmstmpvfs shim.
Архитектура SQLite абстрагирована от файловой системы операционной системы через интерфейс Virtual File System (VFS). Специальный отладочный shim перехватывал все системные вызовы ввода-вывода и протоколировал время захвата файловых блокировок с наносекундной точностью:
#include <sqlite3.h>
#include <stdio.h>

/* Отладочный перехватчик системных вызовов VFS для фиксации гонки */
static int traceWalWrite(sqlite3_file *pFile, const void *pBuf, int iAmt, sqlite3_int64 iOfst) {
    if (iOfst == 0 && iAmt >= 32) {
        /* Фиксация момента перезаписи заголовка WAL (WAL header reset) */
        fprintf(stderr, "[VFS TRACE] Сброс заголовка WAL: размер=%d смещение=%lld\n",
                iAmt, (long long)iOfst);
    }

    /* Делегирование стандартному системному драйверу ОС */
    return pFile->pMethods->xWrite(pFile, pBuf, iAmt, iOfst);
}
Через два месяца непрерывной работы в продакшене Tailscale отладочный код наконец поймал аномалию за руку: лог зафиксировал одновременную модификацию заголовка и инкремент фрейма. Теория подтвердилась фактами.
Хроника релизов и уроки для архитектуры распределенных систем
История исправления бага оказалась драматичной:
- Официальный патч был выпущен в версии SQLite 3.52.0. Однако вскоре выяснилось, что изменения затронули логику вычисляемых индексов (generated expression indexes), вызвав регрессию.
- Релиз 3.52.0 был спешно отозван разработчиками, а надежное исправление вошло в корректирующий выпуск SQLite 3.51.3.
- Полноценная стабилизация архитектуры индексов и внедрение механизмов самовосстановления состоялись в релизе SQLite 3.53.0.
Эта история преподносит важный инженерный урок: даже золотой стандарт надежности программного обеспечения имеет границы применимости. Агрессивное вмешательство в штатные механизмы библиотек (такие как принудительный чекпоинт каждые 250 мс) способно разбудить спящие дефекты в самом неожиданном месте. Если ваш сервис использует WAL-режим, избегайте непрерывного усечения журнала в высокочастотных циклах и обязательно запускайте регулярные фоновые проверки целостности баз данных.