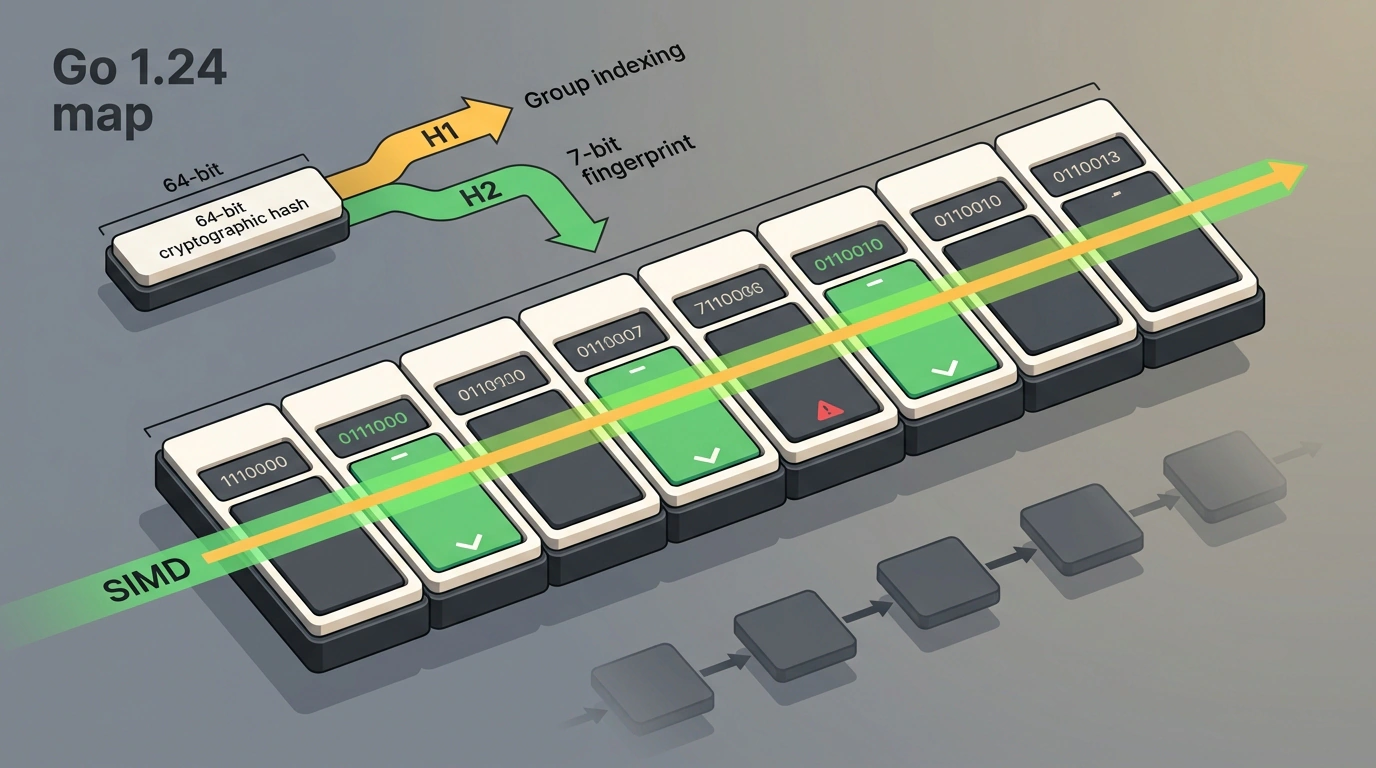

Встроенная хэш-таблица map в языке Go — одна из самых интенсивно используемых структур данных в современном серверном программировании. На ней построены кэши микросервисов, маршрутизаторы входящего трафика, парсеры протоколов и хранилища сессий. На протяжении более чем десяти лет ее базовая архитектура оставалась практически неизменной: цепочки фиксированных бакетов по восемь элементов и списки переполнения.
Однако с выходом релиза Go 1.24 под капотом рантайма произошла тихая революция. Команда языка полностью переписала ядро map, внедрив адаптацию архитектуры Swiss Tables. В синтетических тестах и микросервисных бенчмарках скорость операций поиска и вставки выросла на величину до 60%, а средняя нагрузка на центральный процессор сократилась на 1.5%.
Разберем, почему старый механизм исчерпал свои возможности и как векторные инструкции современных процессоров изменили принципы работы с хэш-таблицами.
Наследие старых бакетов и проблема переполнения
Чтобы оценить масштаб изменений, стоит вспомнить, как была устроена карта в версиях с Go 1.0 по Go 1.23.
Таблица состояла из массива бакетов. Каждый бакет вмещал строго восемь пар «ключ-значение» и массив из восьми верхних байтов хэша (tophash). Когда девятый элемент попадал в тот же бакет из-за коллизии, рантайм выделял в динамической памяти дополнительный бакет переполнения (overflow bucket) и связывал их в односвязный список.
У этой схемы было три фундаментальных архитектурных недостатка:
- Промахи кэша процессора (cache misses): обход цепочки переполнения требует перехода по указателям в разные области оперативной памяти. Процессор вынужден простаивать в ожидании подгрузки строк кэша;
- Линейный перебор: поиск нужного ключа внутри бакета последовательно перебирал все восемь значений tophash;
- Неэффективное использование памяти: если в бакете занят всего один слот, остальные семь ячеек простаивают, искусственно раздувая объем аллокаций.
Анатомия Swiss Tables: контрольные байты и группы по восемь слотов
Концепция Swiss Tables (швейцарских таблиц) была изначально разработана инженерами Google Мэттом Куликом и Ченг-Цунгом Сяо для библиотеки C++ Abseil. Позже ее варианты доказали свое превосходство в языке Rust (библиотека hashbrown и стандартная HashMap).
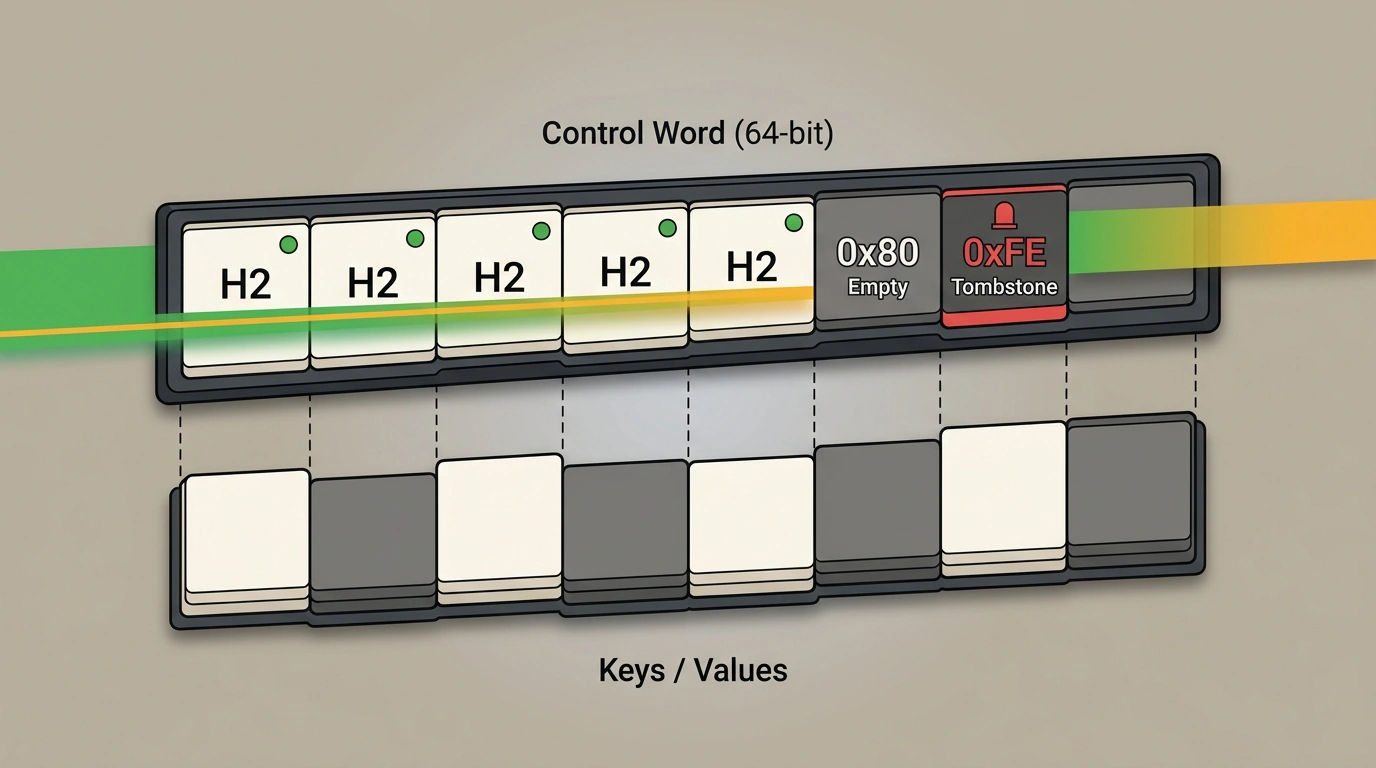
Главный принцип Swiss Tables — полное отделение управляющих метаданных от самих данных (ключей и значений).
Слоты таблицы объединяются в группы по восемь штук. Каждому слоту соответствует ровно один контрольный байт (control byte). Восемь контрольных байтов группы выравниваются в памяти и образуют единое 64-битное контрольное слово (control word).
Контрольный байт может находиться в одном из состояний:
- Занятый слот: старший бит равен 0, а младшие 7 бит содержат отпечаток хэша ключа (H2);
- Пустой слот: байт равен специальному значению
10000000(0x80); - Удаленный элемент (надгробный камень, tombstone): байт равен
11111110(0xFE). Он указывает, что ячейка свободна для новой записи, но цепочка поиска при чтении не должна здесь прерываться.
Разделение хэша: старший индекс H1 и 7-битный отпечаток H2
Когда программа обращается к карте m[key], рантайм Go вычисляет 64-битный хэш ключа с добавлением уникальной рандомизированной соли (seed), создаваемой для каждой карты для защиты от атак HashDoS.
Затем 64-битное число мгновенно разделяется на две непересекающиеся части:
package main

import (
    "fmt"
)

// Вычисление компонент H1 и H2 из 64-битного хэша ключа
func splitHash(hash uint64) (h1 uint64, h2 uint8) {
    // Старшие 57 бит определяют начальную группу слотов
    h1 = hash >> 7
    // Младшие 7 бит образуют компактный отпечаток для контрольного байта
    h2 = uint8(hash & 0x7F)
    return h1, h2
}

func main() {
    sampleHash := uint64(0x4f8b2a19e3779b15)
    h1, h2 := splitHash(sampleHash)
    fmt.Printf("Исходный хэш: %x\n", sampleHash)
    fmt.Printf("Индекс группы (H1): %d\n", h1)
    fmt.Printf("Отпечаток контрольного байта (H2, 7 бит): %07b (hex: %02x)\n", h2, h2)
}
Старшие 57 бит (H1) определяют номер группы в массиве слотов. Младшие 7 бит (H2) помещаются в контрольный байт.
Вероятность того, что два совершенно разных ключа случайно совпадут по 7-битному значению H2, составляет всего 1/128 (менее 1%). Это дает колоссальное преимущество при фильтрации.
Векторная фильтрация: почему SIMD побеждает линейный перебор
В старой версии Go цикл последовательно сравнивал байты tophash один за другим. В Swiss Tables поиск внутри группы выполняется параллельно за один такт процессора с помощью векторных инструкций SIMD (Single Instruction, Multiple Data).
Рантайм берет 7-битный отпечаток H2 и дублирует его восемь раз, формируя 64-битный вектор. Затем процессорная инструкция (например, vpcmpeqb на архитектуре x86-64 или векторное сравнение на ARM64) сравнивает этот вектор со всем 64-битным контрольным словом группы разом.
В результате процессор возвращает битовую маску, где единицы стоят только на тех позициях, где отпечаток совпал.
Если маска пуста, рантайм мгновенно переходит к следующей группе, не прочитав из памяти ни одного ключа! Дорогостоящая операция полного сравнения ключей через интерфейсный оператор == вызывается исключительно для единичных битов совпавшей маски. Промахи кэша сокращаются до минимума.
При возникновении коллизий между группами Swiss Tables в Go использует треугольное пробирование (triangular probe sequence) со смещениями +1, +2, +3... групп, что предотвращает эффект скучивания занятых ячеек.
Расширяемое хэширование и защита от латентных пауз
В реализациях Swiss Tables для C++ или Rust при заполнении таблицы происходит полная переаллокация: выделяется буфер вдвое большего размера, и все элементы разом копируются на новые места. Для сетевых микросервисов на Go с миллионами записей такая пауза означала бы резкий скачок задержки ответа (latency spike), недопустимый в высоконагруженных системах.
Чтобы сохранить фирменную плавность сборки мусора и предсказуемость задержек, инженеры Go соединили Swiss Tables с расширяемым хэшированием (extendible hashing).
Таблица не растет бесконечно как единый массив. Она разбивается на подтаблицы, размер которых жестко ограничен максимумом в 128 групп (1024 слота).
Управление подтаблицами осуществляется через специальный каталог (directory):
- Пока элементов мало, карта состоит из одной таблицы;
- При переполнении каталог удваивает число указателей, а переполненная подтаблица делится ровно пополам;
- Перемещение данных происходит инкрементально, микропорциями, не подвешивая горутины длительными паузами.
Практические выводы для бэкенд-разработки на Go
Для рядового разработчика переход на Go 1.24 не требует переписывания кода: синтаксис map[K]V остался абсолютно неизменным. Однако понимание новой архитектуры дает важное практическое правило: предвыделение емкости при вызове make стало еще эффективнее.
Если вы заранее знаете примерный размер карты, указание хинта емкости избавляет рантайм от построения директории подтаблиц и перераспределения групп:
package main

import (
    "testing"
)

// Сравнение производительности вставки с хинтом емкости и без него
func BenchmarkMapPopulation(b *testing.B) {
    b.Run("Без предварительного выделения емкости", func(b *testing.B) {
        for i := 0; i < b.N; i++ {
            m := make(map[int]int)
            for j := 0; j < 1024; j++ {
                m[j] = j
            }
        }
    })

    b.Run("С предвыделенной емкостью под Swiss Tables", func(b *testing.B) {
        for i := 0; i < b.N; i++ {
            // Емкость 1024 идеально ложится в лимит подтаблицы из 128 групп
            m := make(map[int]int, 1024)
            for j := 0; j < 1024; j++ {
                m[j] = j
            }
        }
    })
}
Обновление map в Go 1.24 — яркий пример того, как глубокая алгоритмическая оптимизация ядра и грамотная утилизация аппаратных возможностей современных CPU повышают общую производительность всей экосистемы без нарушения обратной совместимости.