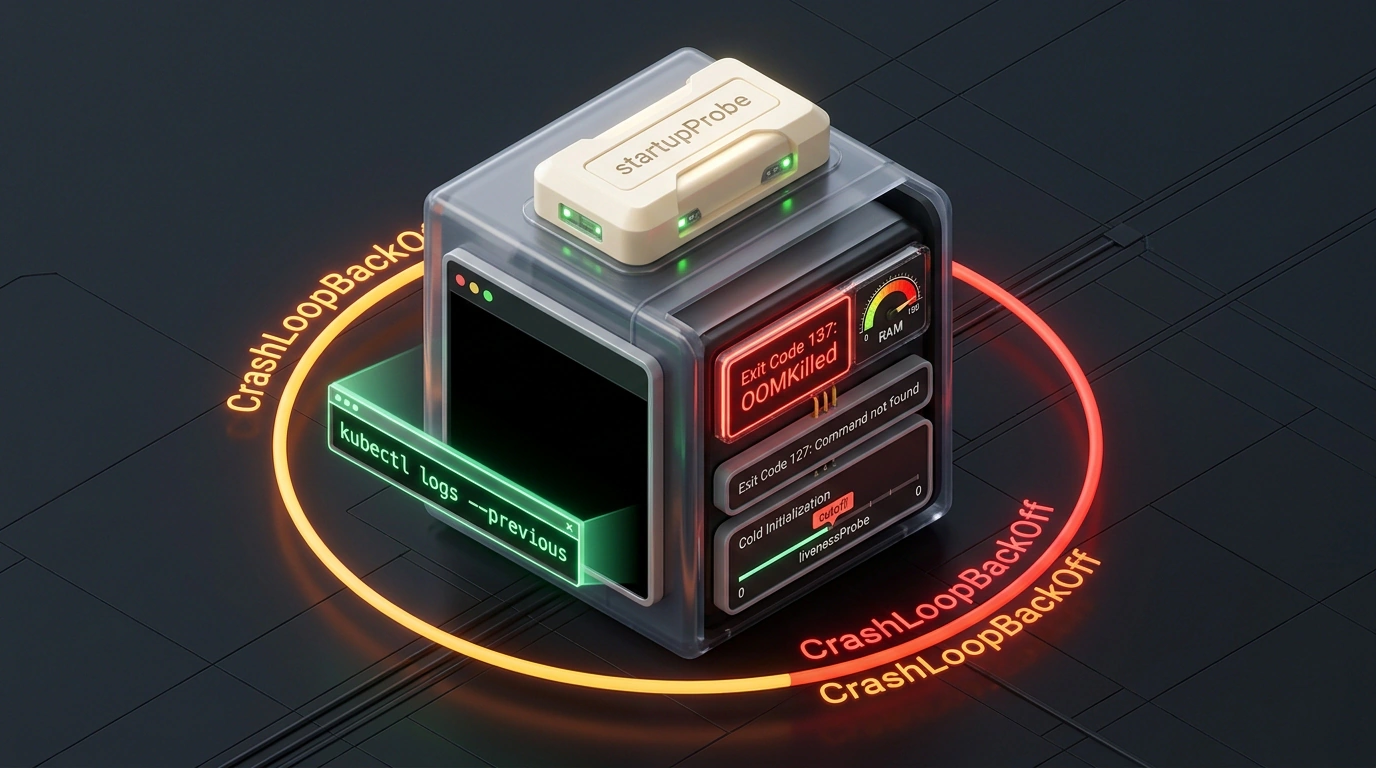

Статус CrashLoopBackOff в Kubernetes знаком каждому инженеру: контейнер внутри пода завершился с ошибкой, среда исполнения попыталась его перезапустить, процесс снова упал, и Kubelet включил экспоненциальную паузу перед следующей попыткой (от 10 до 300 секунд). Стандартный рефлекс разработчика — сразу набрать kubectl logs <pod-name>.
Однако в самый неподходящий момент команда возвращает зловещую пустоту. Отсутствие логов нередко провоцирует панику и ложные гипотезы: инженеры начинают грешить на сбой кластерного демона Fluentd, перегрузку ноды или спонтанно пересоздают весь Deployment.
На самом деле пустой вывод логов — это не технический сбой подсистемы логирования, а четкий диагностический маркер. Он сообщает, что процесс контейнера либо не успел дойти до точки вывода в стандартные потоки, либо был мгновенно уничтожен ядром операционной системы, либо опрашивается совершенно не тот экземпляр.
Четыре сценария аварии: от прав доступа до OOM Killer
Практика эксплуатации кластеров сводит проблему к четырем типовым первопричинам:
- Опрос пустого рестарта: команда
kubectl logsпо умолчанию подключается к текущему, только что созданному экземпляру контейнера. Если процесс падает в первые миллисекунды, свежий экземпляр просто пуст. - Отказ на уровне ядра ОС (Exit Code 126 / 127): процесс вообще не запустился. Приложение на Node.js, Go или Python даже не начало инициализацию, поэтому физически некому было отправить байты в
stdout. Это происходит из-за опечатки в директивахcommand/args, отсутствия скомпилированного бинарника в минималистичном образе (Alpine без musl) или отсутствия прав на исполнение (chmod +x). - Убийство агрессивной liveness-пробой: приложению требуется время на холодный старт (прогрев кэшей, применение миграций, инициализация пула соединений). Если проверка жизнеспособности
livenessProbeнастроена без достаточного запаса времени, Kubelet считает сервис зависшим и принудительно убивает его сигналом SIGKILL до того, как приложение сформирует лог готовности. - Уничтожение через OOM Killer (Exit Code 137): при попытке мгновенно выделить буфер памяти, превышающий лимит
resources.limits.memory, ядро Linux немедленно шлет процессу сигнал 9 (SIGKILL). Буферы вывода сбрасываются мгновенно, не успевая попасть в лог-файл ноды.
Диагностический протокол: извлечение истории через --previous
Вместо хаотичных попыток перезапуска инженеру достаточно выполнить четкую последовательность терминальных команд, локализующую сбой за полминуты:
# 1. Чтение логов завершившегося (предыдущего) экземпляра контейнера
kubectl logs payment-service-7d89b-4k9lz -c app --previous

# 2. Инспекция блока Last State и кодов завершения в манифесте пода
kubectl describe pod payment-service-7d89b-4k9lz | grep -A 8 "Last State:"

# 3. Фильтрация системных событий планировщика и проб пода
kubectl get events --field-selector involvedObject.name=payment-service-7d89b-4k9lz --sort-by='.metadata.creationTimestamp'
Флаг --previous (-p) обращается напрямую к драйверу контейнеров (containerd/CRI-O) на рабочей ноде и читает сохраненный лог предшествующей инкарнации. Если в блоке Last State зафиксирован статус OOMKilled с кодом 137, причина однозначно в нехватке оперативной памяти. Код 127 указывает на Command not found, а события Unhealthy: Liveness probe failed требуют пересмотра политики проверки жизнеспособности.
Защита медленного старта: настройка startupProbe в манифесте
Если причиной циклического падения выступает конфликт со временем старта, решение заключается во внедрении пробы запуска startupProbe. Пока эта проба не завершится успехом, проверки livenessProbe и readinessProbe остаются полностью заблокированными.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: payment-service
spec:
  replicas: 2
  template:
    spec:
      containers:
      - name: app
        image: payment-service:v1.4.0
        resources:
          requests:
            memory: "512Mi"
            cpu: "250m"
          limits:
            memory: "1024Mi"
            cpu: "1000m"
        # startupProbe дает приложению до 150 секунд на инициализацию (30 * 5с)
        startupProbe:
          httpGet:
            path: /healthz/startup
            port: 8080
          failureThreshold: 30
          periodSeconds: 5
        # livenessProbe включается только после успешного завершения startupProbe
        livenessProbe:
          httpGet:
            path: /healthz/liveness
            port: 8080
          periodSeconds: 10
          failureThreshold: 3
Такое разделение защищает долго инициализирующиеся сервисы от ложного циклизма перезапусков, снижает среднее время восстановления (MTTR) и гарантирует стабильность инфраструктуры.