

Если ты хоть раз в жизни строил корпоративное хранилище данных или озеро на сотни терабайтов, то наверняка помнишь этот холодный пот: три часа ночи, сложный ETL-скрипт упал на обновлении пятой витрины из десяти, а в восемь утра руководство открывает дашборды. Половина данных обновилась, вторая половина осталась вчерашней, финансовый баланс не сходится, и в панике приходится вручную откатывать паркет-файлы в S3.
В классических реляционных СУБД нас спасает транзакция: BEGIN TRANSACTION ... COMMIT. Если произошел сбой — база просто откатит состояние, и читатели даже не заметят промежуточного мусора. Но когда твои данные лежат распределенно в облачном объектном хранилище в формате Apache Parquet, традиционные транзакции долгое время оставались несбыточной мечтой.
Появление форматов таблиц вроде Apache Iceberg и Delta Lake сделало огромный шаг вперед: появились снепшоты и изоляция на уровне одной таблицы. Но что делать, если пайплайн обновляет сразу десять взаимосвязанных таблиц? Как гарантировать, что аналитики не увидят «разорванное» состояние?
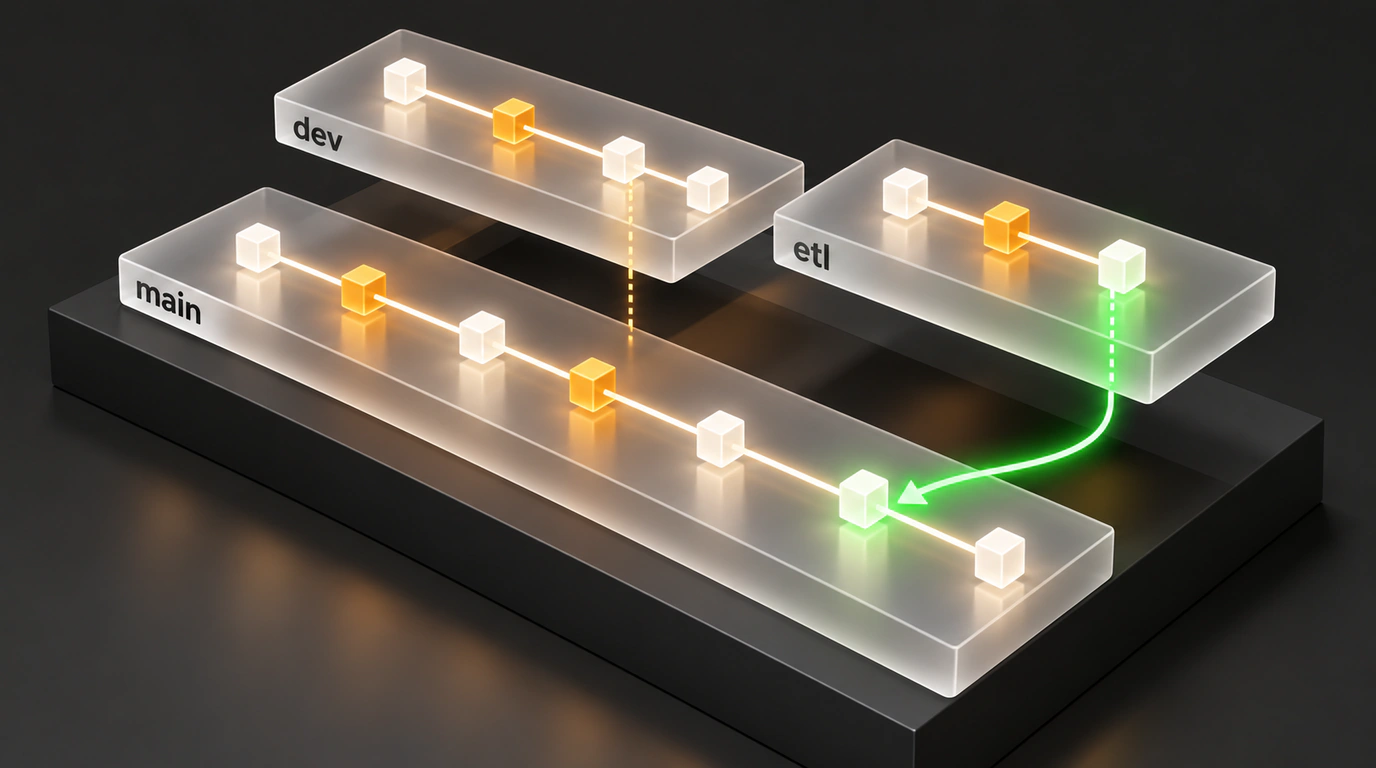
Здесь на сцену выходит проект с открытым исходным кодом Apache Nessie, реализующий концепцию «Git-for-Data» для архитектуры Lakehouse. Давай разберем, как он устроен под капотом и почему он меняет правила игры в инженерии данных.
Проблема грязного чтения в озерах данных
Чтобы понять ценность Nessie, вспомни, как обычно решается проблема изоляции ETL:
- Двойная буферизация (Staging Schemas): данные пишутся во временную схему, а затем хитрыми скриптами переименовываются или заменяются через
ALTER TABLE ... SWAP WITH. Это громоздко, ломает права доступа и часто не поддерживается распределенными движками. - Флаги готовности: в базу пишется признак
is_ready = false, а все аналитические запросы обязаны фильтровать по нему. Стоит одному джуниору забытьWHERE is_ready, и на графиках появляется мусор. - Прямая запись на живую: самая опасная стратегия, когда промежуточные данные видны всем читателям прямо во время вставки.
Когда Skillbox проводил миграцию корпоративного хранилища данных на Trino, Iceberg и S3, они на практике столкнулись с необходимостью выстраивать надежную консистентность между сотнями аналитических потоков. Nessie решает именно эту боль, выступая центральным каталогом метаданных с поддержкой веток и коммитов.
Как устроен Nessie под капотом: Zero-Copy ветвление
Главная магия Apache Nessie заключается в том, что он вообще не копирует физические файлы данных.
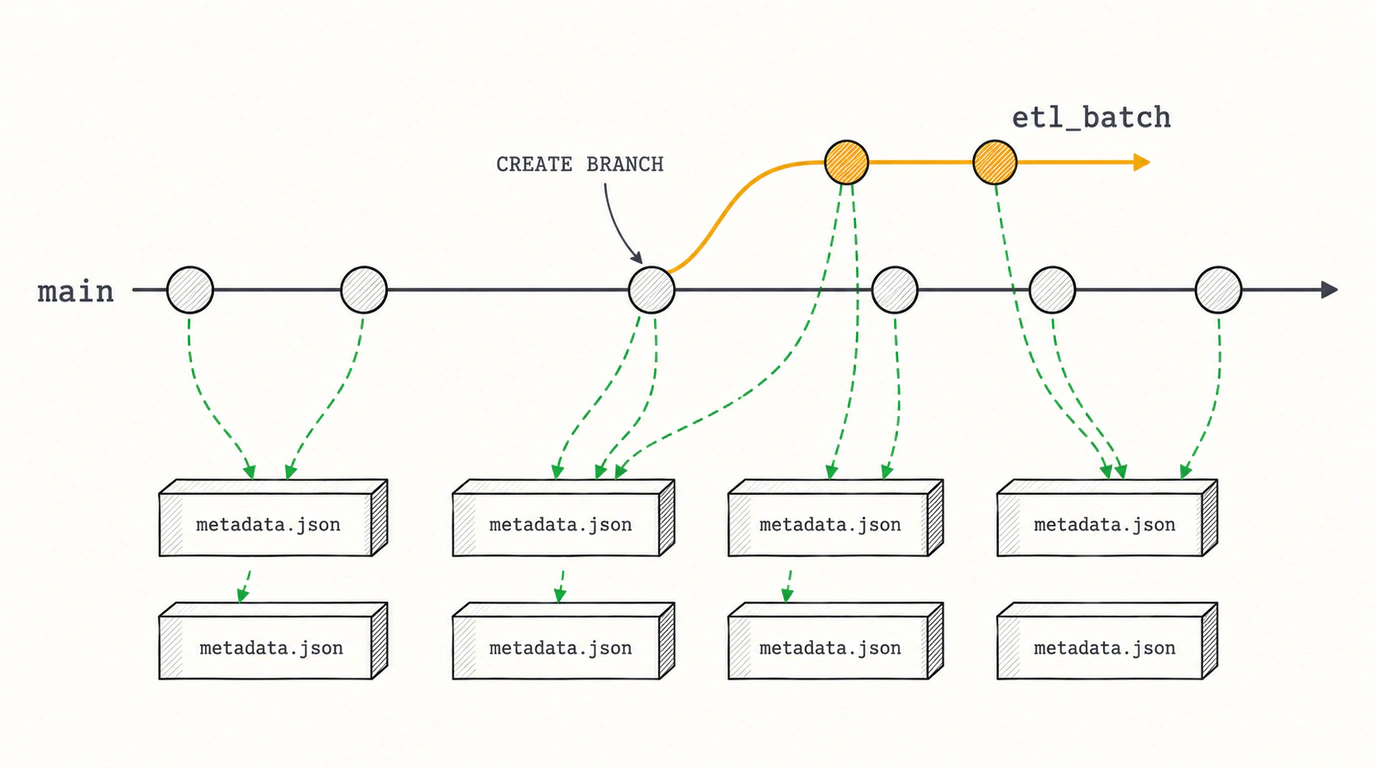
Когда ты создаешь ветку в Git, система не создает копию всего твоего жесткого диска. Git просто создает легковесный указатель на конкретный коммит в графе истории. Nessie делает ровно то же самое, но не для исходного кода, а для метаданных таблиц Iceberg:
- Каталог как дерево контента: Nessie хранит дерево ссылок на манифесты таблиц (
metadata.json). Каждая таблица идентифицируется ключом содержимого (ContentKey). - Zero-Copy Branch: операция
CREATE BRANCH etl_batch FROM mainвыполняется за несколько миллисекунд. В базе каталога создается именованная ссылка на текущий корневой снимок. Терабайты и петабайты Parquet-файлов в бакете S3 остаются на месте. - Изолированные коммиты: пока твой ETL-процесс пишет новые паркеты и генерирует метаданные Iceberg, все изменения привязываются исключительно к ветке
etl_batch. Запросы к веткеmainфизически не видят этих коммитов.
Внутри самого Nessie история коммитов организуется в направленный ациклический граф (DAG). В качестве постоянного бэкенда хранения метаданных каталога Nessie поддерживает PostgreSQL, DynamoDB, RocksDB или распределенные In-Memory структуры.
Практика: ветвление и атомарный мерж в SQL
Давай посмотрим, как выглядит реальная работа с Nessie через Spark SQL или Trino. Благодаря поддержке синтаксиса ссылок Nessie, управление версиями данных происходит буквально в несколько стандартных команд:
-- 1. Создаем изолированную ветку для ночного расчета перед стартом ETL
CREATE BRANCH etl_nightly_sales IN nessie FROM main;

-- 2. Переключаем сессию на работу в созданной ветке
USE REFERENCE etl_nightly_sales IN nessie;

-- 3. Выполняем тяжелые расчеты и обновления витрин
-- Вся запись идет в бакет S3, но в каталоге изменения видны ТОЛЬКО в нашей ветке
INSERT INTO analytics.orders_summary
SELECT
    customer_id,
    date_trunc('day', order_date) AS order_day,
    sum(amount) AS total_spent
FROM raw_stage.orders
WHERE order_date >= '2026-10-21'
GROUP BY 1, 2;

-- 4. Обновляем метрики клиентов в соседней таблице
UPDATE analytics.customer_profiles
SET loyalty_tier = 'Gold'
WHERE total_spent > 100000;
Заметь: в этот самый момент BI-дашборды подключены к ветке main. Ни один аналитик не видит полупустую таблицу orders_summary и не получает ошибок блокировки таблиц.
Когда ETL успешно завершил расчеты и выполнил тесты качества данных (например, через Great Expectations), наступает момент публикации:
-- 5. Возвращаемся в основную ветку и выполняем слияние
USE REFERENCE main IN nessie;

-- Атомарный мерж сразу нескольких таблиц в прод!
MERGE BRANCH etl_nightly_sales INTO main IN nessie;
Операция MERGE BRANCH выполняется атомарно. Указатель ветки main сдвигается на коммит слияния. Для всех читателей новые версии обеих таблиц появляются одновременно в одну и ту же миллисекунду.
Конфликты параллельной записи и стратегии слияния
А что произойдет, если пока наш длинный ETL-пайплайн считал витрины, кто-то успел записать данные в main?
Nessie использует оптимистичную блокировку (Optimistic Concurrency Control, OCC). При слиянии поддерживаются две базовые стратегии:
- Fast-Forward Merge: если ветка
mainне ушла вперед с момента создания нашей рабочей ветки, указательmainпросто переносится на верхушку нашей ветки. Никаких дополнительных коммитов не создается. - Three-Way Merge: если в
mainпоявились новые коммиты, Nessie сравнивает базовый общий предок, целевую ветку и ветку-источник. Если коммиты затрагивали разные таблицы (например, ночной ETL обновлялorders_summary, а стриминг обновлялclickstream), слияние проходит автоматически без конфликтов.
Если же оба процесса попытались изменить одну и ту же таблицу, Nessie заблокирует операцию и выдаст ошибку конфликта, защитив озеро от неконсистентности.
Подводные камни и сборка мусора
Звучит идеально, но в продакшене у любого красивого архитектурного решения есть цена. И в случае с Nessie эта цена — управление жизненным циклом файлов в хранилище.
Поскольку создание веток стоит дешево, инженеры часто создают десятки веток под эксперименты, забывая их удалять. Каждая ветка держит ссылки на определенные снимки Iceberg. В результате сборщик мусора Iceberg (expire_snapshots) не может удалить старые файлы данных из S3, так как на них все еще ссылается забытая ветка двухмесячной давности.
Чтобы избежать раздувания счетов за облачное хранилище, в команде важно сразу внедрить два правила:
- Настроить TTL для временных веток и автоматически удалять ветки завершенных ETL-задач.
- Регулярно запускать Nessie GC (Garbage Collection), который находит файлы, недостижимые ни из одной живой ветки или тега, и безопасно стирает их из S3.
В сухом остатке Apache Nessie превращает озеро данных из дикого поля с паркетами в строгую, предсказуемую и транзакционную платформу, где откат ошибки — это просто RESET REFERENCE, а не бессонная ночь ручного восстановления.