
Исторически язык Go придерживался философии подчеркнутой простоты: разработчик пишет понятный код на чистом Go, а компилятор старается эффективно превратить его в машинные инструкции. Однако в задачах обработки больших данных, парсинга JSON, криптографии, поисковых индексов и мультимедиа скалярная обработка данных неизбежно упирается в физический потолок производительности одного ядра.
Долгое время единственный способ выжать максимум из современного процессора в Go заключался в написании ассемблерных файлов Plan 9 (.s). Но ассемблер в Go несет огромную цену: вызовы функций перестают инлайниться компилятором, ломается статический анализ линтеров, а поддержка нескольких архитектур (x86_64, ARM64, WebAssembly) превращается в бесконечную головную боль с генерацией кода сторонними утилитами.
В готовящемся релизе Go 1.27 команда языка под руководством Джуньяна Шао (Junyang Shao) и Дэвида Чейза (David Chase) сделала огромный шаг вперед. Экспериментальный API векторных инструкций получил полноценную поддержку архитектур ARM64 и WebAssembly.
Ранее мы обсуждали, как развивался портативный SIMD в Go 1.27 для общих алгоритмов. Теперь же разработчики получают доступ к низкоуровневому пакету simd/archsimd, позволяющему вызывать аппаратные интринсики конкретного процессора прямо из стандартного Go-кода.
Двухуровневая модель: переносимость против предельной скорости
Чтобы угодить обеим категориям разработчиков — тем, кому нужна максимальная портативность, и тем, кто борется за каждый такт процессора, — архитекторы Go создали двухуровневую систему:
- Высокоуровневый пакет
simd: предоставляет переносимые математические и логические операции (по концепции схожие с C++ библиотекой Google Highway). Ты пишешь один векторный алгоритм, и он компилируется под любой процессор, где есть векторные регистры. - Низкоуровневый пакет
simd/archsimd: дает прямой доступ к аппаратным возможностям конкретного чипа. Если на сервере доступен AVX-512, NEON или Wasm SIMD, ты можешь обращаться к специализированным инструкциям через типизированные методы.
Экспериментальный пакет активируется специальным флагом сборки:
GOEXPERIMENT=simd go build
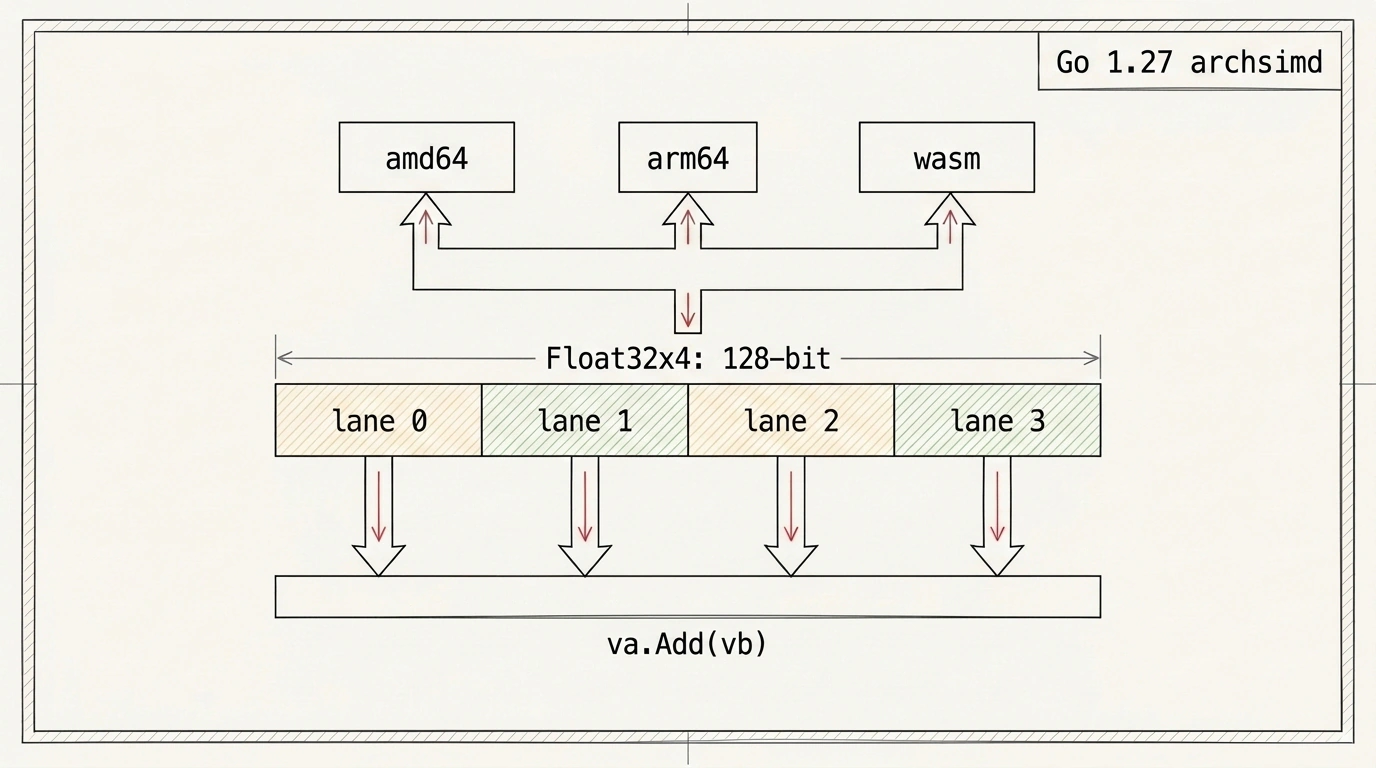
В Go 1.27 поддержка archsimd охватывает уже три ключевые платформы:
amd64— векторные расширения SSE, AVX2 и AVX-512;arm64— 128-битные векторные инструкции ARM NEON (с архитектурным заделом под масштабируемые векторные расширения SVE и SVE2);wasm— стандартизированный 128-битный векторный профиль WebAssembly SIMD.
Строгая типизация и нормализация имен инструкций
В языках вроде C или C++ работа с интринсиками традиционно пугает новичков чудовищными названиями функций из заголовочных файлов, например _mm512_mask_add_ps или _mm256_shuffle_epi8. В Go инженеры подошли к проектированию API со свойственной языку строгостью и лаконичностью.
Векторы представлены строго типизированными структурами с фиксированным размером:
Float32x4— четыре 32-битных числа с плавающей точкой (128 бит);Int32x8— восемь 32-битных целых чисел (256 бит);Uint8x16— шестнадцать байт (128 бит).
Все операции оформлены как методы структур. Например, сложение двух векторов независимо от целевой платформы всегда записывается как va.Add(vb). Вместо криптографических названий инструкций компилятора используются понятные глаголы: сдвиг элементов называется ShiftAllLeft, побитовое умножение — And, а поиск минимума — Min.
Компилятор Go выполняет глубокие peephole-оптимизации. Если ты пишешь цепочку va.Add(vb).Masked(m), оптимизатор схлопывает сложение и наложение битовой маски в одну аппаратную инструкцию с предикатом (например, VPADD на AVX-512).
Кроме того, обеспечено бесплатное приведение типов (zero-cost bitcast). Методы вроде ToBits(), ReshapeToUint32s() или BitsToFloat32() меняют логическую интерпретацию данных в векторном регистре компилятора мгновенно, без единой ассемблерной инструкции копирования памяти.
Тонкие различия семантики: PermuteOrZero против LookupOrZero
Самый захватывающий аспект исследования пакета simd/archsimd — то, как разработчики Go справились с расхождениями в поведении различных процессоров при обработке граничных условий (boundary semantics).
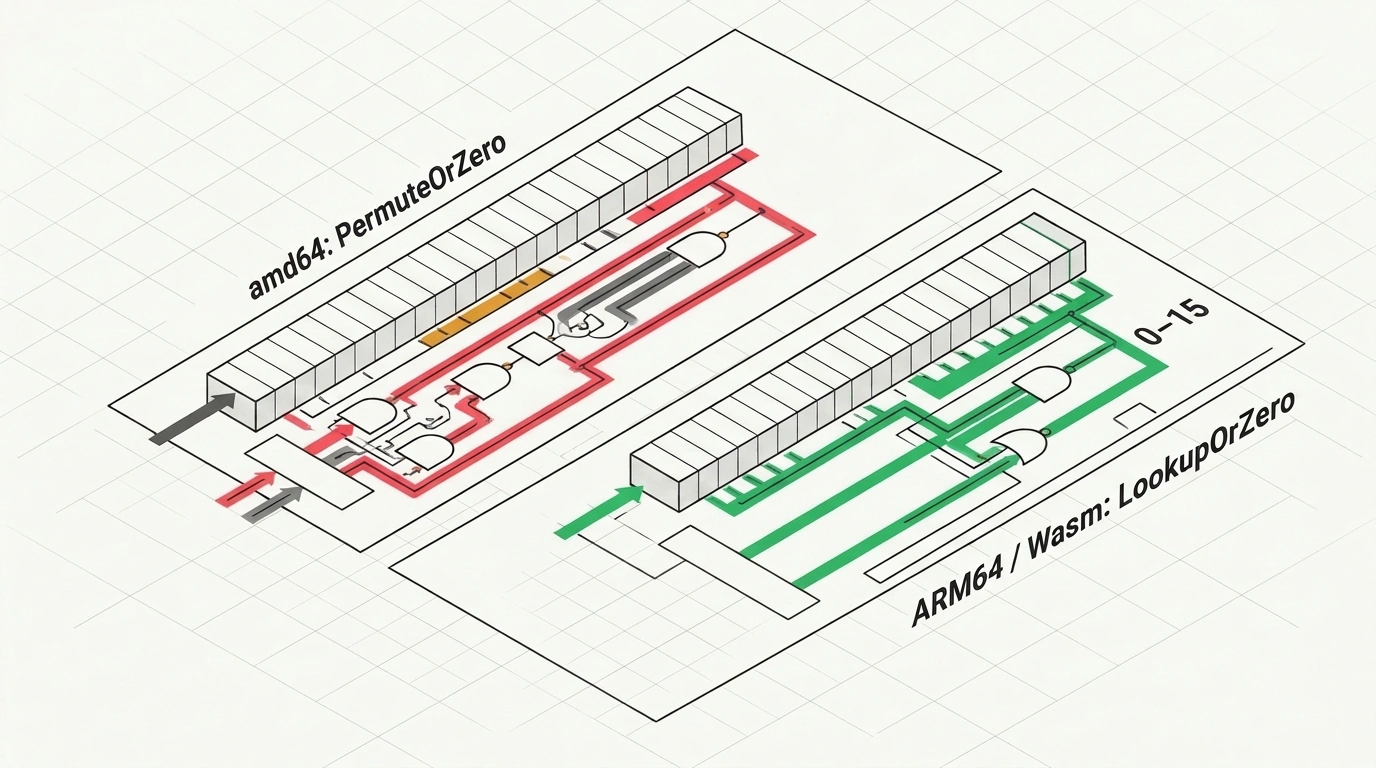
Классический пример: операция табличной перестановки шестнадцати байт по индексам. В процессорах Intel x86_64 инструкция VPSHUFB при выходе индекса за пределы таблицы ведет себя асимметрично: если старший бит индекса равен единице (отрицательное число), результирующий байт обнуляется; если же индекс положительный, но больше 15, процессор просто берет остаток от деления на 16. В Go для архитектуры amd64 эта операция получила точное имя PermuteOrZero.
На процессорах ARM64 в наборе инструкций NEON аналогичная операция выполняется командой VTBL. Но она устроена строже: если индекс выходит за диапазон от 0 до 15 (как в большую, так и в меньшую сторону), результирующий байт всегда обнуляется. Ровно так же ведет себя и инструкция i8x16.swizzle в WebAssembly.
Чтобы разработчик случайно не получил скрытый баг при переносе алгоритма с сервера x86_64 на Mac с чипом Apple Silicon или в браузерный WebAssembly, в Go для ARM64 и Wasm эта операция названа иначе — LookupOrZero. Разные имена заставляют программиста явно осознавать платформенную специфику.
А для инструкций AMD64, работающих изолированно внутри независимых 128-битных полос (lanes) внутри широких 256-битных или 512-битных регистров, добавлен суффикс Grouped (например, PermuteOrZeroGrouped).
//go:build goexperiment.simd

package main

import (
    "fmt"
    "simd/archsimd"
)

// VectorAdd выполняет параллельное покомпонентное сложение двух срезов float32
func VectorAdd(a, b, result []float32) {
    n := len(a)
    i := 0

    // Основной цикл: обрабатываем по 4 элемента за одну векторную итерацию
    for ; i+4 <= n; i += 4 {
        va := archsimd.LoadFloat32x4(a[i:])
        vb := archsimd.LoadFloat32x4(b[i:])
        vr := va.Add(vb)
        vr.Store(result[i:])
    }

    // Обработка хвоста среза, если длина массива не кратна 4
    if i < n {
        va, _ := archsimd.LoadFloat32x4Part(a[i:])
        vb, _ := archsimd.LoadFloat32x4Part(b[i:])
        vr := va.Add(vb)
        vr.StorePart(result[i:])
    }
}
Смотри, как лаконично выглядит обработка хвоста массива в примере выше. Функция LoadFloat32x4Part безопасно считывает оставшиеся элементы (от 1 до 3 чисел), дополняя оставшиеся слоты вектора нулями, а StorePart записывает обратно только фактически прочитанные байты, не повреждая чужую память за границами среза.
# Компиляция под архитектуру ARM64 (серверы Graviton или Apple Silicon)
GOEXPERIMENT=simd GOARCH=arm64 go build -o app-arm64 ./cmd/app

# Компиляция под WebAssembly для высокоскоростных вычислений в браузере
GOEXPERIMENT=simd GOOS=js GOARCH=wasm go build -o app.wasm ./cmd/app
Включение флага GOEXPERIMENT=simd не выполняет автоматическую векторизацию обычных циклов for. Разработчик обязан самостоятельно выстраивать алгоритм на векторных типах и обязательно предусматривать запасной скалярный путь исполнения для старых процессоров, где нужный набор инструкций отсутствует.
Где применять новый API на практике
Появление низкоуровневой векторизации в Go открывает колоссальные перспективы для инфраструктурного софта:
- Базы данных и аналитика: сканирование битовых масок, фильтрация колонок и агрегация миллионов числовых значений;
- Парсеры форматов: валидация символов UTF-8, поиск управляющих символов в JSON и разбор протоколов без побайтовых циклов;
- Криптография и хеширование: аппаратное ускорение алгоритмов хеширования и симметричного шифрования;
- WebAssembly: перенос высокопроизводительных вычислительных библиотек в браузерные приложения без использования C++ и Emscripten.
Практический итог
Эксперимент с пакетом simd/archsimd в Go 1.27 доказывает, что производительность и читаемость кода могут гармонично сосуществовать. Мы наконец получаем возможность выжимать из серверного железа все доступные терафлопсы, сохраняя при этом привычную экосистему инструментов Go, типобезопасность и радость от быстрой кросс-компиляции.