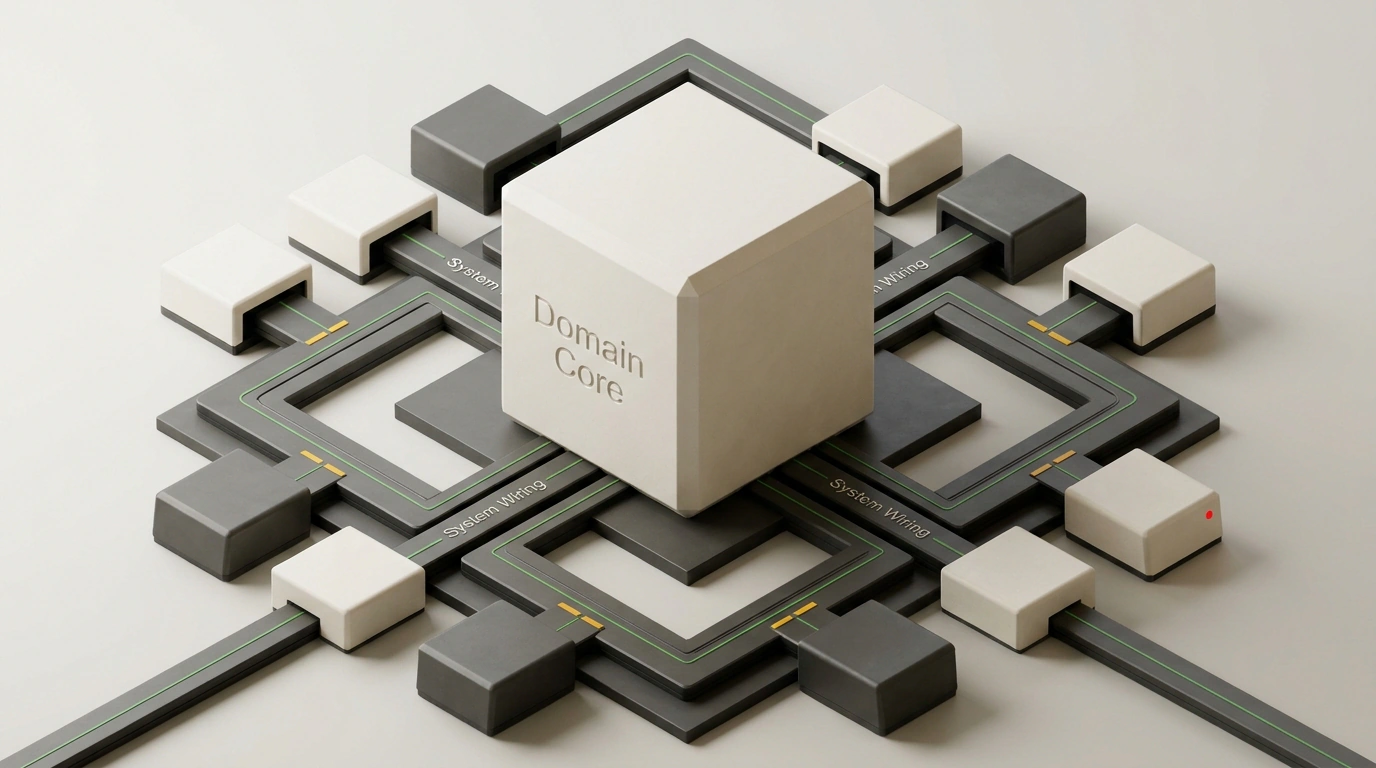

Каждый программист хотя бы раз в карьере переживал эту драму. Ты приходишь на новый проект: бодрый стартап пятилетней давности успел вырасти в прибыльную корпоративную платформу, бизнес процветает, штат инженеров разросся до сотни человек, а репозиторий разбух до миллиона строк кода. Но атмосфера в команде почему-то напоминает осажденную крепость.
Простейшая доработка — например, добавить одно поле скидки в расчет корзины покупателя — превращается в двухнедельное расследование с привлечением лидов трех отделов. Инженеры боятся трогать старые модули, потому что любое изменение отзывается каскадным падением совершенно несвязанных сервисов в продакшене. Сборка проекта падает из-за циклических зависимостей, юнит-тесты требуют трехсот строк инициализации моков, а время поставки изменений (Lead Time to Production) растет по экспоненте.
В индустрии принято винить во всем «нехватку микросервисов», «отсутствие чистой архитектуры» или банальный «технический долг». Но если заглянуть под капот реальных кодовых баз-гигантов, корень проблемы лежит глубже. Опыт Дмитрия Кмаладзе — ведущего системного архитектора крупных американских технологических корпораций, деконструированный в обстоятельной инженерной беседе с Тимуром Шемсединовым на канале HowProgrammingWorks, вскрывает фундаментальный кризис современного промышленного программирования.
Давай вместе разберем по винтикам, почему привычные паттерны объектно-ориентированного программирования и популярные фреймворки превращают миллионные кодовые базы в непроходимое болото, как выстроить архитектуру на строгом разделении бизнес-вычислений и системной коммутации, и почему этот подход сохраняет рассудок инженерам на горизонте десятилетий.
Кризис масштаба: почему фреймворки и тяжелый ООП ломаются на миллионе строк
В небольших проектах объемом в 10–50 тысяч строк кода инструменты вроде Spring Boot, NestJS или ASP.NET Core кажутся верхом инженерного изящества. Разработчик вешает аннотацию @Injectable(), объявляет в конструкторе контроллера сервис базы данных, ставит декоратор @Entity() над классом и получает работающее приложение за пару дней. Скорость выкатки первой версии зашкаливает.
Но когда кодовая база переваливает за 500 тысяч, а затем и за миллион строк кода, эта фреймворковая магия начинает беспощадно мстить. Возникают три системные ловушки:
- Неявная связность через транзитивные зависимости.
Классический ООП-подход поощряет инкапсуляцию поведения вместе с состоянием внутри классов. Класс
OrderServiceначинает импортироватьUserRepository,PaymentGateway,AuditLoggerиEmailNotificationService. Каждый из этих классов, в свою очередь, тянет за собой десятки других сервисов. В итоге в кодовой базе образуется не направленный ациклический граф (DAG), а гигантский плотный клубок, где каждый модуль косвенно связан с каждым. - Заложники технологического цикла фреймворка. Любой популярный веб-фреймворк живет по законам моды. В среднем раз в 3–5 лет фреймворк претерпевает кардинальную смену парадигмы: авторы объявляют старые API устаревшими (deprecated), меняют синтаксис декораторов или вовсе заменяют базовый рантайм. Если твои бизнес-правила (расчет налогов, списание балансов, проверка прав) жестко привязаны к классам, аннотациям и интерфейсам фреймворка, модернизация стека означает необходимость переписать весь миллион строк заново. В реальности этого никто не делает, и проект навсегда консервируется на уязвимой древней версии библиотеки.
- Размывание контекста предметной области. Взглянув на исходный код типичного класса enterprise-сервиса, ты увидишь гремучую смесь: здесь одновременно проверяется JWT-токен пользователя, открывается транзакция к PostgreSQL, логируется тело запроса в Elasticsearch, отправляется сообщение в топик Kafka и среди всего этого шума прячутся три строчки реальной математики расчета скидки. Мы детально исследовали эти механизмы деградации в статье Архитектурная эрозия: почему вайб-кодинг разрушает долгоживущие системы, где бесконтрольная генерация кода быстро умножала энтропию связей.
Когда бизнес-логика размазана тонким слоем по сетевым адаптерам и инфраструктурным вызовам, система теряет управляемость. Единственный способ вернуть контроль — провести жесткую границу на уровне архитектурного манифеста.
Разделение властей: чистый домен против системной коммутации (Wiring)
Главный инженерный постулат Дмитрия Кмаладзе звучит обманчиво просто: архитектура программного комплекса обязана на фундаментальном уровне разделять предметную вычислительную логику (Domain Logic) и системную коммутацию (System Wiring).
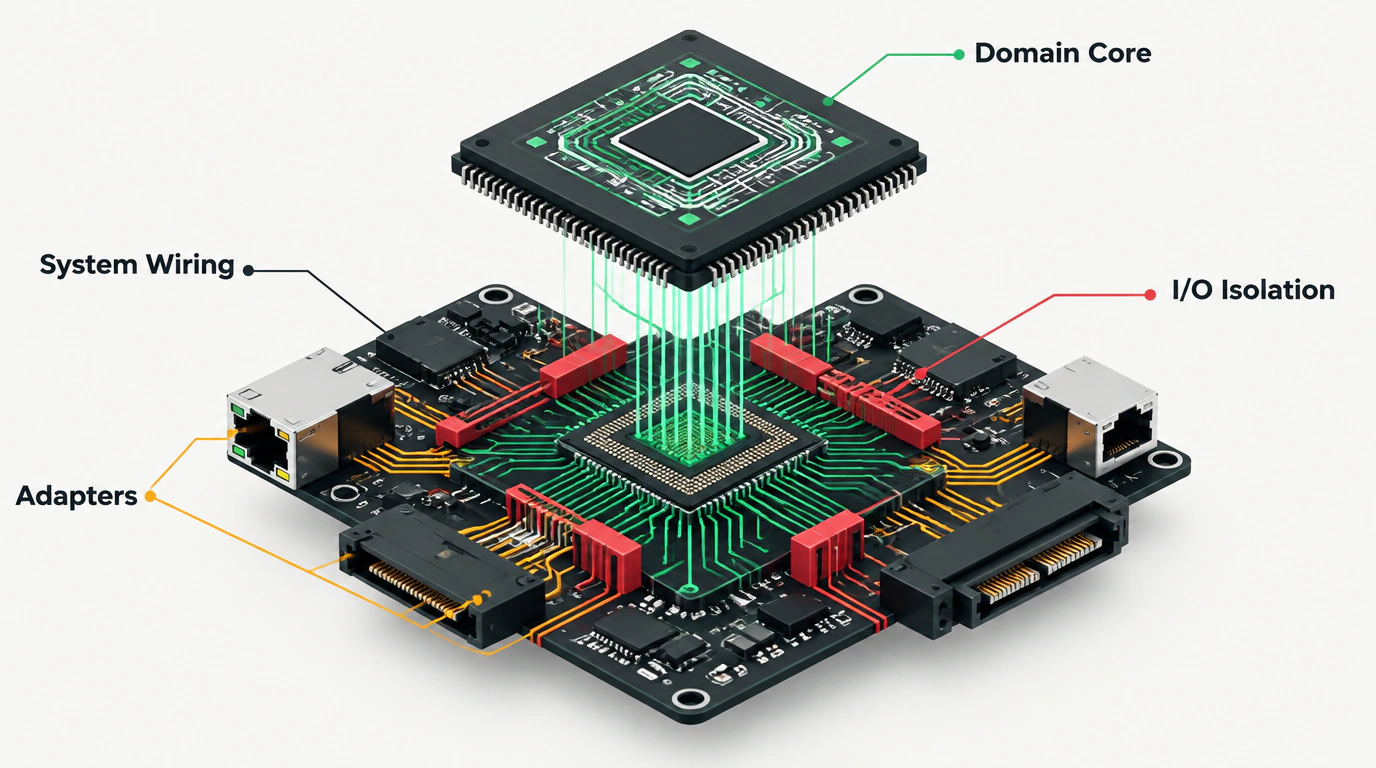
Давай проведем наглядную физическую аналогию. Представь себе современный смартфон. Внутри него есть процессорное ядро, вычисляющее алгоритмы сжатия видео или криптографические хэши. Процессору абсолютно все равно, откуда взялись байты данных: пришли ли они по Wi-Fi, были считаны с флеш-накопителя или введены пользователем через сенсорный экран. Процессор — это чистое вычислительное устройство.
Вся остальная часть смартфона — материнская плата, радиомодули, контроллеры шины PCIe и шины питания — это система коммутации. Ее единственная задача — вовремя подать нужные байты на вход чипу и забрать результат вычислений для отправки в динамик или на экран. Материнская плата не занимается математикой алгоритмов, а чип не знает, какой марки антенна припаяна на плате.
В кодовой базе должно действовать ровно то же разделение:
- Предметное ядро (Domain Core): это исключительно чистые, детерминированные функции и неизменяемые (immutable) структуры данных. В этом слое категорически запрещены любые операции ввода-вывода (I/O), сетевые вызовы, запросы к базам данных, чтение системных таймеров или обращение к переменным окружения. Модуль принимает данные на вход и возвращает результат вычислений на выход;
- Системные адаптеры (System Adapters): тонкие изолированные модули, умеющие общаться с внешним миром — выполнить SQL-запрос к PostgreSQL, отправить событие в RabbitMQ или сериализовать ответ в JSON для gRPC-клиента. Адаптеры не содержат бизнес-правил;
- Слой системной коммутации (Wiring / Composition Root): специальное выделенное пространство в приложении, где адаптеры соединяются с чистыми бизнес-функциями через прозрачные контракты.
Анатомия чистого ядра: детерминированные функции без знания о базах и сети
Давай посмотрим, как этот принцип материализуется в реальном коде на TypeScript. Допустим, мы проектируем критический бизнес-сценарий расчета стоимости и проверки условий оформления сложного корпоративного заказа.
В традиционном enterprise-коде разработчик создал бы OrderService, внедрив в него через конструктор пул соединений с базой данных и логгер. Но в архитектуре с разделением коммутации предметное ядро полностью изолировано:
// Листинг 1. Чистое предметное ядро бизнес-логики (Domain Core)
// Обрати внимание: в файле нет ни одного внешнего импорта! Ни фреймворков, ни БД, ни ORM.

export interface OrderItem {
  readonly id: string;
  readonly price: number;
  readonly quantity: number;
}

export interface CustomerProfile {
  readonly id: string;
  readonly tier: 'standard' | 'premium' | 'vip';
  readonly balance: number;
}

export interface DiscountPolicy {
  readonly rate: number;
  readonly maxCap: number;
}

export interface CalculationResult {
  readonly subtotal: number;
  readonly discountAmount: number;
  readonly total: number;
  readonly isEligible: boolean;
}

// Чистая детерминированная функция: результат зависит строго от входных аргументов
export function calculateOrderSettlement(
  items: readonly OrderItem[],
  customer: CustomerProfile,
  policy: DiscountPolicy
): CalculationResult {
  // 1. Вычисление промежуточного итога корзины
  const subtotal = items.reduce((acc, item) => acc + item.price * item.quantity, 0);

  // 2. Расчет базовой скидки в зависимости от статуса клиента
  let rawDiscount = 0;
  if (customer.tier === 'vip') {
    rawDiscount = subtotal * policy.rate;
  } else if (customer.tier === 'premium') {
    rawDiscount = subtotal * (policy.rate * 0.5);
  }

  // 3. Применение предельного ограничения скидки (maxCap)
  const discountAmount = Math.min(rawDiscount, policy.maxCap);
  const total = Math.max(0, subtotal - discountAmount);

  // 4. Проверка финансовой состоятельности покупателя
  const isEligible = customer.balance >= total;

  return {
    subtotal,
    discountAmount,
    total,
    isEligible,
  };
}
Посмотри внимательно на Листинг 1. Здесь нет асинхронных ключевых слов async/await, нет исключений, выбрасываемых посреди вычислений, и нет привязки к конкретным библиотекам.
Эту функцию можно с одинаковым успехом запустить в Node.js, скомпилировать в WebAssembly для работы в браузере или перенести в легковесный бессерверный воркер Cloudflare Workers. Она кристально прозрачна: передав одинаковые массивы на вход, ты всегда получишь один и тот же результат с точностью до бита.
Слой коммутации: фабрики Use Case, порты и изолированная сборка
Теперь возникает закономерный вопрос: если функция ничего не знает о внешнем мире, кто поставляет ей данные из базы и фиксирует результат на диске?
Для этого создается слой системной коммутации. В архитектуре Кмаладзе он реализуется через фабричные функции сценариев использования (Use Case Factories) и порты ввода-вывода (Ports):
// Листинг 2. Слой системной коммутации и фабрика сценария (System Wiring)
// Здесь чистая математика связывается с инфраструктурными адаптерами.

import { calculateOrderSettlement, OrderItem, CustomerProfile, DiscountPolicy } from './domain-core';

// Порт хранилища данных: абстрактный контракт без привязки к PostgreSQL или MongoDB
export interface OrderStoragePort {
  loadCustomer(customerId: string): Promise<CustomerProfile>;
  loadPolicy(): Promise<DiscountPolicy>;
  commitTransaction(orderId: string, total: number): Promise<void>;
}

// Порт телеметрии и логирования
export interface LoggerPort {
  info(message: string, context?: Record<string, unknown>): void;
  warn(message: string, context?: Record<string, unknown>): void;
}

// Фабрика бизнес-сценария: выполняет сборку зависимостей (Wiring)
export function createOrderCheckoutWorkflow(
  storage: OrderStoragePort,
  logger: LoggerPort
) {
  // Возвращаемая функция сценария: оркестратор потока данных
  return async function executeCheckout(
    orderId: string,
    customerId: string,
    items: readonly OrderItem[]
  ): Promise<{ success: boolean; total: number }> {
    logger.info('Старт процедуры оформления заказа', { orderId, customerId });

    // 1. Асинхронное получение необходимых данных из инфраструктуры
    const [customer, policy] = await Promise.all([
      storage.loadCustomer(customerId),
      storage.loadPolicy(),
    ]);

    // 2. Делегирование математики чистой функции предметной логики
    const settlement = calculateOrderSettlement(items, customer, policy);

    // 3. Ветвление потока управления по результатам вычислений
    if (!settlement.isEligible) {
      logger.warn('Отказ в оформлении: баланс клиента ниже требуемой суммы', {
        customerId,
        required: settlement.total,
        balance: customer.balance,
      });
      return { success: false, total: settlement.total };
    }

    // 4. Сохранение побочных эффектов через порт хранилища
    await storage.commitTransaction(orderId, settlement.total);
    logger.info('Заказ успешно зафиксирован в базе данных', { orderId, total: settlement.total });

    return { success: true, total: settlement.total };
  };
}
Обрати внимание на чистоту разделения труда в Листинге 2:
- Функция
executeCheckoutне выполняет SQL-запросов и не знает, в какой таблице лежат клиенты; - Она выступает в роли диспетчера: запросила структуры через порт, передала их в
calculateOrderSettlement, оценила флагisEligibleи вызвала сохранение; - Сборка фабрики происходит в единственной точке входа приложения (
Composition Root). Если завтра компания решит сменить PostgreSQL на KiviDB или ScyllaDB, доменное ядро не изменится ни на йоту — обновится лишь реализация интерфейсаOrderStoragePort.
Вместо динамического поиска сервисов в глобальном реестре во время выполнения (Runtime Service Locator) фабрики используют строгую статическую типизацию TypeScript. Если ты забыл передать логгер или адаптер базы в фабрику, проект просто не скомпилируется. Никаких внезапных падений в продакшене из-за того, что DI-контейнер не смог разрешить циклическую зависимость при старте.
Смерть «мок-ада»: как тестировать бизнес-логику без имитации базы данных
Спроси любого разработчика в enterprise-проекте, что он ненавидит больше всего, и он ответит: писать юнит-тесты на бизнес-сервисы.
В традиционных архитектурах юнит-тест напоминает изощренную пытку. Чтобы протестировать ветвление скидки в 5 строк, разработчик вынужден писать 80 строк настройки тестового фреймворка: мокать вызов repo.findOne, мокать транзакционный менеджер, мокать логгер, следить, чтобы методы моков возвращали промисы правильной формы. А самое печальное — при малейшем рефакторинге SQL-запроса тест падает, хотя сами бизнес-правила не изменились. Тесты проверяют детали реализации, а не поведение.
В архитектуре чистого ядра тестирование превращается в истинное удовольствие:
- Для проверки бизнес-логики тебе вообще не нужны моки. Ты просто создаешь три объекта с тестовыми числами в оперативной памяти, передаешь их в
calculateOrderSettlementи проверяешь возвращаемое значение через обычныйassert.strictEqual. Тест выполняется за микросекунды; - Тестирование слоя коммутации (фабрики сценария) требует лишь простейших стабовпортов: объект в памяти, эмулирующий возврат фиксированного профиля;
- Инфраструктурные адаптеры тестируются изолированными интеграционными тестами в реальных контейнерах Testcontainers, проверяя честный SQL против живой базы данных.
В результате пирамида тестирования встает с головы на ноги: надежная быстрая верификация сотен сценариев предметной области занимает секунды в CI-пайплайне.
Иллюзия микросервисов и закон Конвея в кодовых базах-гигантах
Когда монолитная кодовая база начинает буксовать, менеджмент часто принимает волевое решение: «Распилим все на микросервисы!». Нанимаются DevOps-инженеры, настраивается Kubernetes, кодовая база режется на 50 маленьких репозиториев.
Но если архитектура исходного монолита страдала от перемешивания коммутации и бизнес-логики, распил порождает катастрофу: так называемый распределенный монолит. Связность никуда не исчезает — она просто переезжает из вызовов функций в ненадежные сетевые HTTP/gRPC запросы. Теперь вместо мгновенной ошибки компилятора система страдает от сетевых задержек, частичных отказов узлов, потери транзакционной целостности и необходимости распределенной трассировки.
Дмитрий Кмаладзе подчеркивает: граница сервиса должна определяться не размером папки с кодом, а структурой инженерной организации (закон Конвея).
Если две команды ежедневно меняют один и тот же бизнес-сценарий, разделение их кода по разным сетевым сервисам лишь затормозит разработку. Гораздо надежнее держать кодовую базу в едином монорепозитории с жесткими линтерами границ модулей:
- Чистые ядра разных доменов могут находиться в соседних пакетах;
- Они не имеют права импортировать друг друга напрямую;
- Взаимодействие настраивается на уровне коммутации верхнего уровня.
Ранее мы детально разбирали природу долгоживущих решений в исследовании Обратимые и необратимые архитектурные решения в эпоху генеративного кода, подчеркивая, что изоляция бизнес-ядра делает саму технологическую инфраструктуру полностью обратимой.
Практический маршрут миграции: как распутать существующее легаси
Ты сейчас наверняка думаешь: «Все это звучит здорово для проекта, который пишется с чистого листа. Но у нас уже миллион строк запутанного спагетти с ORM и декораторами! Как выжить нам?».
Ни в коем случае нельзя объявлять полугодовой мораторий на фичи и пытаться переписать все с нуля (Second System Syndrome) — бизнес такого никогда не простит. Переход осуществляется по технике удушения легаси (Strangler Fig Pattern):
- Заморозка добавления логики в существующие сервисы. При поступлении новой бизнес-задачи запрещается дописывать новые методы в старые классы с базой данных;
- Экстракция чистых функций. Начни с выноса алгоритмических участков. Найди в гигантском методе расчетные формулы, вынеси их в отдельный файл без импортов и покрой простыми юнит-тестами;
- Определение интерфейсных портов. Опиши контрактом TypeScript, какие именно данные нужны этой функции от базы;
- Превращение старого сервиса в тонкий адаптер. Пусть старый класс сервиса просто достает данные из существующей ORM и вызывает твою новую чистую функцию.
Шаг за шагом ядро предметной области начнет кристаллизоваться, освобождаясь от инфраструктурного балласта, а кодовая база вернет себе былую гибкость и предсказуемость.
Нет, чистые функции не требуют библиотек для сложения чисел и манипуляции объектами. А вот для сетевых задач (парсинг JSON, маршрутизация HTTP, пул сокетов) ты продолжаешь использовать проверенные быстрые библиотеки (Fastify, Hono, pg), подключая их строго в тонком слое адаптеров.
Для этого настраиваются архитектурные линтеры (например, dependency-cruiser или правила ESLint no-restricted-imports), которые на уровне CI/CD автоматически блокируют коммиты, если внутри каталога domain обнаруживается импорт из инфраструктурных слоев.