Edición 19 de octubreDigest del día · 14 materiales
Qué hay en esta ediciónRevisamos 36 fuentes, reunimos 14 materiales
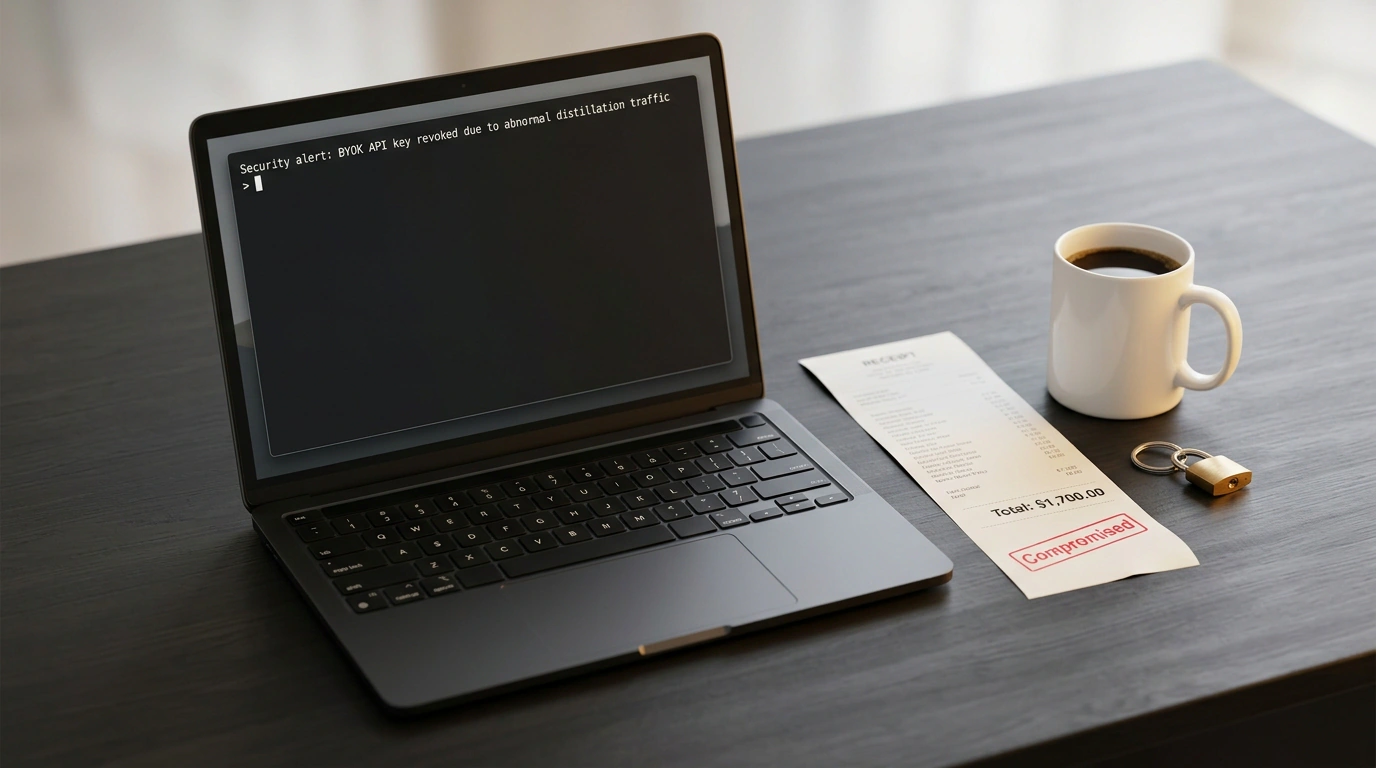
Bodegón escenificado con un portátil, un recibo rasgado de mil quinientos dólares y una alerta del sistema de seguridad sobre la revocación de una clave API comprometida
ArtículoSeguridadOpen SourceDesarrolloVulnerabilidades

El hackeo de OpenCode y el ataque de destilación: cómo una fuga de tokens golpeó a las herramientas de IA abiertas

Imagínate programando tranquilo en tu editor favorito y que a la mañana siguiente te encuentres en tu panel de Anthropic o OpenAI una factura de 1.500 dólares por millones de peticiones nocturnas en un idioma desconocido. Eso fue exactamente lo que vivieron los usuarios de la consola en la nube del asistente abierto OpenCode. El acceso no autorizado afectó a un servicio de autenticación heredado y alcanzó a cerca del 1,4 % de los desarrolladores que guardaban sus claves en un perfil externo. Pero lo más llamativo aquí es el vector de ataque: los hackers no irrumpieron para pedir un rescate, sino que robaron tokens para ejecutar mediante cuentas ajenas una destilación automatizada de modelos insignia con la que entrenar gratis sus propias redes.
👍 0
David OndrejCyberSecurityNews - OpenCode Distillation Attack Security Incident
19 de octubre
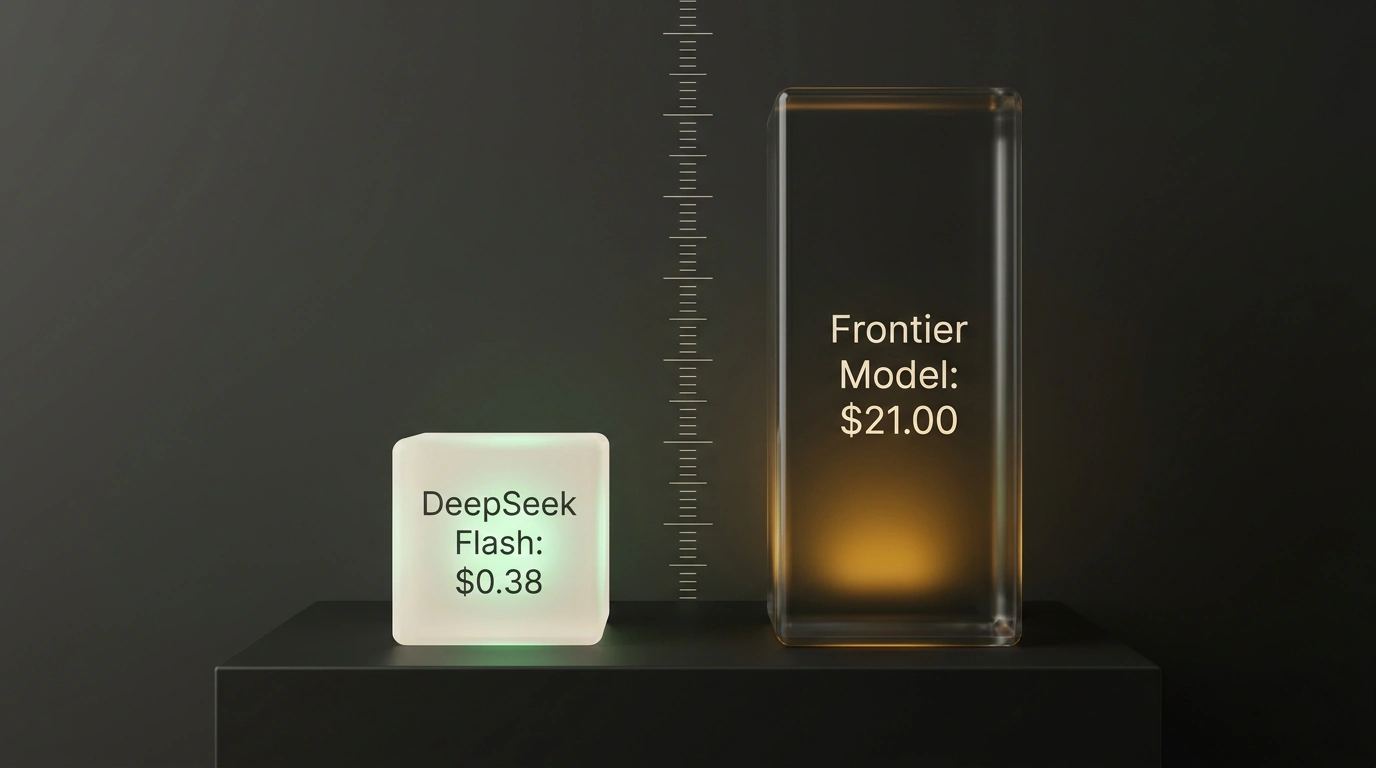
Bodegón comparativo con dos cubos transparentes de coste computacional para construir aplicaciones y una indicación contrastada de precios de $0.38 y $21.00
ArtículoLLMDesarrolloBenchmarksDeepSeek

DeepSeek V4.1 Flash 1017: creación ultrarrápida de apps y comparativa de costes frente a Claude Opus

Los desarrolladores se habían acostumbrado a pensar que para generar un servicio web completo desde cero hacía falta sí o sí un modelo insignia pesado y carísimo como Claude Opus. El nuevo checkpoint DeepSeek V4.1 Flash 1017 del 17 de octubre de 2026 demuestra que el monopolio de las redes ultracaras empieza a quedar atrás. Con una ventana de contexto de 1 millón de tokens y una latencia al primer token de apenas 140 milisegundos, levanta portales para clientes en cuestión de minutos. En un experimento controlado con tres compilaciones completas de aplicaciones, el gasto de inferencia fue de solo 38 centavos frente a los 21 dólares de los modelos propietarios líderes, lo que supone un ahorro superior a cincuenta veces con un código igual de funcional.

👍 0
Julian Goldie SEODeepSeek Platform - V4.1 Flash 1017 Release
19 de octubre
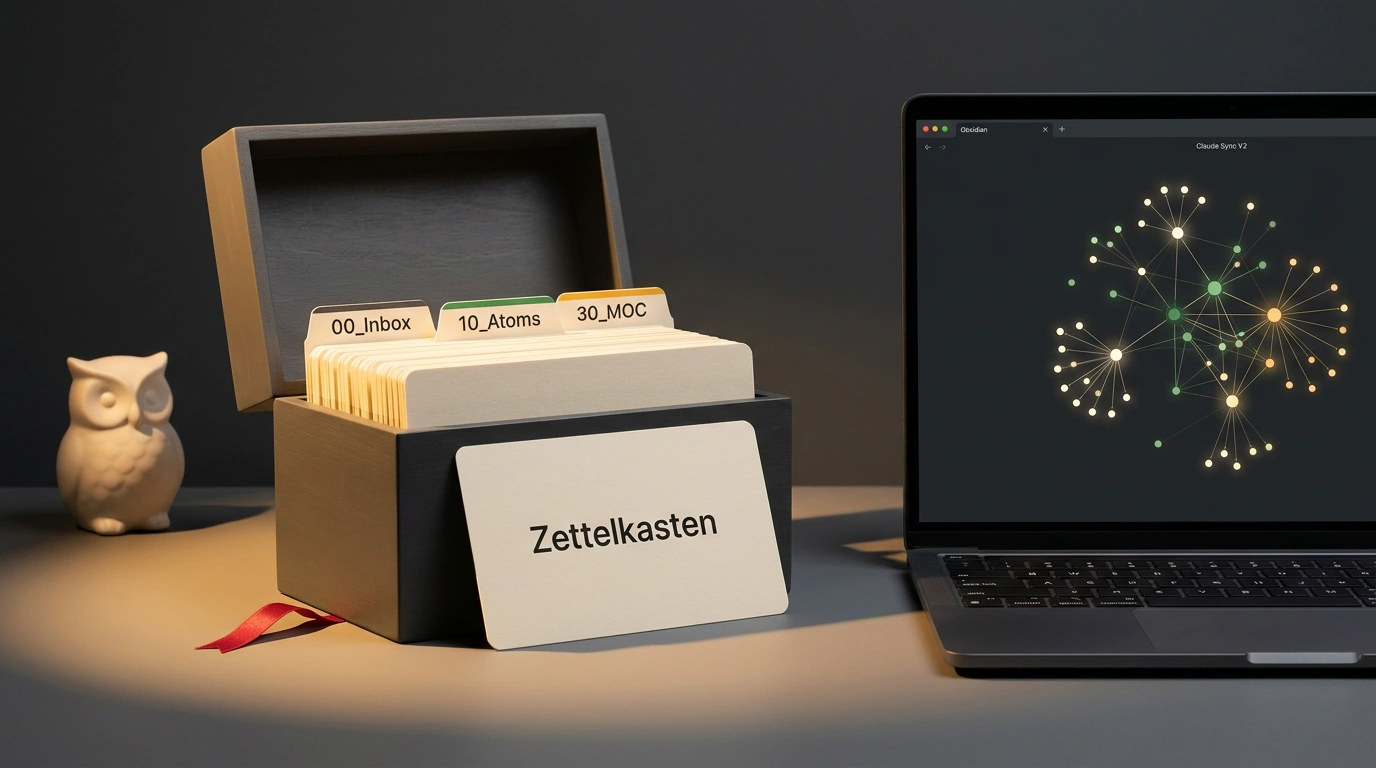
Escritorio acogedor con un fichero de madera Zettelkasten, separadores de capas de la base de conocimiento y un grafo brillante de Obsidian en la pantalla del portátil
A fondoProductividadAutomatizaciónBase de conocimientoObsidian

Segundo cerebro con IA: guía paso a paso para crear tu base de conocimiento personal con Claude y Obsidian

La mayoría de los intentos por construir un «segundo cerebro» digital terminan en decepción: abres una app de notas, guardas cientos de enlaces y a los dos meses descubres un cementerio de texto abandonado donde no encuentras nada rápido. Pero si cruzas los principios de las notas atómicas Zettelkasten con la potencia contextual de Claude, el archivo cobra vida al instante. El plugin local Claude Obsidian V2 permite analizar tu repositorio sin subir archivos a nubes de terceros, convirtiendo borradores dispersos en un grafo de ideas conectado. La IA actúa como un compañero de diálogo atento que cruza tus notas, detecta contradicciones lógicas y te ayuda a formular conclusiones a partir de tus propias observaciones.

👍 0
Julian Goldie SEONick SaraevObsidian Plugin Directory - Claude Sync V2
19 de octubre
Noticias · 19 de octubre7 noticias

ChatGPT ya lee las pestañas del navegador: nuevas opciones para automatizar tareas rutinarias

OpenAI ha enseñado a ChatGPT a leer directamente el contexto de las pestañas abiertas del navegador sin copiar textos a mano. El asistente analiza hasta diez páginas a la vez y resume precios y características en tablas en cuestión de segundos, con aislamiento seguro de contraseñas para los planes Plus, Team y Enterprise.

Perplexity Computer estrena el modo UltraFast: aceleración de tareas de cómputo en segundo plano

Perplexity Computer ha lanzado el preset UltraFast para análisis profundo de datos y cómputo en segundo plano. Este nuevo modo consulta cientos de fuentes en paralelo y completa tareas analíticas complejas cinco veces más rápido que el Pro Search habitual, ahorrando tiempo valioso a los usuarios de Pro y Enterprise.

Grok Voice 3.0: latencia ultrabaja y un nuevo nivel de naturalidad en la IA de voz

Los ingenieros de xAI han lanzado el modelo de voz Grok Voice 3.0 con arquitectura speech-to-speech de extremo a extremo. La latencia del primer eco baja a unos récord de 220–250 milisegundos, e incorpora gestión instantánea de interrupciones y modulación emocional de la entonación tanto en la app de X como en su API pública.

Microsoft Decision-1: modelo ultrarrápido especializado en toma de decisiones para agentes de IA

Microsoft ha presentado el modelo especializado Decision-1 para sistemas agénticos. En lugar de generar textos largos, ejecuta puntuación probabilística de acciones 35 veces más rápido que los LLM generalistas por menos de un centavo cada mil decisiones, liberando a los modelos pesados del enrutamiento rutinario.

Krea 3: edición local de imágenes en 2K por instrucciones de texto en 8 segundos

La plataforma Krea ha lanzado la tercera versión de su editor visual, Krea 3, con edición local de precisión a resolución 2K. El modelo modifica las zonas seleccionadas mediante un recuadro y una indicación de texto en menos de ocho segundos, conservando con exactitud las sombras, la perspectiva y la paleta de color del entorno.

MiniCPM-V 4.7: modelo multimodal de 35.000 millones de parámetros en 3 GB de RAM de un móvil

El laboratorio OpenBMB ha publicado el modelo multimodal MiniCPM-V 4.7 con arquitectura MoE de 35.000 millones de parámetros. Gracias a la cuantización INT4 y la carga anticipada de expertos activos desde memoria flash, el modelo funciona totalmente en local en smartphones con apenas 3 GB de memoria RAM.

Ling 3.1 Flash: modelo abierto de 560.000 millones de parámetros para generar apps web desde un solo prompt

El equipo de InclusionAI ha presentado Ling 3.1 Flash, un enorme modelo MoE abierto de 560.000 millones de parámetros con ventana de 1 millón de tokens. Su arquitectura está optimizada para generar aplicaciones web interactivas a partir de un único prompt de texto a velocidades superiores a 90 tokens por segundo.

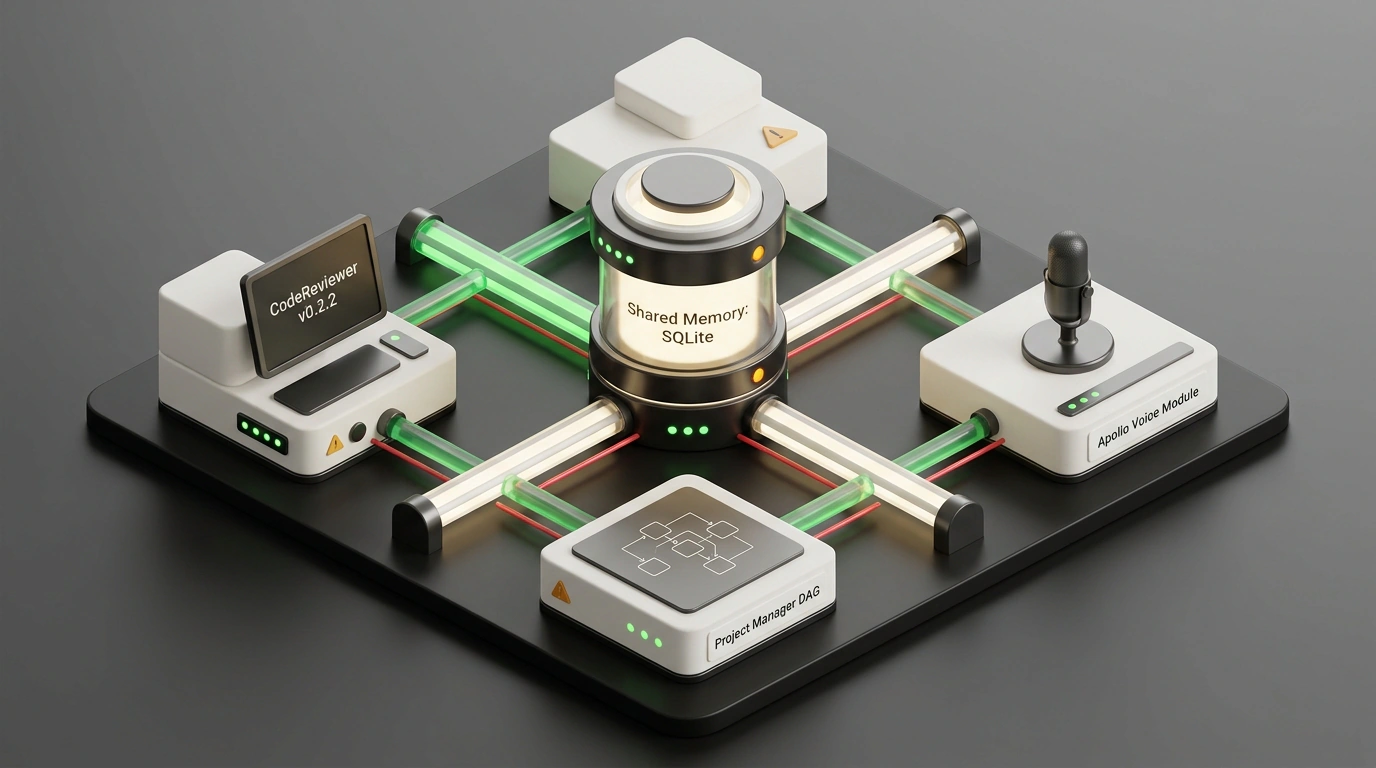
Modelo volumétrico isométrico del centro de mando de la plataforma abierta Hermes Agent con bus de memoria SQLite y el módulo de voz Apollo
Resumen temático4 seccionesAgentes de IAOpen SourceAutomatizaciónArquitectura

El ecosistema de agentes de IA abiertos Hermes: arquitectura Agent OS, lanzamiento v0.2.2 y control por voz

Los scripts agénticos dispersos obligan a los desarrolladores a saltar sin fin entre pestañas del navegador y trasladar contexto a mano entre herramientas. La plataforma modular abierta Hermes Agent resuelve este problema mediante un entorno operativo compartido Agent OS y el lanzamiento estable del núcleo v0.2.2.

Su arquitectura reúne tres niveles clave de coordinación:

  • Bus de memoria compartida: elimina el aislamiento de los agentes y guarda el historial de decisiones en SQLite local;
  • Agente de voz Apollo: procesa el búfer de pantalla y la voz del interlocutor con una latencia inferior a 300 ms;
  • Coordinador Project Manager: descompone instrucciones de negocio de alto nivel en un grafo de subtareas y las reparte entre ejecutores.

El resultado es un armazón abierto y fiable para el trabajo autónomo en local.

👍 0
Julian Goldie SEONous Research Hermes Agent OS v0.2.2 Documentation
19 de octubre
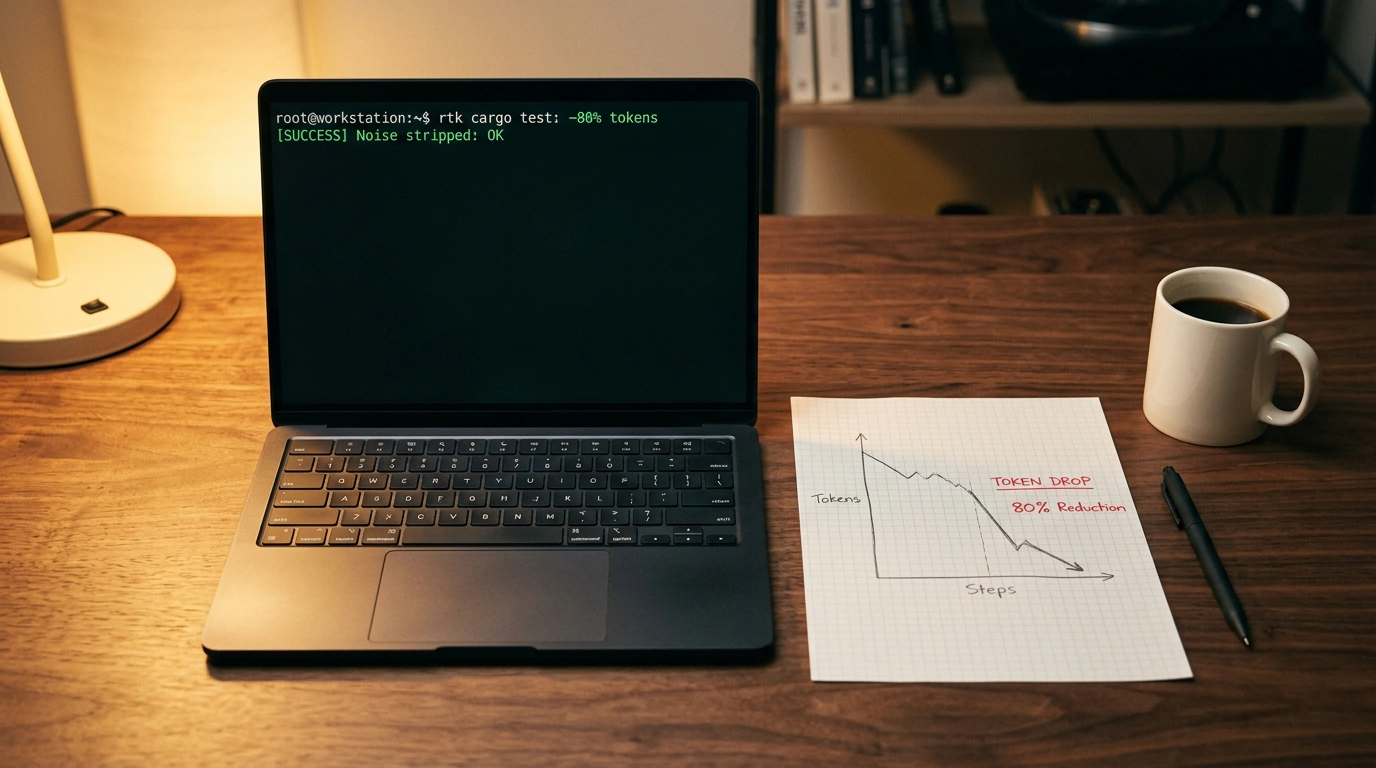
Bodegón escenificado con un portátil abierto y una terminal limpiando tokens mediante la utilidad RTK sobre gráficos en papel de reducción de contexto
ArtículoOptimizaciónDesarrolloLLMTokens

Ahorra hasta un 80 % de tokens en LLM: el stack práctico de Headroom, RTK, Caveman y Ponytail

¿Adónde se escapa el presupuesto cuando trabajas a fondo con agentes de IA autónomos como Claude Code u OpenCode? Al revisar los logs del sistema descubres que hasta el 80 % de los tokens no se gastan en razonamiento profundo, sino en ruido parásito: barras de carga de terminal, líneas vacías interminables, introducciones corteses interminables y JSON repetitivos. El conjunto de utilidades abiertas Headroom, RTK, Caveman y Ponytail cierra esa fuga en todas las etapas clave del flujo. El proxy CLI rápido RTK comprime la salida de comandos de terminal entre un 60 % y un 90 %, el servidor proxy Headroom optimiza el contexto de red y el modo Caveman recorta la verborrea, reduciendo el gasto en API entre cuatro y cinco veces sin mermar la calidad del código.

👍 0
Julian Goldie SEOExtraHeadroom Token Optimization Stack Documentation
19 de octubre
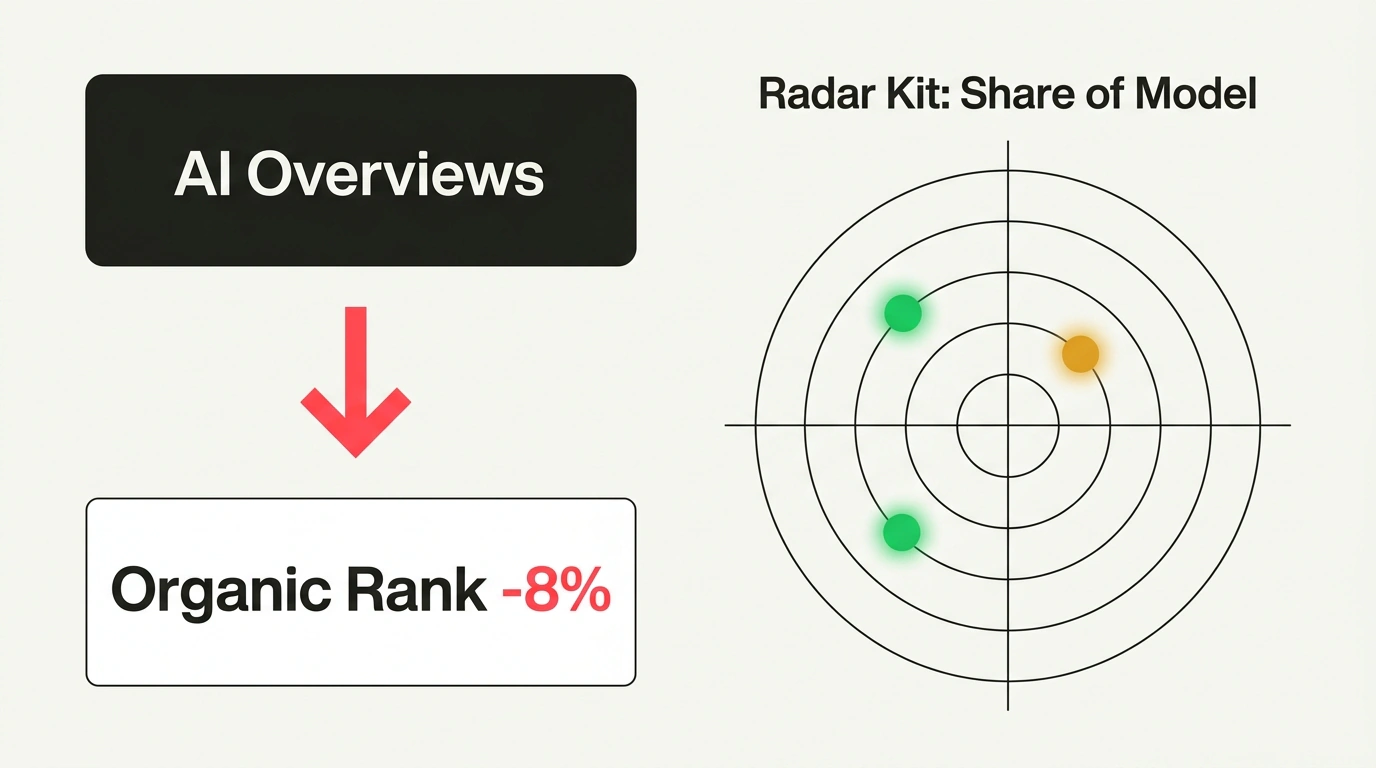
Ilustración minimalista tipo póster de resultados de búsqueda con el bloque AI Overviews y el radar analítico de citación Radar Kit
ArtículoBúsqueda IASEOAnalíticaAlgoritmos

Nueva era de la optimización de búsqueda: auditoría de visibilidad en búsqueda con IA con Radar Kit y novedades de Google AI Overviews

La clásica batalla por el primer puesto en los resultados de búsqueda está perdiendo sentido a toda velocidad. Con Google AI Overviews y las respuestas generativas de Bing, los usuarios obtienen información completa en la propia página sin hacer clic en ningún enlace. Los estudios muestran que los resúmenes con IA desplazan hacia abajo hasta un 8 % de las primeras posiciones tradicionales, empujando a los especialistas del SEO clásico hacia la optimización para motores generativos: GEO y AEO. La métrica principal pasa de ser una posición abstracta a la cuota de citación de marca dentro de las respuestas de la IA, y herramientas como Radar Kit o el informe Topics Portfolio de Bing Webmaster Tools permiten auditar la visibilidad en seis sistemas de IA y detectar clústeres de búsqueda desaprovechados.

👍 0
Julian Goldie SEOAleyda Solis - SEOFOMORadarKit GEO Audit Documentation
19 de octubre
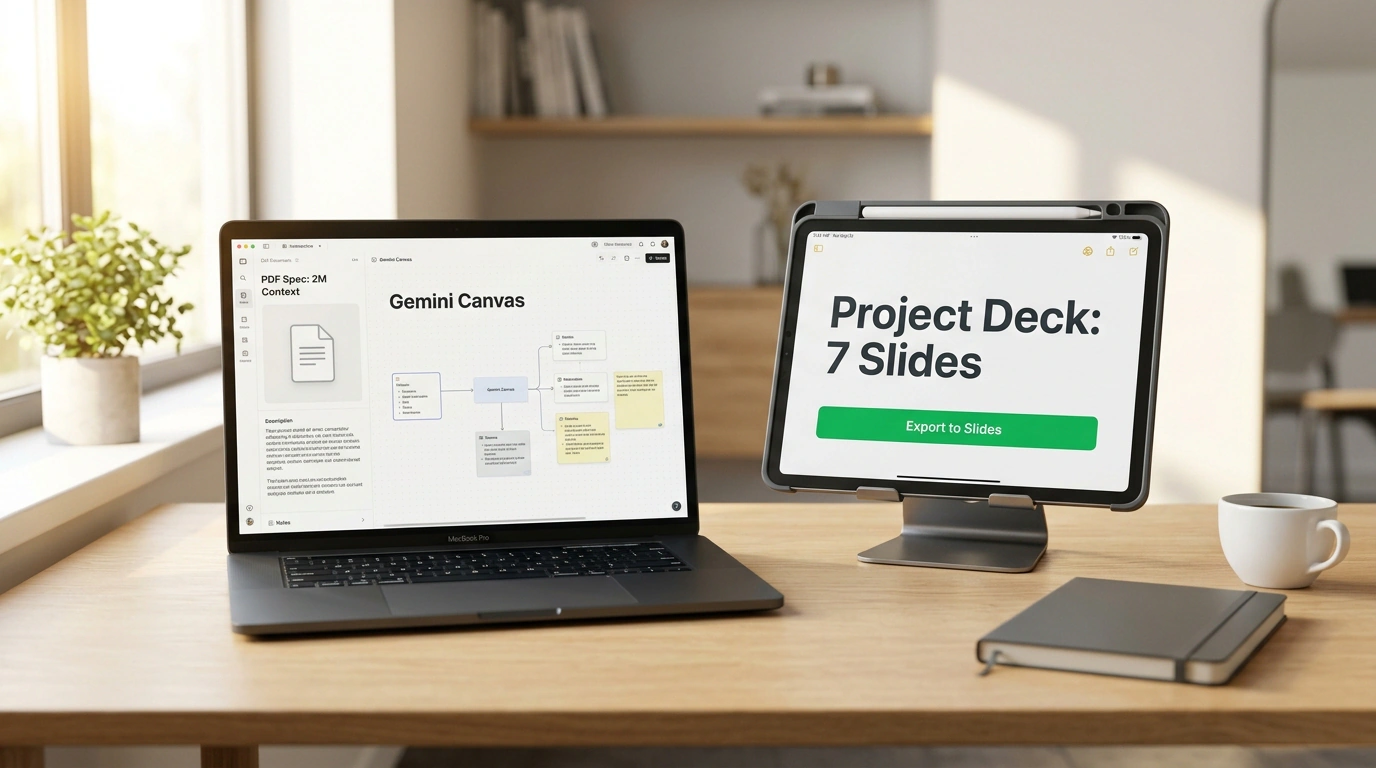
Conjunto de un portátil abierto con la interfaz del lienzo interactivo Gemini Canvas y una presentación terminada en Google Slides sobre el escritorio
ArtículoAutomatizaciónInteligencia artificialGoogle SlidesPresentaciones

Gemini para flujos de trabajo: generación de presentaciones en Google Slides y conversión de PDF en un Canvas interactivo

Preparar informes de proyecto y montar diapositivas tras largas cadenas de correos suele consumir dos o tres horas de trabajo mecánico. Las nuevas funciones agénticas de Google Gemini dentro de Workspace convierten esa tarea en un proceso automático y veloz. El modelo ya lee directamente hilos de Gmail o archivos de Google Drive para generar una presentación estructurada en Google Slides con notas para el orador y maquetación limpia. Además, el lienzo interactivo Gemini Canvas digiere reglamentos técnicos de cuarenta páginas y PDF financieros para transformarlos en tablas de cálculo dinámicas y componentes web clicables, marcando el paso de la IA de simple interlocutora a ejecutora real.

👍 0
Julian Goldie SEOGoogle Workspace Updates - Gemini in Slides and Canvas
19 de octubre