Seguro que más de una vez te ha pasado por la cabeza: «Estoy convencido de que leí una idea buenísima sobre esto hace seis meses, pero no me acuerdo ni por asomo de dónde». Abres los marcadores del navegador y hay miles de páginas guardadas. Abres la app de notas de siempre y ves un caos de ideas sueltas, capturas de pantalla y recetas de pizza.
La mayoría de los intentos por montar una base de conocimiento personal (Personal Knowledge Base) acaban convertidos en un cementerio digital. Guardamos enlaces con la esperanza de volver a ellos algún día, pero el aprovechamiento real roza el cero.
Ya en 1945, el científico estadounidense Vannevar Bush describió en su mítico ensayo «As We May Think» el concepto de Memex: una máquina pensada como extensión de la memoria humana mediante una red de enlaces asociativos. Hoy, 80 años después, por fin podemos montar un Memex funcional en nuestro propio portátil.
He probado la combinación del editor abierto Obsidian, los principios del sociólogo alemán Niklas Luhmann (el método Zettelkasten) y el contexto analítico de Claude. El resultado supera cualquier expectativa: en lugar de un almacén pasivo de notas, consigues un interlocutor activo que te ayuda a pensar y a descubrir conexiones nada evidentes.
Arquitectura Compounding Vault: tres niveles de orden
El error clásico de quien empieza es intentar que la IA «digiera» bloques gigantes de texto sin procesar. Si le sueltas cuarenta PDF de golpe, obtendrás un resumen superficial lleno de lugares comunes (el famoso AI Slop).
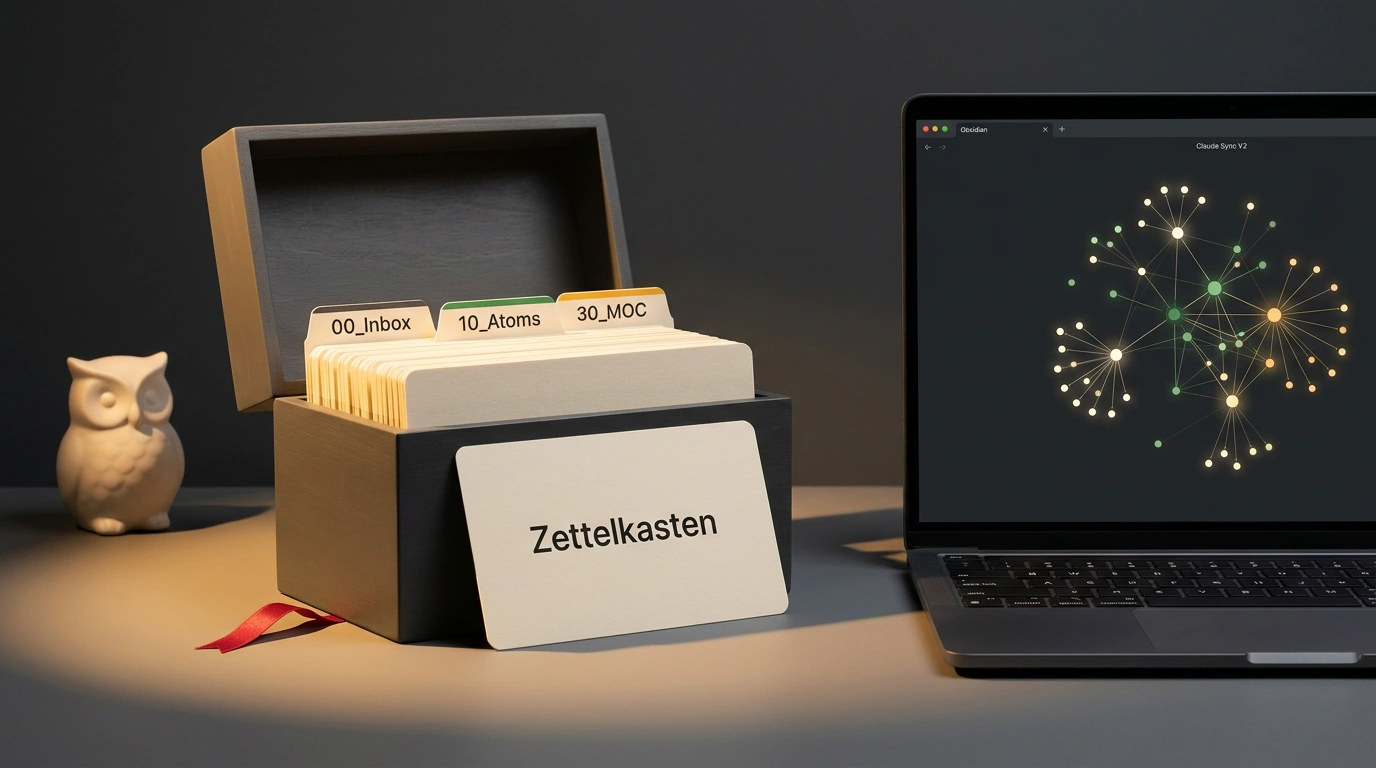
Plano arquitectónico isométrico de una base de conocimiento en tres niveles con fichas ordenadas 00_Inbox, 10_Atoms y el hub 30_MOC
El investigador Nick Saraev propuso una elegante estructura en tres capas llamada bóveda acumulativa (Compounding Vault):
- Capa de entrada (00_Inbox): bandeja temporal para enlaces, notas de voz y citas en bruto. Aquí entra todo sin filtrar, pero no debería quedarse más de una semana.
- Capa atómica (10_Atoms): el corazón de la base. Aquí rige una regla estricta de Zettelkasten: una nota, una única idea completa. Cada ficha lleva sus metadatos y se enlaza con otras ideas mediante vínculos del tipo
[[Nombre de la nota]]. - Mapas de contenido (30_MOC): centros de síntesis (Maps of Content) que agrupan decenas de átomos en temas completos (por ejemplo, «Arquitectura de microservicios» o «Principios del sueño saludable»).
Todas las notas se guardan en local como simples archivos Markdown en tu disco. Sin bases propietarias, sin formatos cerrados y sin riesgo de perder el acceso si un servicio decide cambiar sus condiciones de suscripción.
Plantilla de nota atómica
Para que la IA pueda orientarse con soltura entre tus ideas, cada ficha necesita una cabecera estandarizada (YAML-frontmatter). Crea la plantilla 90_Meta/template_atom.md:
---
id: "{{date:YYYYMMDDHHmm}}"
title: "{{title}}"
created: "{{date:YYYY-MM-DDTHH:mm:ss}}"
tags:
  - knowledge
  - atomic
status: active
related: []
---

# {{title}}

## Idea central
<!-- Resume la idea con tus propias palabras en 1 o 2 frases -->

## Evidencia y hechos
<!-- Argumentos verificados, cifras y observaciones personales -->

## Notas relacionadas
<!-- Enlaces cruzados bidireccionales [[Nombre de otra nota]] -->
Fíjate en el campo status: te permite separar las fichas validadas de las hipótesis en borrador. Ya vimos en detalle cómo un buen etiquetado evita el caos en el artículo sobre diseño de una base de conocimiento en Obsidian y en la guía sobre cómo combatir el deterioro de la memoria.
Conectar Claude: un puente sin fugas de datos personales
¿Cómo conectas la inteligencia del modelo con tus archivos locales? El autor del canal Julian Goldie SEO recomienda el plugin abierto Claude Sync V2.
A diferencia de los añadidos en la nube, este plugin habla directamente con la API de Anthropic usando tu clave personal (sk-ant-...). Los archivos no se suben a servidores de terceros, y los embeddings para la búsqueda vectorial se almacenan en caché dentro de tu carpeta local .obsidian.
Cuando tu base acumule un par de cientos de átomos, seguir todas las conexiones cruzadas a mano se vuelve pesado. Aquí tienes un script compacto en Python que lee los metadatos y le pide a Claude que encuentre puentes ocultos entre tus ideas:
import os
import glob
import frontmatter
from anthropic import Anthropic

client = Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))

def analyze_and_link_notes(vault_path):
    atom_files = glob.glob(os.path.join(vault_path, "10_Atoms", "*.md"))
    notes_summary = []

    for fpath in atom_files[:50]:
        post = frontmatter.load(fpath)
        notes_summary.append({
            "file": os.path.basename(fpath),
            "title": post.get("title", "Untitled"),
            "content": post.content[:300]
        })

    prompt = (
        "Given these atomic notes from personal knowledge base, "
        "identify missing conceptual links between them:\n"
        f"{notes_summary}\n"
        "Return pairs of notes that should be linked with a brief rationale."
    )

    response = client.messages.create(
        model="claude-3-5-sonnet-20241022",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}]
    )
    return response.content[0].text

print("Obsidian-Claude connector configured.")
No intentes digitalizar todo lo que has leído en una sola tarde. Toma como norma crear apenas una o dos fichas atómicas al día a partir de tareas reales o hallazgos concretos. En seis meses tendrás una base personal de 300 ideas bien filtradas que conocerá tus proyectos mejor que cualquier consultor.
Cómo evitar que tu base muera al mes siguiente
El gran secreto para que una base de conocimiento dure es la disciplina de atomización. No copies artículos enteros. ¿Has leído el capítulo de un libro o un informe técnico denso? Formula una única conclusión clave con tus palabras, guárdala con la plantilla y lanza el análisis de vínculos.
Cuando Claude te señala: «Tu idea de hoy sobre colas distribuidas continúa de forma lógica aquella nota de hace medio año sobre transacciones en bases de datos», sientes físicamente cómo el conocimiento disperso empieza por fin a trabajar para ti.