Si operas Kubernetes para entrenamiento de modelos (ML/LLM), analítica distribuida o procesamiento por lotes, conoces de sobra el mayor dolor de cabeza del planificador estándar: piensa en pods individuales. No entiende que para entrenar un modelo necesitas exactamente 16 GPUs repartidas en cuatro pods al mismo tiempo, y que si solo hay hueco para tres, lanzarlos no sirve de nada: se quedarán parados quemando presupuesto y bloqueando nodos para otras colas.
Este patrón se llama gang scheduling (planificación en grupo bajo el principio de «todo o nada»). Hasta hace poco el ecosistema parecía la torre de Babel: Kube-batch, Volcano, plugins para Kubeflow, JobSet y desarrollos internos de cada proveedor cloud. Cada operador inventaba sus propias abstracciones, metía hooks personalizados en kube-scheduler y duplicaba miles de líneas de código.
En Kubernetes 1.37, el grupo de trabajo Workload-Aware Scheduling (WAS) dentro de SIG Scheduling —en gran parte gracias a la investigación y diseño de Heba Elayoty— ha consolidado un mecanismo estándar de integración. En lugar de reescribir el planificador como un monolito, Kubernetes propone el paradigma de los bloques de construcción (Building Blocks).
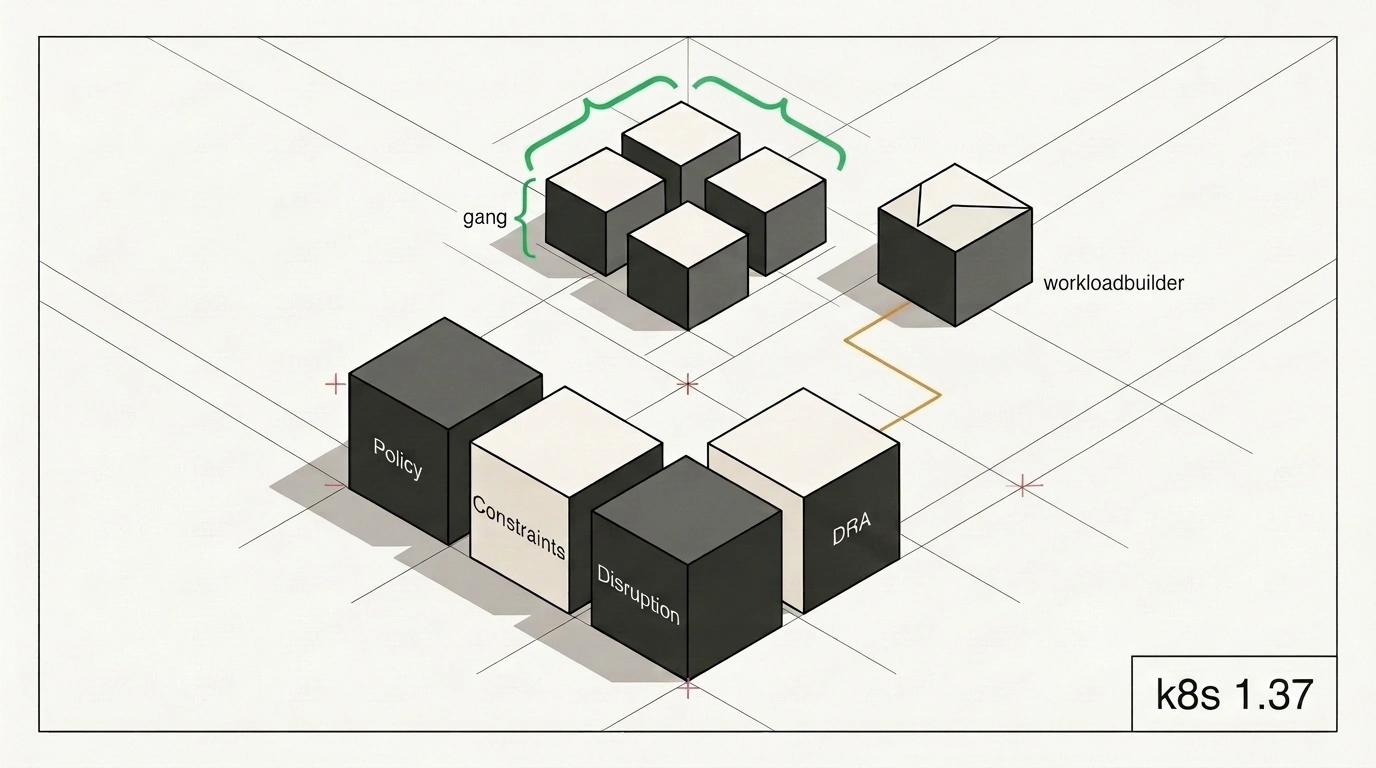
Los cuatro ladrillos de la planificación en grupo
La arquitectura de WAS se divide en dos capas: el núcleo del planificador (los manifiestos Workload y PodGroup pasan a estado Beta en scheduling.k8s.io/v1beta1) y estructuras Go tipadas para los autores de operadores (en el grupo scheduling.k8s.io/v1alpha3).
En vez de construir a mano objetos de bajo nivel del núcleo, quien desarrolla un CRD personalizado simplemente incrusta en su especificación los bloques hoja ya listos (WorkloadPodGroup...):
- Scheduling Policy. Define la lógica base: ejecución individual (
basic) o quórum de grupo (gang) indicando el mínimo de pods conminCount. Además,minCountahora es mutable, así que puedes cambiar el tamaño del grupo dinámicamente sin recrear el objeto. - Scheduling Constraints. Restricciones topológicas de coubicación (topology co-location). Puedes exigir de forma estricta que todos los pods del grupo queden bajo el mismo switch Infiniband o en la misma zona de disponibilidad.
- Disruption Mode. Cómo actuar ante expulsiones (eviction): desalojar pods uno por uno (
single) o interrumpir solo al grupo entero a la vez (all). Como es lógico, el planificador prohíbe el modoallsi la política esbasic. - Resource Claims. Soporte para asignación dinámica de recursos (DRA — Dynamic Resource Allocation), que permite solicitar GPUs a nivel de todo el grupo de tareas.
Para sistemas jerárquicos más complejos (como JobSet, que coordina varios Job normales, o LeaderWorkerSet), existen los bloques compuestos WorkloadCompositePodGroup con el parámetro minGroupCount.
Cómo compila los manifiestos el controlador
Así se ve en la práctica al escribir tu propio operador de ML. Primero incrustamos los bloques de construcción en la especificación Go de nuestro recurso:
package v1alpha1

import (
    metav1 "k8s.io/apimachinery/pkg/apis/meta/v1"
    schedulingv1alpha3 "k8s.io/api/scheduling/v1alpha3"
)

// TrainJobSpec describe una tarea de entrenamiento distribuido
type TrainJobSpec struct {
    Replicas    int32                                               `json:"replicas"`
    Scheduling  *schedulingv1alpha3.WorkloadPodGroupSchedulingPolicy `json:"scheduling,omitempty"`
    Constraints *schedulingv1alpha3.WorkloadPodGroupConstraints     `json:"constraints,omitempty"`
}
Después, en el bucle de reconciliación (reconcile loop) del controlador, conectamos la librería compartida oficial k8s.io/component-helpers/scheduling/workloadbuilder. Se encarga de validar lo que pidió el usuario y compilar automáticamente el árbol de tareas en objetos del planificador:
package controller

import (
    "context"
    schedulingv1beta1 "k8s.io/api/scheduling/v1beta1"
    "k8s.io/component-helpers/scheduling/workloadbuilder"
)

func (r *TrainJobReconciler) buildWorkload(ctx context.Context, job *TrainJob) (*schedulingv1beta1.Workload, error) {
    // Creamos el nodo hoja del pipeline
    item := workloadbuilder.NewLeafItem("worker").
        WithSchedulingPolicy(job.Spec.Scheduling).
        WithConstraints(job.Spec.Constraints).
        WithDefaultPolicy(schedulingv1alpha3.BasicPolicy)

    // Inicializamos el builder: mapea los errores de validación a los campos del CRD original
    builder := workloadbuilder.NewBuilder(item, job.Name, job.Namespace, job)
    if errList := builder.Validate(); len(errList) > 0 {
        return nil, errList.ToAggregate()
    }

    // Compilamos al manifiesto final Workload v1beta1 del núcleo
    return builder.BuildWorkload()
}
Aquí hay una ventaja práctica enorme: si el usuario se equivoca (por ejemplo, pone el modo all con la política basic), el builder devuelve el error señalando la ruta exacta en el manifiesto del usuario (spec.scheduling.disruptionMode), en lugar de quejarse por un campo interno del Workload compilado. Y teniendo en cuenta cómo evoluciona Server-Side Apply en Kubernetes: gestión declarativa de campos y separación de propiedad, la coherencia entre los campos del CRD y los objetos internos del planificador queda totalmente transparente.
No confundas las tareas de WAS con las colas de trabajos: el proyecto Kueue sigue encargándose de las cuotas globales, los presupuestos por equipo y la admisión al clúster (admission), mientras que Workload-Aware Scheduling asume la asignación atómica de nodos para el grupo ya en marcha.
En definitiva, Kubernetes 1.37 ofrece a los equipos de plataforma una base limpia: ya no hace falta reinventar la rueda para que el clúster lance grandes cargas de AI/ML con cabeza.