

Если ты занимаешься эксплуатацией Kubernetes под задачи машинного обучения (ML/LLM), распределенной аналитики или пакетной обработки данных, то прекрасно знаешь главную боль стандартного планировщика: он мыслит отдельными подами. Ему невдомек, что для обучения модели тебе нужны ровно 16 видеокарт в четырех подах строго одновременно, и если свободны ресурсы только для трех подов, запускать их бессмысленно — они просто будут простаивать и сжигать бюджет, заблокировав ноды для других очередей.
Этот паттерн называется gang scheduling (групповое планирование по принципу «всё или ничего»). До недавнего времени экосистема напоминала вавилонское столпотворение: Kube-batch, Volcano, плагины для Kubeflow, JobSet, внутренние разработки облачных провайдеров. Каждый оператор городил собственные абстракции, внедрял кастомные хуки в kube-scheduler и дублировал тысячи строк кода.
В Kubernetes 1.37 рабочая группа Workload-Aware Scheduling (WAS) в рамках SIG Scheduling (во многом благодаря исследованию и архитектуре Хебы Элайоти / Heba Elayoty) довела до ума стандартизированный механизм интеграции. Вместо монолитного переписывания планировщика Kubernetes предложил парадигму строительных блоков (Building Blocks).
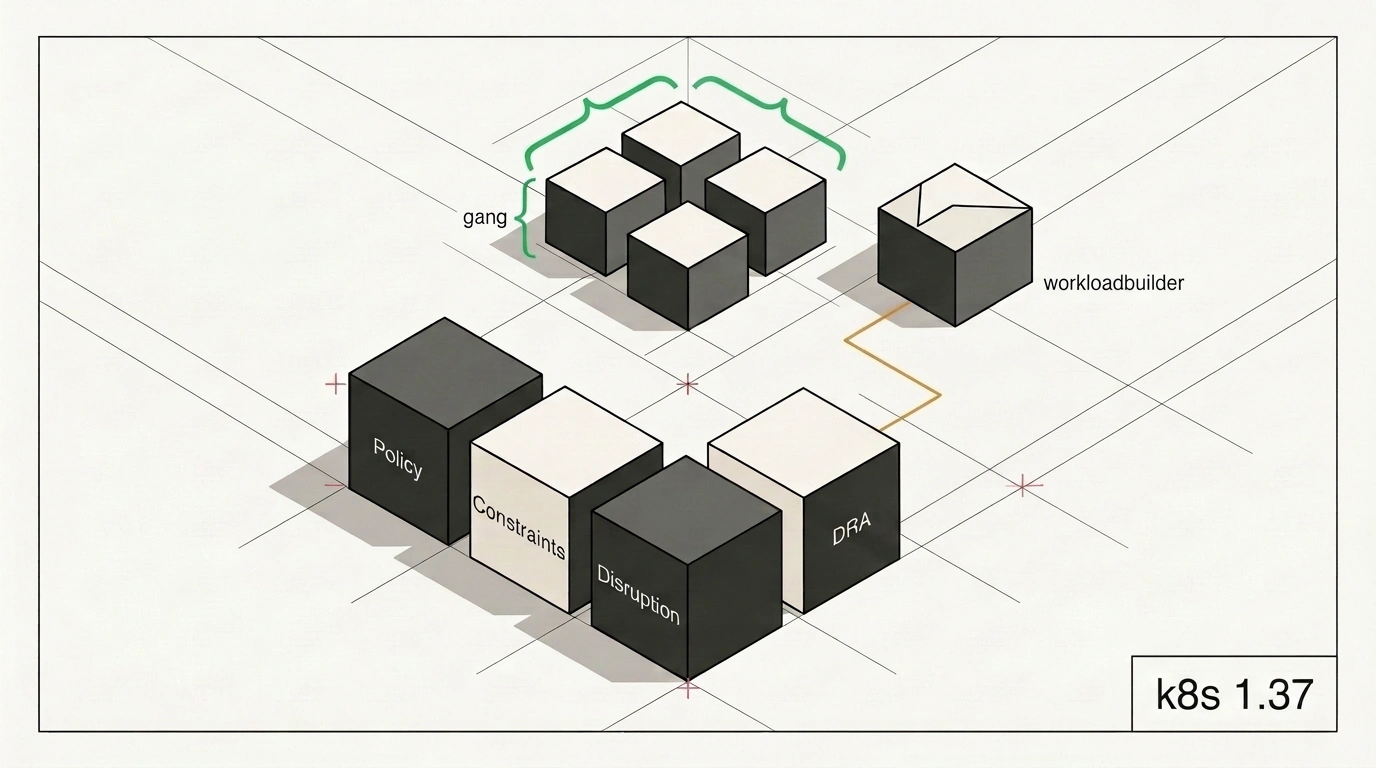
Четыре кирпичика группового планирования
Архитектура WAS разделена на два слоя: ядро планировщика (манифесты Workload и PodGroup переходят в статус Beta в scheduling.k8s.io/v1beta1) и типизированные Go-структуры для авторов операторов (в группе scheduling.k8s.io/v1alpha3).
Вместо того чтобы вручную формировать низкоуровневые объекты ядра, разработчик кастомного CRD просто встраивает в свою спецификацию готовые листовые блоки (WorkloadPodGroup...):
- Scheduling Policy. Задает базовую логику: либо одиночный запуск (
basic), либо групповой кворум (gang) с указанием минимального количества подовminCount. Причем полеminCountсделали мутабельным: размер группы можно динамически менять без пересоздания объекта. - Scheduling Constraints. Топологические ограничения совместного размещения (topology co-location). Ты можешь жестко потребовать, чтобы все поды группы оказались на одном сетевом коммутаторе Infiniband или в одной зоне доступности.
- Disruption Mode. Поведение при вытеснении подов (eviction): сбрасывать поды поодиночке (
single) или прерывать только всю группу целиком (all). Логично, что планировщик запрещает режимallдля обычной политикиbasic. - Resource Claims. Поддержка динамического выделения ресурсов (DRA — Dynamic Resource Allocation), позволяющая запросить GPU на уровне всей группы задач.
Для сложных иерархических систем (например, оператора JobSet, который управляет пачкой обычных Job, или LeaderWorkerSet) предусмотрены композитные блоки WorkloadCompositePodGroup с параметром minGroupCount.
Как контроллер компилирует манифесты
Вот как это выглядит на практике при разработке собственного ML-оператора. Сначала мы встраиваем строительные блоки в Go-спецификацию нашего ресурса:
package v1alpha1

import (
    metav1 "k8s.io/apimachinery/pkg/apis/meta/v1"
    schedulingv1alpha3 "k8s.io/api/scheduling/v1alpha3"
)

// TrainJobSpec описывает распределенную задачу обучения
type TrainJobSpec struct {
    Replicas    int32                                               `json:"replicas"`
    Scheduling  *schedulingv1alpha3.WorkloadPodGroupSchedulingPolicy `json:"scheduling,omitempty"`
    Constraints *schedulingv1alpha3.WorkloadPodGroupConstraints     `json:"constraints,omitempty"`
}
А в цикле согласования (reconcile loop) контроллера мы подключаем официальную разделяемую библиотеку k8s.io/component-helpers/scheduling/workloadbuilder. Она валидирует намерения пользователя и автоматически компилирует дерево задач в объекты планировщика:
package controller

import (
    "context"
    schedulingv1beta1 "k8s.io/api/scheduling/v1beta1"
    "k8s.io/component-helpers/scheduling/workloadbuilder"
)

func (r *TrainJobReconciler) buildWorkload(ctx context.Context, job *TrainJob) (*schedulingv1beta1.Workload, error) {
    // Формируем листовой узел конвейера
    item := workloadbuilder.NewLeafItem("worker").
        WithSchedulingPolicy(job.Spec.Scheduling).
        WithConstraints(job.Spec.Constraints).
        WithDefaultPolicy(schedulingv1alpha3.BasicPolicy)

    // Инициализируем билдер: он сопоставляет ошибки валидации с полями исходного CRD
    builder := workloadbuilder.NewBuilder(item, job.Name, job.Namespace, job)
    if errList := builder.Validate(); len(errList) > 0 {
        return nil, errList.ToAggregate()
    }

    // Компилируем в итоговый манифест ядра v1beta1 Workload
    return builder.BuildWorkload()
}
Здесь кроется важнейшее практическое преимущество: если пользователь допустит ошибку (например, укажет режим all при политике basic), билдер вернет ошибку с точным путем в манифесте пользователя (spec.scheduling.disruptionMode), а не ругнется на скомпилированный внутренний Workload. А с учетом того, как развивается Server-Side Apply в Kubernetes: декларативное управление полями и разграничение владения, согласованность полей CRD и внутренних объектов планировщика становится кристально прозрачной.
Не путай задачи WAS и очереди задач: проект Kueue по-прежнему отвечает за глобальные квоты, бюджеты команд и допуск задач в кластер (admission), а Workload-Aware Scheduling берет на себя атомарную аллокацию нод под запущенную группу.
В итоге Kubernetes 1.37 дает разработчикам платформ чистый фундамент: больше не нужно изобретать велосипед, чтобы научить кластер грамотно запускать большие AI/ML нагрузки.