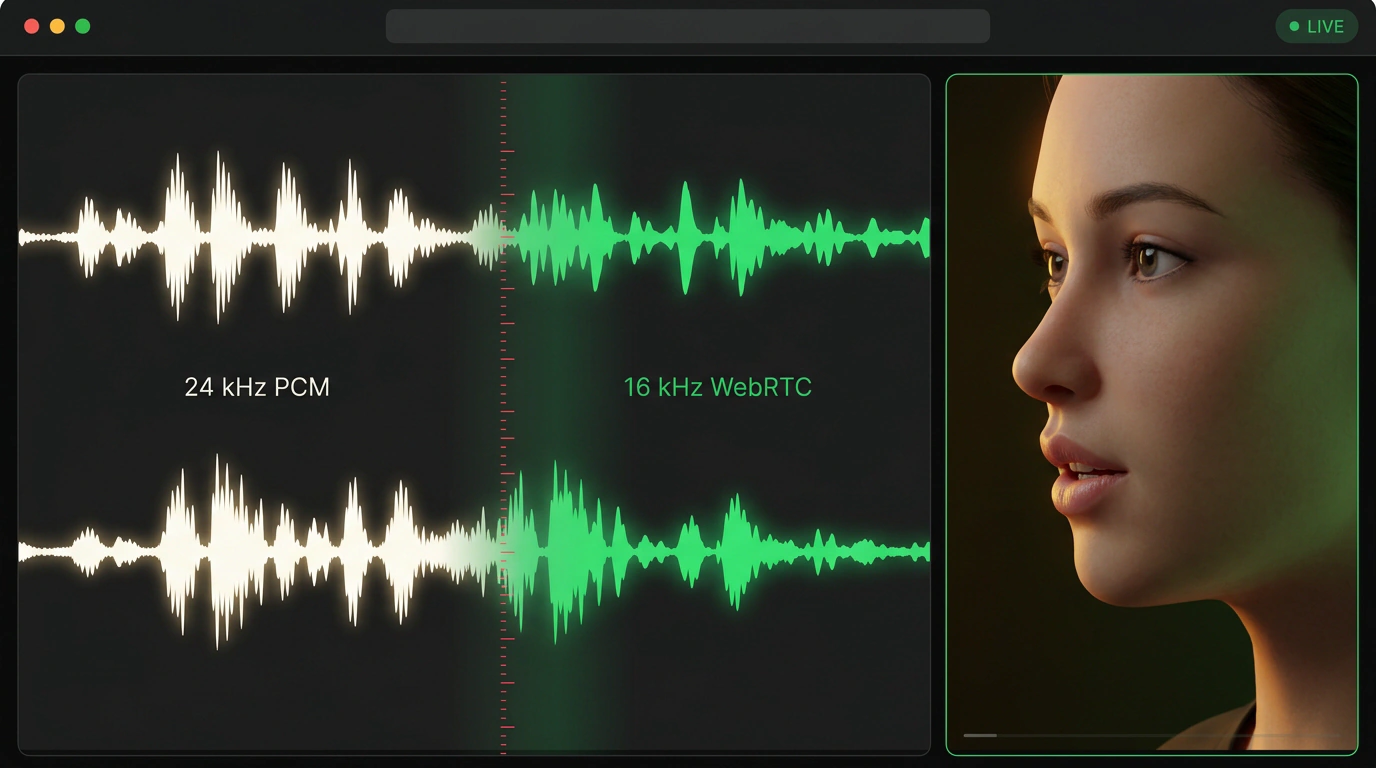


В последнее время все только и говорят о голосовых помощниках с визуальным воплощением: пользователю гораздо приятнее общаться не с безликой аудиоволной на экране, а с живым аватаром, который естественно моргает, наклоняет голову и синхронно шевелит губами в такт речи. Но как только ты садишься проектировать такую систему для русскоязычного сервиса, тебя ждет жесткое столкновение с реальностью.
Готовые зарубежные платформы «всё в одном» (вроде HeyGen или Tavus) ориентированы на английский язык, а при попытке заставить их говорить по-русски выдают неестественный синтетический акцент. В то же время у нас есть отличный речевой движок Yandex Realtime Speech, который безупречно синтезирует русскую речь в потоковом режиме с минимальной задержкой.
Разработчик Евгений Игнатьев (eignatiev) при создании голосового администратора «Айка» решил объединить эти два мира: оставить генерацию голоса надежному облаку Яндекса, а визуализацию лица делегировать сервисам реального времени вроде Anam (модель Cara-4) и Simli.
Я изучил архитектуру получившегося решения, и в ней есть чему поучиться: под капотом скрывается несколько сложнейших инженерных компромиссов.
Проблема частоты: скользящий ресэмплинг звука
Первый же барьер, на который натыкается связка — несовпадение частоты дискретизации. Сервер Yandex Realtime через FastAPI-бэкенд отдает сырой речевой поток событиями pcm_chunk в формате PCM16 с частотой 24 кГц. А вот сервисы генерации аватаров требуют на вход строго 16 кГц.
Если сделать наивный покадровый пересчет аудиочанков, на границах каждого пришедшего пакета возникает микроразрыв фазы. В наушниках пользователя это превращается в неприятный треск и щелчки, а нейросеть аватара начинает судорожно дергать губами.
Чтобы звук оставался кристально чистым, был разработан алгоритм скользящей линейной интерполяции: он сохраняет остаточный дробный сдвиг позиции (pos) и последний сэмпл предыдущего чанка (prev), бесшовно сшивая границы пакетов:
const AVATAR_RATE = 16000;

export const pcmResampler = {
  pos: 0,
  prev: 0,
  reset() {
    this.pos = 0;
    this.prev = 0;
  },
  run(int16: Int16Array, inRate: number): Int16Array {
    const n = int16.length;
    if (!n) return new Int16Array(0);
    const step = inRate / AVATAR_RATE;
    const out = new Int16Array(Math.ceil((n - this.pos) / step) + 1);
    let p = this.pos;
    let k = 0;
    while (p < n - 1) {
      const i = Math.floor(p);
      const f = p - i;
      const a = i < 0 ? this.prev : int16[i];
      // Линейная интерполяция между соседними точками
      out[k++] = Math.round(a + (int16[i + 1] - a) * f);
      p += step;
    }
    this.pos = p - n;
    this.prev = int16[n - 1];
    return out.subarray(0, k);
  },
};
Запуск сессии WebRTC и борьба с Safari на iOS
Второй вызов — передача видеопотока клиенту. Anam рендерит портретное видео 768×1152 и отдает его по протоколу WebRTC.
Вот как выглядит подключение клиентского SDK и стриминг звука:
import { createAnamClient } from "@anam-ai/js-sdk";

async function startAvatarSession(videoElement: HTMLVideoElement) {
  // 1. Получаем одноразовый токен сессии с собственного бэкенда
  const response = await fetch("/voice/avatar-session", { method: "POST" });
  const { sessionToken } = await response.json();

  // 2. Инициализируем клиент Anam и привязываем к HTML5-видео
  const anamClient = createAnamClient(sessionToken, {
    videoElement,
    sessionOptions: { videoQuality: "high" },
  });

  await anamClient.startStreaming();

  // 3. Отправка пересчитанных аудиочанков для анимации мимики
  function feedAudioChunk(rawChunk24k: Int16Array) {
    const chunk16k = pcmResampler.run(rawChunk24k, 24000);
    anamClient.streamAudio(chunk16k);
  }

  return { anamClient, feedAudioChunk };
}
Но в мобильном Safari на iOS разработчика поджидает классическая ловушка автоплея: браузер наотрез отказывается запускать воспроизведение video.play(), если медиапоток получен асинхронно после сетевого запроса токена. Для обхода этого ограничения прямо в момент физического тапа пользователя по кнопке звонка на видеоэлемент временно подается пустой холст canvas.captureStream(). Браузер считает, что воспроизведение началось по воле человека, и последующий приход WebRTC-потока подхватывается без блокировок.
Ранее мы детально изучали, как развивается конкуренция голосовых ИИ-агентов: Claude Voice и ChatGPT Voice вышли в реальное время, и возможность собрать аналогичный интерактивный стек на базе отечественного синтеза речи — отличный шаг вперед.
Сервисы аватаров тарифицируются поминутно и имеют лимиты на одновременные сессии. Если WebRTC-соединение не устанавливается за 15 секунд или исчерпан пул слотов, система не роняет звонок, а плавно гасит видеоокно и продолжает диалог в режиме чистого звука.
В итоге мы получаем живое, отзывчивое лицо ассистента с безупречным русским произношением и устойчивостью к мобильным капризам сети.