Ты наверняка не раз ловил себя на мысли: почему простейшая задача расшифровки короткого голосового сообщения или интервью в веб-приложении до сих пор требует отправки файла на сервер? Мы привыкли к тому, что за каждой кнопкой «Транскрибировать» скрывается связка из тяжелого бэкенда, очередей в Celery, арендованных видеокарт с почасовой оплатой или платных токенов в API OpenAI. Стоит интернет-каналу просесть или серверу перегрузиться — и пользователь видит вечный спиннер. А если данные конфиденциальны (медицинские записи, юридические консультации, внутренняя планерка)? Отправлять сырой звук на сторонние облака часто прямо запрещено регламентами.
Я долго присматривался к попыткам запустить речевые модели локально на клиенте. Раньше это всегда было компромиссом: либо сборка Whisper на WebAssembly, которая грузит процессор ноутбука под 100% и греет колени, выдавая расшифровку в три раза медленнее реального времени, либо необходимость тащить в бандл монструозный FFmpeg на десятки мегабайт ради банальной распаковки аудиодорожки из MP4. Но недавно разработчик Танприт Сингх Джолли (Tanpreet Singh Jolly) выкатил открытую библиотеку browser-whisper, и она наконец-то собирает этот пазл воедино.
Как это устроено под капотом
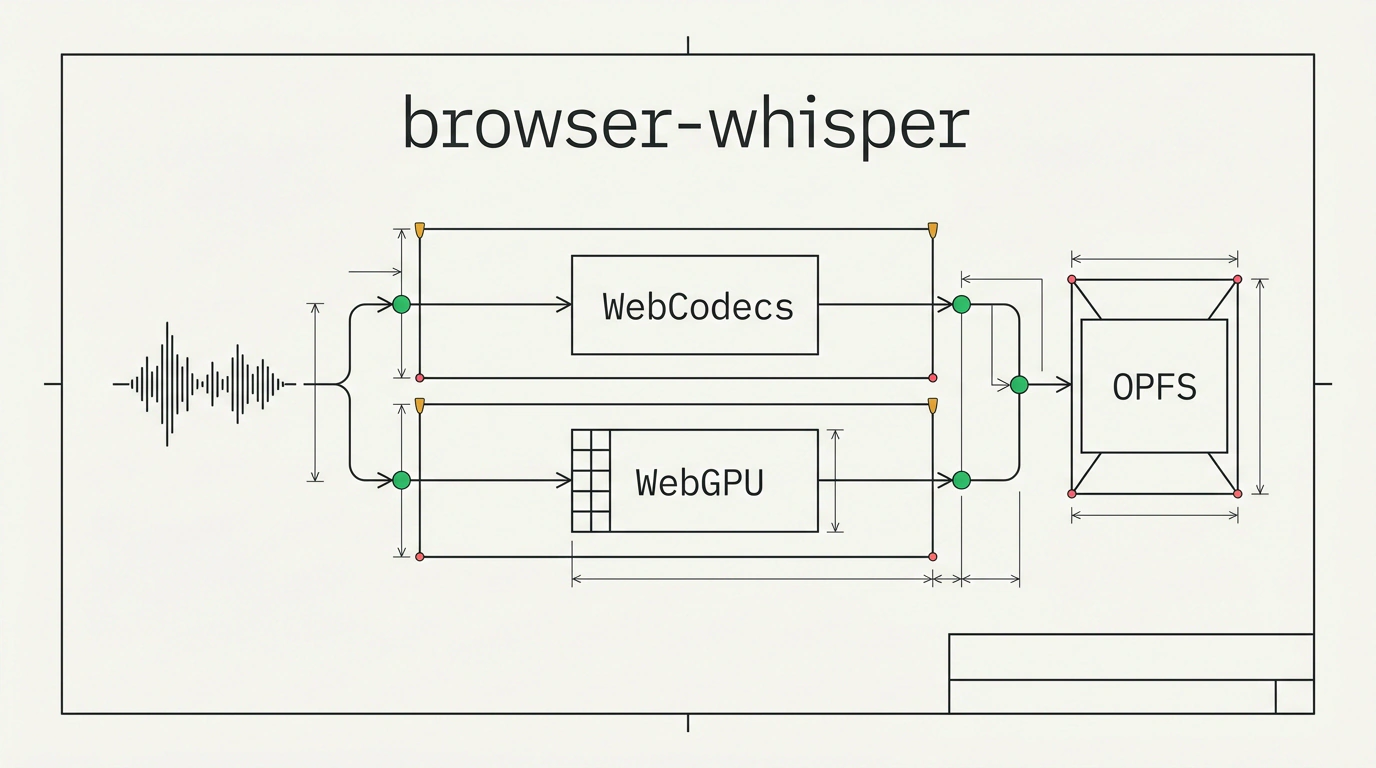
Главная фишка проекта — отказ от программных костылей в пользу современных стандартов веба. Здесь работают сразу три ключевые технологии:
- WebGPU вместо чистого CPU. Вычисления нейросети выполняются напрямую на графическом процессоре клиентского устройства через ONNX Runtime Web. Матричные операции Whisper ложатся на шейдеры видеокарты, обеспечивая околонативную скорость. Если WebGPU в браузере недоступен или отключен аппаратно, библиотека прозрачно переключается на запасной режим WebAssembly.
- WebCodecs и mediabunny вместо FFmpeg. Раньше львиная доля веса клиентских аудиоплееров уходила на декодер медиаконтейнеров. В
browser-whisperраспаковкой занимается микроскопический парсерmediabunny, который передает сырые сжатые пакеты нативному браузерному APIWebCodecs. Браузер сам декодирует MP3, AAC, Opus или видеодорожки прямо в монофонический поток с частотой 16 кГц. - Кэширование весов в OPFS. После первой загрузки веса модели сохраняются в Origin Private File System — изолированной файловой системе браузера. При повторном открытии страницы приложение работает мгновенно и полностью офлайн.
Но больше всего меня порадовала архитектура из двух веб-воркеров. Вспомни: когда ты запускаешь тяжелую операцию в JavaScript, интерфейс часто намертво замирает. В browser-whisper конвейер физически разнесен на два независимых потока: воркер декодирования читает файл и нарезает чанки звука, а воркер Whisper прогоняет их через модель. Пока аудио парсится, нейросеть уже инициализируется, а основной поток отрисовки (UI) остается абсолютно отзывчивым. Ранее мы уже подробно разбирали, как устроен захват звука в Manifest V3 и перевод единым потоком, и архитектура browser-whisper отлично дополняет этот арсенал.
Подключение и практический запуск
Библиотека устанавливается через стандартный пакетный менеджер:
npm install browser-whisper
# или в проектах на Bun:
bun add browser-whisper
Для старта достаточно выбрать подходящий размер модели. По умолчанию используется гибридная квантизация (hybrid quantization: энкодер в fp32 для точности, декодер в q4 для компактности). Модель whisper-tiny весит всего около 120 МБ, whisper-base — 206 МБ, а для максимальной точности доступен whisper-large-v3-turbo (~2.9 ГБ).
Вот как выглядит обработка файла с потоковым получением сегментов через асинхронный итератор:
import { BrowserWhisper } from 'browser-whisper';

// Инициализируем распознаватель с моделью whisper-base
const whisper = new BrowserWhisper({
  model: 'whisper-base',
  language: 'ru', // если опустить, сработает автоопределение языка
});

const fileInput = document.querySelector('input[type=file]') as HTMLInputElement;
const file = fileInput.files?.[0];

if (file) {
  // Сегменты поступают по мере распознавания без ожидания конца файла
  for await (const { text, start, end } of whisper.transcribe(file)) {
    console.log(`[${start.toFixed(1)}с – ${end.toFixed(1)}с] ${text}`);
  }
}
Если же тебе нужно распознавать речь прямо с микрофона в реальном времени, у библиотеки есть метод transcribePCM(samples). Ты передаешь массив Float32Array с частотой 16 кГц от AudioContext, связываешь его с детектором активности голоса (VAD) — и получаешь живой интерфейс диктовки без единого обращения к серверу.
Для максимальной производительности многопоточного WASM и разделяемой памяти SharedArrayBuffer твой веб-сервер должен отдавать заголовки кросс-доменной изоляции: Cross-Origin-Opener-Policy: same-origin и Cross-Origin-Embedder-Policy: require-corp. Без них библиотека продолжит работать, но перейдет в однопоточный режим.
Смотри, к чему мы пришли: нулевая стоимость серверных инстансов, строгая защита приватности данных и работа даже в режиме полета без доступа к сети. Да, первая загрузка 120 МБ требует аккуратного прогресс-бара для пользователя, но для корпоративных сервисов, заметочников и личных инструментов это настоящий прорыв.