

Ты наверняка не раз ловил себя на мысли: «Я точно где-то читал классную мысль об этом полгода назад, но где именно — хоть убей, не помню». Открываешь закладки браузера — там тысячи сохранённых страниц. Открываешь стандартное приложение заметок — сплошной хаос из обрывков мыслей, скриншотов и рецептов пиццы.
Большинство попыток собрать персональную базу знаний (Personal Knowledge Base) превращаются в цифровое кладбище. Мы усердно копируем ссылки, надеясь когда-нибудь к ним вернуться, но реальная польза от этого стремится к нулю.
Ещё в 1945 году американский учёный Ваневар Буш в легендарном эссе «As We May Think» описал концепт машины Memex — устройства, которое должно было стать продолжением человеческой памяти через сеть ассоциативных связей. Сегодня, спустя 80 лет, мы наконец-то можем собрать рабочий Memex на своём ноутбуке.
Я протестировал связку из открытого редактора Obsidian, принципов немецкого социолога Никласа Лумана (метод Zettelkasten) и аналитического контекста Claude. Результат превзошёл ожидания: вместо пассивного склада заметок получается активный собеседник, помогающий думать и находить неочевидные инсайты.
Архитектура Compounding Vault: три уровня порядка
Главная ошибка новичков — пытаться заставить нейросеть «переварить» гигантские куски сырого текста. Если просто скормить модели сорок PDF-файлов, ты получишь поверхностный дайджест, перегруженный банальностями (тот самый AI Slop).
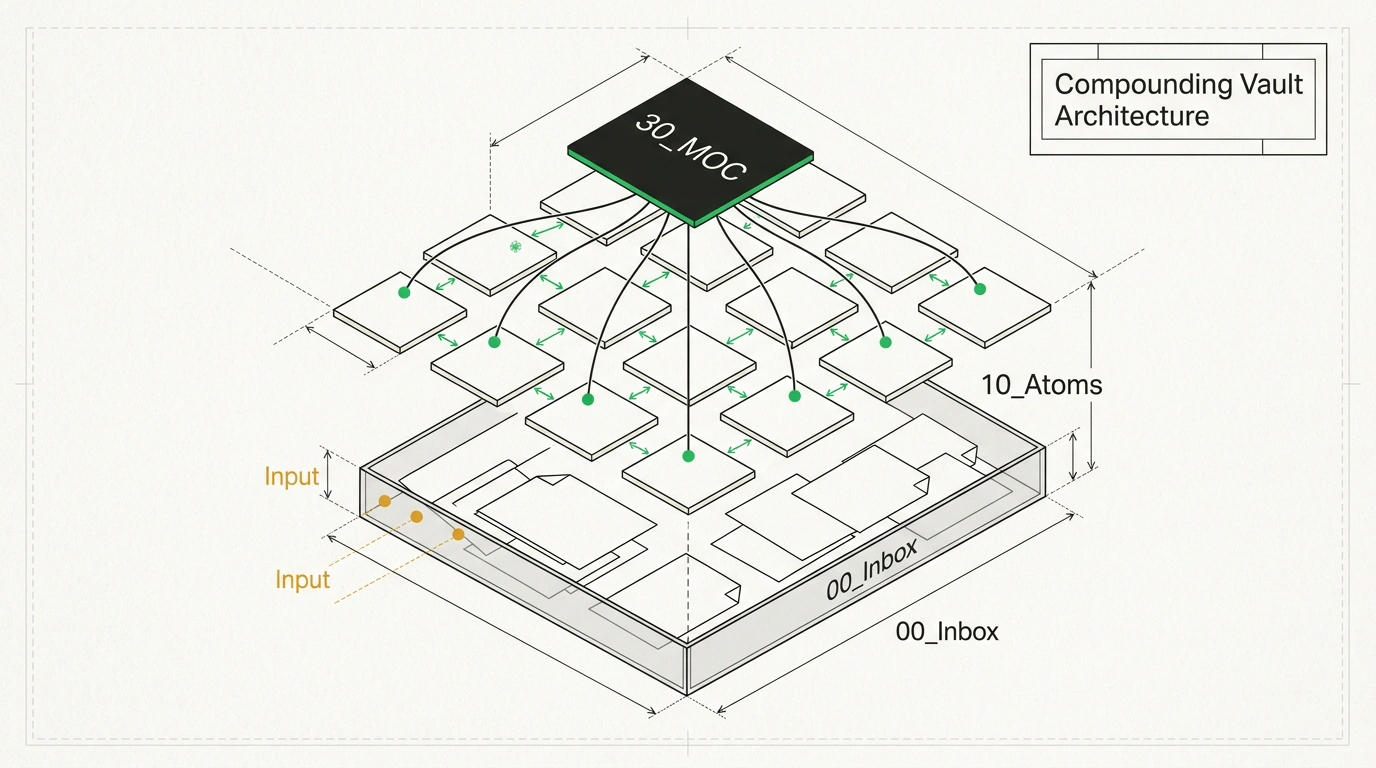
Исследователь Nick Saraev предложил элегантную трехуровневую структуру накопительного хранилища (Compounding Vault):
- Входящий слой (00_Inbox): временный отстойник для ссылок, голосовых заметок и сырых цитат. Сюда попадает всё без разбора, но хранится не дольше недели.
- Атомарный слой (10_Atoms): сердце базы. Здесь действует строгое правило Zettelkasten: одна заметка — ровно одна законченная мысль. Каждая карточка снабжается метаданными и связывается ссылками вида
[[Имя заметки]]с другими идеями. - Карты контента (30_MOC): обзорные хабы (Maps of Content), объединяющие десятки атомов в цельные темы (например, «Архитектура микросервисов» или «Принципы здорового сна»).
Все заметки хранятся локально в виде обычных файлов Markdown на твоём диске. Никаких проприетарных баз, закрытых форматов и риска потерять доступ, если сервис решит изменить условия подписки.
Шаблон атомарной заметки
Чтобы ИИ мог эффективно ориентироваться в твоих мыслях, каждой карточке нужен стандартизированный заголовок (YAML-frontmatter). Создай шаблон 90_Meta/template_atom.md:
---
id: "{{date:YYYYMMDDHHmm}}"
title: "{{title}}"
created: "{{date:YYYY-MM-DDTHH:mm:ss}}"
tags:
  - knowledge
  - atomic
status: active
related: []
---

# {{title}}

## Суть идеи
<!-- Краткая формулировка идеи своими словами в 1-2 предложениях -->

## Обоснование и факты
<!-- Проверенные аргументы, числа и личные наблюдения -->

## Связанные заметки
<!-- Двунаправленные перекрестные ссылки [[Имя другой заметки]] -->
Обрати внимание на поле status: оно позволяет фильтровать проверенные записи от черновых гипотез. Ранее мы уже подробно разбирали, как грамотная разметка спасает от путаницы в материале о проектировании базы знаний в Obsidian, а также в статье о борьбе с деградацией памяти.
Подключение Claude: мост без утечки персональных данных
Как подключить интеллект модели к локальным файлам? Автор канала Julian Goldie SEO рекомендует открытый плагин Claude Sync V2.
В отличие от облачных надстроек, плагин общается напрямую с API Anthropic через твой личный ключ (sk-ant-...). Файлы не выгружаются на сторонние серверы, а эмбеддинги для векторного поиска кешируются прямо в локальной папке .obsidian.
Когда в базе накопится пара сотен атомов, вручную отслеживать все перекрёстные связи станет тяжело. Вот компактный Python-скрипт, который считывает метаданные и просит Claude найти скрытые мостики между твоими идеями:
import os
import glob
import frontmatter
from anthropic import Anthropic

client = Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))

def analyze_and_link_notes(vault_path):
    atom_files = glob.glob(os.path.join(vault_path, "10_Atoms", "*.md"))
    notes_summary = []

    for fpath in atom_files[:50]:
        post = frontmatter.load(fpath)
        notes_summary.append({
            "file": os.path.basename(fpath),
            "title": post.get("title", "Untitled"),
            "content": post.content[:300]
        })

    prompt = (
        "Given these atomic notes from personal knowledge base, "
        "identify missing conceptual links between them:\n"
        f"{notes_summary}\n"
        "Return pairs of notes that should be linked with a brief rationale."
    )

    response = client.messages.create(
        model="claude-3-5-sonnet-20241022",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}]
    )
    return response.content[0].text

print("Obsidian-Claude connector configured.")
Не пытайся оцифровать всё прочитанное за один присест. Возьми за правило создавать всего одну-две атомарные карточки в день по итогам реальных задач или инсайтов. Через полгода у тебя будет персональная база из 300 выверенных мыслей, знающая твои проекты лучше любого консультанта.
Как сделать так, чтобы база не умерла через месяц
Главный секрет долговечности базы знаний — дисциплина атомизации. Не копируй статьи целиком. Прочитал главу книги или сложный технический отчёт? Сформулируй один главный вывод своими словами, оформи карточку по шаблону и запусти анализ связей.
Когда Claude подсвечивает: «Твоя сегодняшняя мысль о распределённых очередях логически продолжает заметку полугодовой давности о транзакциях в базе данных», ты физически ощущаешь, как разрозненные знания начинают работать на тебя.