Seguro que más de una vez te has hecho esta pregunta: ¿por qué una tarea tan simple como transcribir una nota de voz corta o una entrevista en una app web sigue exigiendo enviar el archivo a un servidor? Estamos tan acostumbrados a que detrás de cada botón de «Transcribir» haya un backend pesado, colas en Celery, tarjetas gráficas alquiladas por horas o tokens de pago en la API de OpenAI, que ya ni lo cuestionamos. Basta con que baje la velocidad de tu conexión o se sature el servidor para que aparezca el spinner infinito. Y eso sin hablar de datos confidenciales (historiales médicos, consultas legales, reuniones internas), donde subir el audio sin procesar a nubes de terceros suele estar directamente prohibido por normativa.
Llevo tiempo siguiendo de cerca los intentos por ejecutar modelos de voz de forma local en el cliente. Hasta ahora siempre tocaba elegir entre dos males: o una compilación de Whisper en WebAssembly que pone la CPU del portátil al 100%, te calienta las piernas y transcribe tres veces más lento que el tiempo real, o arrastrar en el bundle un FFmpeg monstruoso de decenas de megabytes solo para extraer la pista de audio de un MP4. Hace poco, sin embargo, el desarrollador Tanpreet Singh Jolly publicó la librería abierta browser-whisper, y por fin encaja todas las piezas del puzle.
Cómo funciona por dentro
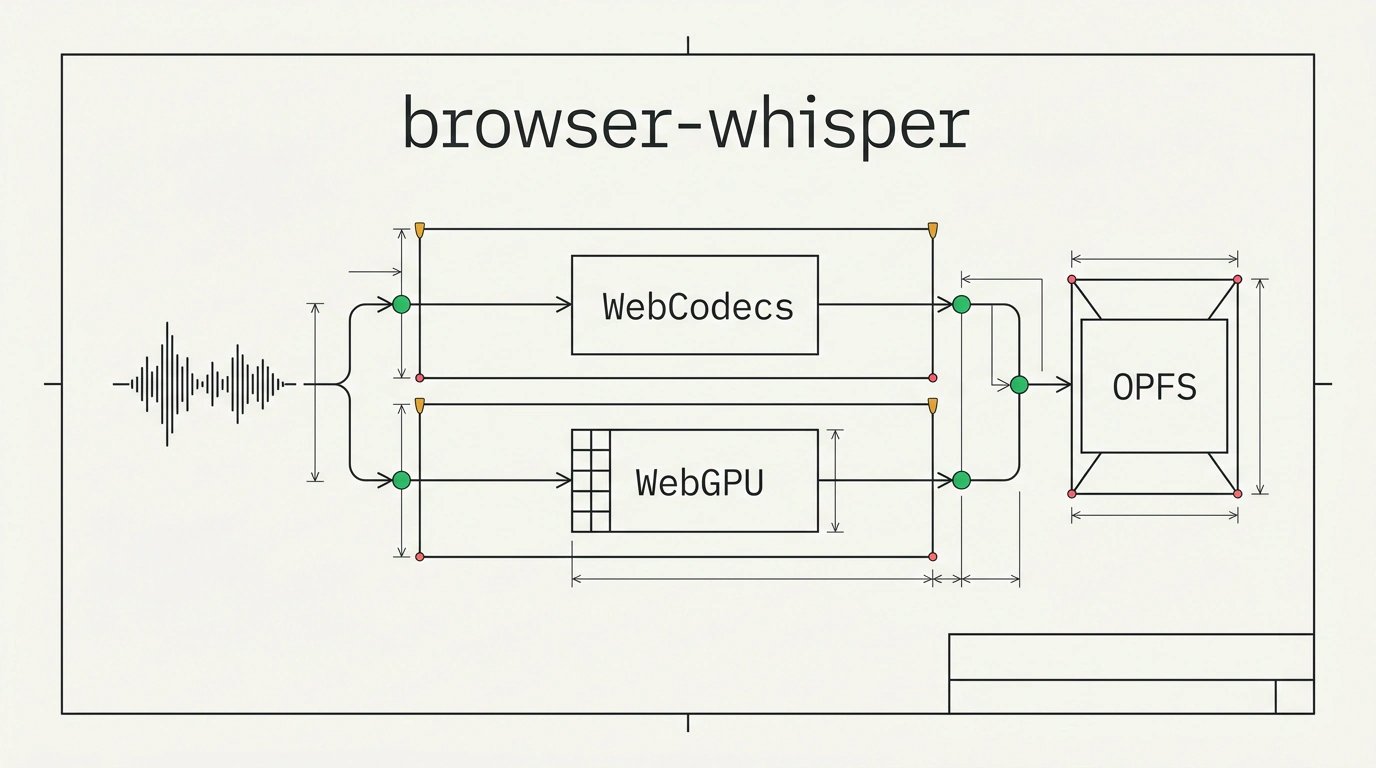
La gracia del proyecto está en dejar atrás los apaños por software y apoyarse en estándares web modernos. Aquí trabajan juntas tres tecnologías clave:
- WebGPU en lugar de solo CPU. Los cálculos de la red neuronal se ejecutan directamente en la tarjeta gráfica del dispositivo del usuario mediante ONNX Runtime Web. Las operaciones matriciales de Whisper pasan a los shaders de la GPU, logrando una velocidad casi nativa. Si el navegador no tiene WebGPU disponible o está desactivado por hardware, la librería cambia de forma transparente al modo de respaldo con WebAssembly.
- WebCodecs y mediabunny en lugar de FFmpeg. Antes, gran parte del peso de los reproductores web se iba en decodificadores de contenedores multimedia. En
browser-whisper, de desempaquetar el archivo se encarga el diminuto parsermediabunny, que entrega los paquetes comprimidos en bruto a la API nativaWebCodecsdel navegador. Es el propio navegador quien decodifica MP3, AAC, Opus o pistas de vídeo directamente a un flujo mono de 16 kHz. - Caché de pesos en OPFS. Tras la primera descarga, los pesos del modelo se guardan en Origin Private File System, el sistema de archivos aislado del navegador. La próxima vez que abres la página, la aplicación arranca al instante y funciona completamente sin conexión.
Pero lo que más me gustó fue su arquitectura de dos Web Workers. Piénsalo: cuando lanzas una operación pesada en JavaScript, la interfaz suele quedarse congelada. En browser-whisper, el pipeline se divide físicamente en dos hilos independientes: el worker de decodificación lee el archivo y lo trocea en fragmentos de audio, mientras que el worker de Whisper los pasa por el modelo. Mientras se parsea el audio, la red neuronal ya se está inicializando y el hilo principal de renderizado (UI) sigue respondiendo sin tirones. Ya vimos en otra ocasión cómo funciona la captura de audio en Manifest V3 y la traducción en un único flujo, y la arquitectura de browser-whisper encaja de maravilla en ese mismo enfoque.
Instalación y puesta en marcha
La librería se instala con cualquier gestor de paquetes estándar:
npm install browser-whisper
# o en proyectos con Bun:
bun add browser-whisper
Para empezar basta con elegir el tamaño de modelo que te convenga. Por defecto usa cuantización híbrida (hybrid quantization: el codificador en fp32 para mantener la precisión y el decodificador en q4 para ocupar menos). El modelo whisper-tiny pesa alrededor de 120 MB, whisper-base ocupa 206 MB y, si buscas la máxima precisión, tienes whisper-large-v3-turbo (~2.9 GB).
Así se procesa un archivo recibiendo los segmentos en streaming mediante un iterador asíncrono:
import { BrowserWhisper } from 'browser-whisper';

// Inicializamos el reconocedor con el modelo whisper-base
const whisper = new BrowserWhisper({
  model: 'whisper-base',
  language: 'ru', // si se omite, se activa la detección automática de idioma
});

const fileInput = document.querySelector('input[type=file]') as HTMLInputElement;
const file = fileInput.files?.[0];

if (file) {
  // Los segmentos llegan a medida que se transcriben, sin esperar al final del archivo
  for await (const { text, start, end } of whisper.transcribe(file)) {
    console.log(`[${start.toFixed(1)}s – ${end.toFixed(1)}s] ${text}`);
  }
}
Si lo que necesitas es transcribir voz en tiempo real directo desde el micrófono, la librería incluye el método transcribePCM(samples). Le pasas un Float32Array a 16 kHz desde AudioContext, lo combinas con un detector de actividad de voz (VAD) y tienes un dictado en vivo sin hacer ni una sola petición al servidor.
Para exprimir al máximo WASM multihilo y la memoria compartida SharedArrayBuffer, tu servidor web debe enviar las cabeceras de aislamiento de origen cruzado: Cross-Origin-Opener-Policy: same-origin y Cross-Origin-Embedder-Policy: require-corp. Sin ellas la librería seguirá funcionando, pero caerá a modo monohilo.
Fíjate adónde hemos llegado: coste cero en instancias de servidor, privacidad total de los datos y funcionamiento incluso en modo avión sin internet. Es cierto que la primera descarga de 120 MB exige mostrar al usuario una buena barra de progreso, pero para herramientas corporativas, apps de notas y utilidades personales es un salto enorme.