Últimamente no se habla de otra cosa que de asistentes de voz con presencia visual: al usuario le resulta mucho más agradable hablar no con una onda de audio sin rostro en la pantalla, sino con un avatar vivo que parpadea con naturalidad, ladea la cabeza y mueve los labios al compás de lo que dice. Pero en cuanto te sientas a diseñar un sistema así para un servicio en ruso, chocas de frente con la realidad.
Las plataformas extranjeras «todo en uno» (como HeyGen o Tavus) están pensadas para el inglés, y cuando intentas que hablen ruso sueltan un acento sintético muy artificial. Al mismo tiempo, contamos con el excelente motor Yandex Realtime Speech, que sintetiza ruso en streaming con una latencia mínima.
Al crear el asistente de voz «Aika», el desarrollador Evgueni Ignátiev (eignatiev) decidió unir ambos mundos: dejar la generación de voz en la nube fiable de Yandex y delegar la animación facial en servicios de tiempo real como Anam (modelo Cara-4) y Simli.
Estuve estudiando la arquitectura de la solución y hay bastante que aprender: bajo el capó esconde varios compromisos de ingeniería muy finos.
El problema de la frecuencia: remuestreo deslizante de audio
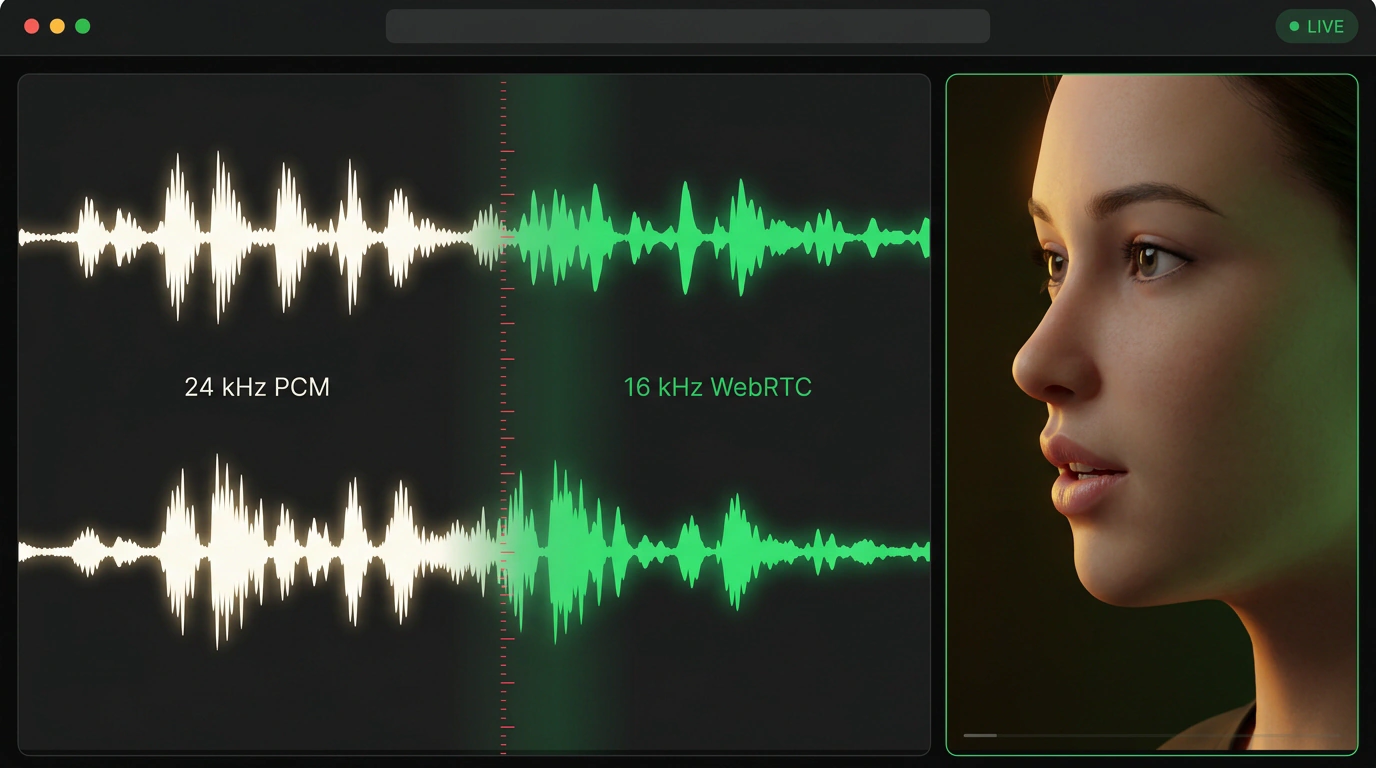
La primera barrera con la que topa esta combinación es la diferencia de frecuencia de muestreo. El servidor de Yandex Realtime, a través del backend en FastAPI, entrega el flujo de voz en bruto mediante eventos pcm_chunk en formato PCM16 a 24 kHz. En cambio, los servicios de generación de avatares exigen en la entrada exactamente 16 kHz.
Si haces un recálculo ingenuo paquete por paquete, en la frontera entre cada chunk aparece una microdiscontinuidad de fase. En los auriculares del usuario eso se oye como chasquidos y crujidos molestos, y la red neuronal del avatar empieza a mover los labios a tirones.
Para mantener el sonido cristalino, diseñaron un algoritmo de interpolación lineal deslizante: guarda el desplazamiento fraccionario residual (pos) y la última muestra del paquete anterior (prev), cosiendo sin costuras las fronteras entre paquetes:
const AVATAR_RATE = 16000;

export const pcmResampler = {
  pos: 0,
  prev: 0,
  reset() {
    this.pos = 0;
    this.prev = 0;
  },
  run(int16: Int16Array, inRate: number): Int16Array {
    const n = int16.length;
    if (!n) return new Int16Array(0);
    const step = inRate / AVATAR_RATE;
    const out = new Int16Array(Math.ceil((n - this.pos) / step) + 1);
    let p = this.pos;
    let k = 0;
    while (p < n - 1) {
      const i = Math.floor(p);
      const f = p - i;
      const a = i < 0 ? this.prev : int16[i];
      // Interpolación lineal entre muestras adyacentes
      out[k++] = Math.round(a + (int16[i + 1] - a) * f);
      p += step;
    }
    this.pos = p - n;
    this.prev = int16[n - 1];
    return out.subarray(0, k);
  },
};
Arranque de la sesión WebRTC y la batalla con Safari en iOS
El segundo reto es enviar el flujo de vídeo al cliente. Anam renderiza vídeo en formato vertical de 768×1152 y lo transmite por WebRTC.
Así es como se conecta el SDK del cliente y se transmite el audio:
import { createAnamClient } from "@anam-ai/js-sdk";

async function startAvatarSession(videoElement: HTMLVideoElement) {
  // 1. Obtenemos un token de sesión de un solo uso desde nuestro backend
  const response = await fetch("/voice/avatar-session", { method: "POST" });
  const { sessionToken } = await response.json();

  // 2. Inicializamos el cliente de Anam y lo vinculamos al vídeo HTML5
  const anamClient = createAnamClient(sessionToken, {
    videoElement,
    sessionOptions: { videoQuality: "high" },
  });

  await anamClient.startStreaming();

  // 3. Envío de los chunks de audio remuestreados para animar la expresión facial
  function feedAudioChunk(rawChunk24k: Int16Array) {
    const chunk16k = pcmResampler.run(rawChunk24k, 24000);
    anamClient.streamAudio(chunk16k);
  }

  return { anamClient, feedAudioChunk };
}
Pero en Safari móvil en iOS espera la clásica trampa del autoplay: el navegador se niega en redondo a ejecutar video.play() si el flujo multimedia llega de forma asíncrona tras pedir el token por red. Para sortear esa restricción, justo en el momento del toque físico del usuario en el botón de llamada se inyecta temporalmente un lienzo vacío canvas.captureStream() en el elemento de vídeo. El navegador interpreta que la reproducción empezó por acción humana y, cuando llega después el flujo WebRTC, lo engancha sin bloqueos.
Ya analizamos antes cómo evoluciona la competencia entre agentes de voz con IA: Claude Voice y ChatGPT Voice pasan al tiempo real, y poder montar un stack interactivo equivalente sobre síntesis de voz local es un gran paso adelante.
Los servicios de avatares se tarifican por minuto y tienen límites de sesiones simultáneas. Si la conexión WebRTC no se establece en 15 segundos o se agota el cupo de slots, el sistema no corta la llamada: oculta suavemente la ventana de vídeo y continúa la conversación solo por voz.
El resultado es un rostro vivo y ágil para el asistente, con pronunciación rusa impecable y resistencia a los caprichos de la red móvil.