Edición 25 de octubreDigest del día · 17 materiales
Qué hay en esta ediciónRevisamos 30 fuentes, reunimos 17 materiales
Bodegón de estudio del puesto de trabajo de un ingeniero con pantalla de terminal Linux, chip de silicio expuesto y esquema del modelo Kimi K3.1 Pro.
A fondoIAInteligencia artificialAlgoritmosBenchmarks

Kimi K3.1 Pro: el modelo chino de pesos abiertos al nivel de Claude Opus 5.5

Solíamos dar por hecho que las redes neuronales abiertas iban irremediablemente por detrás de los modelos propietarios insignia en administración de sistemas y razonamiento en terminal. Pero los últimos benchmarks de Kimi K3.1 Pro le dan la vuelta a esa idea: el modelo chino con arquitectura Mixture-of-Experts de 2,8 billones de parámetros obtuvo un 65,7 % en Terminal-Bench 4.0, pisándole los talones a Claude Opus 5.5 (66,4 %) y superando con claridad a GPT-6 Astra (58,2 %). En el artículo analizo al detalle el enrutamiento disperso de 104 mil millones de pesos activos, el agente de escritorio y lo que supone la apertura de sus pesos en noviembre para el desarrollo independiente.
👍 0
Julian Goldie SEOMatthew BermanArtificial Analysis: Kimi K3.1 Pro Independent BenchmarksMoonshot AI: Architecture and Open-Weight Roadmap for Kimi K3.1 Pro
25 de octubre
Bodegón cinematográfico de un escritorio con teléfono móvil y ultrabook mostrando el briefing matinal de Claude Duet.
ArtículoIAInteligencia artificialAutomatizaciónProductividad

Claude Duet: el agente personal de Anthropic para trabajar en tándem con Opus 5.5

Los chatbots tradicionales obligan al usuario a mantener abierta una pestaña del navegador y copiar prompts a mano cada vez que cambian los datos. Anthropic propone una alternativa de raíz: la aplicación autónoma Claude Duet, que corre en una máquina en la nube dedicada incluso con el móvil apagado. A diferencia de los proyectos pasivos de ChatGPT, Duet monitoriza de forma continua tus canales corporativos, prepara un resumen matinal de tareas y permite editar el código de los artefactos por voz en tiempo real. Analizamos dónde compensa la suscripción de este asistente proactivo y dónde topa con límites de cuota y latencia de renderizado.

👍 0
Riley BrownAnthropic: Introducing Claude Duet Proactive Personal Agent
25 de octubre
Macrofotografía de estudio de un micrófono vintage con una onda sonora luminosa dinámica del habla real del modelo Dessa.
ArtículoIAInteligencia artificialVozInnovación

Dessa de Block: el modelo de voz de IA entrenado exclusivamente con habla real

Durante años se asumió que la síntesis de voz humana tenía que pasar por el triple filtro de «transcribir a texto → generar respuesta con un modelo de lenguaje → locutar con un sintetizador». El modelo experimental Dessa del grupo fintech Block desmonta ese dogma eliminando por completo el texto del proceso de pensamiento. Entrenada directamente sobre cientos de miles de horas de grabaciones de audio reales, la red neuronal ofrece dúplex completo real con latencia inferior a 200 ms: se ríe a mitad de frase, capta el sarcasmo por el timbre y puede ejecutarse en local en un MacBook Pro M4 Max sin enviar audio a la nube.

👍 0
Julian Goldie SEOBlock: Research Preview of Dessa Conversational Audio ModelUnite AI: Inside Block's Full-Duplex Speech Model Dessa
25 de octubre
Noticias · 25 de octubre1 noticia

GPT-6.1 Sol y la migración de COBOL: salto de precisión del 5 % al 98 % en código bancario

La migración automática de código legado en COBOL llevaba años bloqueada por errores de redondeo bancario. El nuevo modelo OpenAI GPT-6.1 Sol ha logrado un salto de precisión del 5,4 % al 97,9 % con razonamiento profundo, garantizando equivalencia exacta al byte de la lógica en Python y Java y reduciendo un 39 % los costes de inferencia.

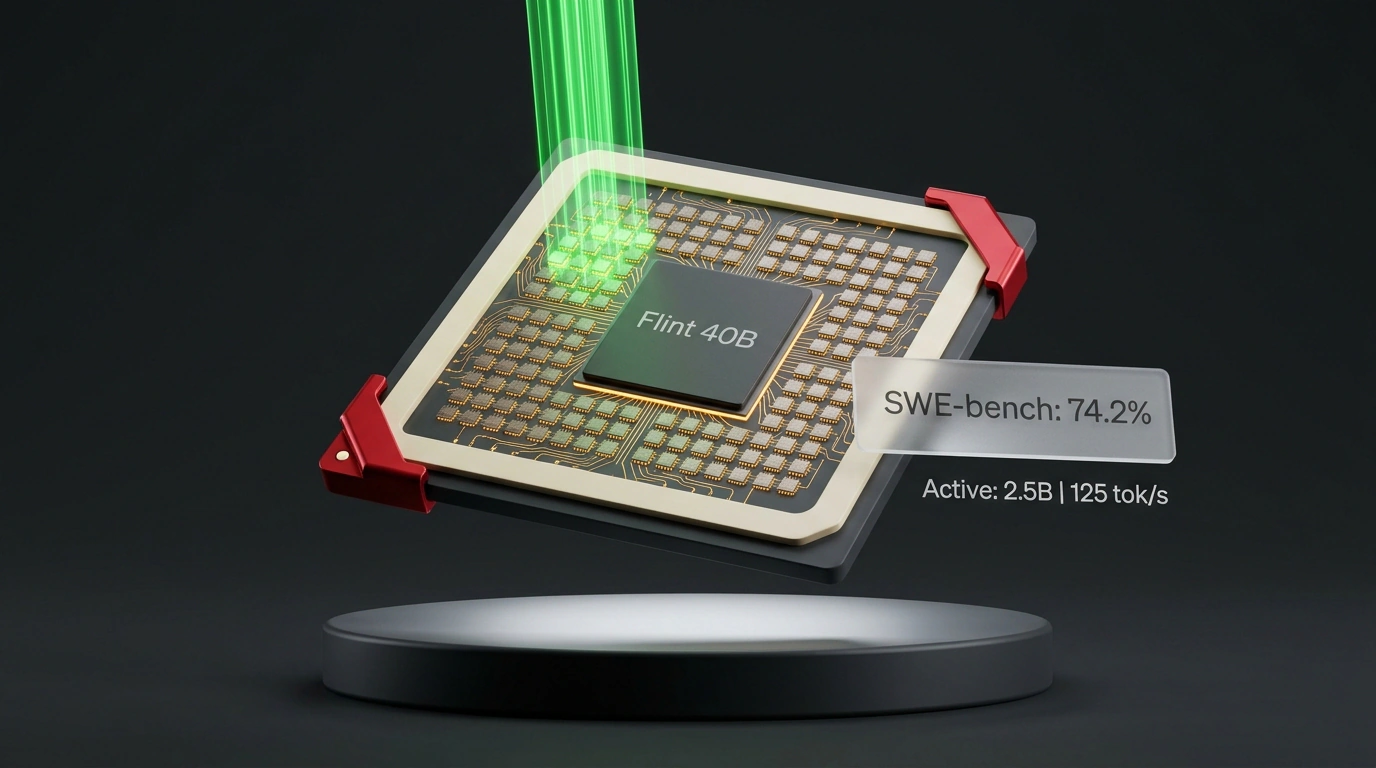
Renderizado 3D futurista del procesador de cristal de silicio Flint 40B con una red ultradispersa de 256 micronúcleos.
ArtículoIAInteligencia artificialDesarrolloOpen Source

Flint 40B de Recursive: el modelo abierto ultrarrápido para programar en local

¿Se puede ejecutar un modelo abierto para programar en un portátil normal sin que se atasque en cada línea y resolviendo de verdad bugs complejos de arquitectura? El equipo de Recursive ha respondido con el lanzamiento de Flint 40B bajo licencia Apache 2.0. Gracias a una estructura ultradispersa de 256 expertos, en cada token solo se activan 2,5 mil millones de parámetros, lo que arroja más de 125 tokens por segundo en chips Apple M4 Pro con un récord del 74,2 % en el benchmark SWE-bench Verified. Te muestro cómo desplegar este asistente privado en entorno local con llama.cpp y conectarlo a tu editor.

👍 0
Julian Goldie SEORecursive AI: Launching Flint 40B - Open Weights Agentic CodingMarkTechPost: In-Depth Technical Review of Flint 40B MoE Architecture
25 de octubre
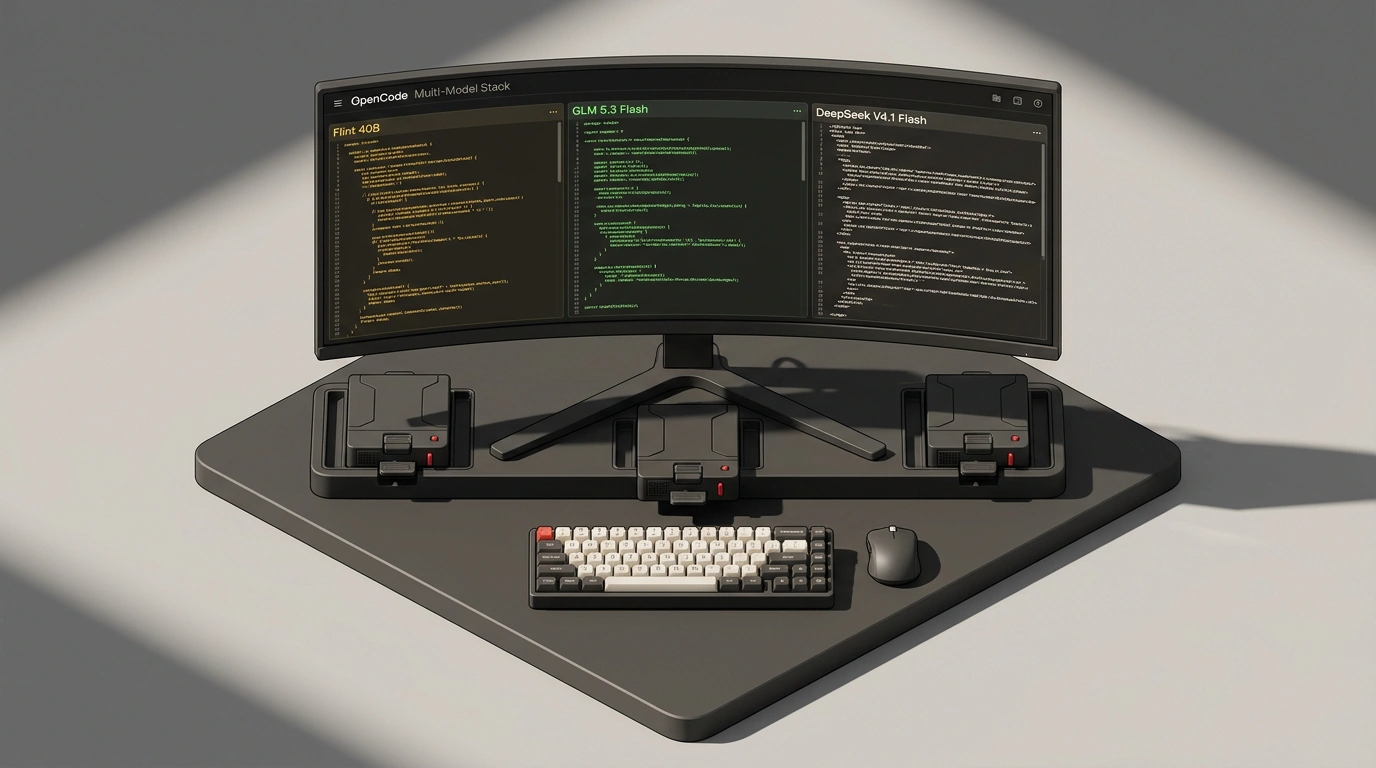
Escena isométrica de una terminal modular de desarrollador con el panel de tres secciones de modelos de OpenCode.
Resumen temático2 seccionesIAInteligencia artificialDesarrolloAutomatización

Modelos abiertos rápidos dentro de OpenCode: un stack gratuito para programación agéntica

Las suscripciones comerciales a asistentes de programación en la nube abren rápido un boquete en el presupuesto si lanzas cientos de tests intermedios y boilerplate rutinario. El entorno OpenCode ha resuelto ese problema integrando los veloces modelos abiertos Zhipu GLM 5.3 Flash y DeepSeek V4.1 Flash con política de retención cero de datos. En esta comparativa pongo a prueba ambos modelos en tareas reales: el ligero GLM Flash asume el autocompletado instantáneo y la depuración por capturas de pantalla, mientras DeepSeek V4.1 con memoria condicional engram se encarga de la refactorización multiarchivo en terminal sin gastar tokens de pago.

👍 0
Julian Goldie SEOOpenRouter Provider Docs: Zhipu GLM 5.3 Flash Specs
25 de octubre
Collage en papel y técnica mixta con el grafo de notas enlazadas de Obsidian Vault y el núcleo cristalino de memoria de Hermes Agent.
ArtículoIAInteligencia artificialAutomatizaciónArquitectura

Memoria unificada para agentes de IA: la combinación de Hermes Agent y Obsidian Vault

La mayor trampa al poner en marcha un equipo de agentes autónomos es intentar conectar su memoria mediante bases de datos vectoriales de moda. La búsqueda vectorial se ahoga pronto en ruido semántico, pierde la cronología y convierte la base de conocimiento en una caja negra opaca. Los creadores del ecosistema Hermes Agent tomaron otro camino: usar como memoria compartida un almacén local de Obsidian Vault basado en la metodología PARA. Analizo la mecánica práctica de consolidación en dos etapas: cómo los logs diarios de los agentes se transforman por la noche en archivos estructurados de decisiones y por qué al humano le resulta tan cómodo supervisar el proceso desde el grafo de enlaces.

👍 0
Julian Goldie SEONous Research: Integrating Hermes Agent with Local Obsidian VaultsObsidian: Local Plaintext Markdown Knowledge Base Architecture
25 de octubre
Ilustración gráfica europea de estilo Ligne Claire con el robot asistente autónomo Step 5 clasificando archivos de tareas.
ArtículoIAInteligencia artificialAutomatizaciónHerramientas

Step 5 en Hermes Agent: un modelo ligero y gratuito para rutinas autónomas

Pasar el parseo en bruto de páginas web, la búsqueda de datos de contacto y el filtrado de noticias a modelos insignia caros como Claude Opus es la vía rápida para vaciar el saldo de la API en un par de horas. En la arquitectura Hermes Agent OS lo resolvieron con la clásica división del trabajo: para las tareas rutinarias pusieron el modelo abierto Step 5 del laboratorio StepFun. Su arquitectura profunda de 92 capas y ventana de contexto de 1 000 000 de tokens garantizan llamadas a herramientas sin fallos ni demoras. En este material te muestro cómo configurar el conector de Step 5 y reducir casi diez veces el gasto del pipeline agéntico.

👍 0
Julian Goldie SEOStepFun: Step 5 Preview Sparse MoE Architecture ReleaseNous Research: StepFun Provider Configuration for Hermes Agent
25 de octubre
Corte 3D fotorrealista de una línea de montaje robótica industrial con simulación física en el entorno NVIDIA Omniverse.
ArtículoIAInteligencia artificialInnovaciónIndustria

Alianza entre Mistral AI y NVIDIA: acelerando la simulación industrial en Omniverse

En el diseño de ingeniería moderno, la fase más lenta paradójicamente no es la búsqueda creativa, sino las simulaciones físicas: calcular la aerodinámica o la disipación térmica de la carrocería de un coche en clústeres de supercomputación lleva días o semanas. La alianza entre Mistral AI y NVIDIA pretende derribar esa barrera mediante IA física generativa dentro de Omniverse. Modelos neuronales sustitutivos se entrenan con conjuntos de cálculos hidrodinámicos y predicen el comportamiento de las piezas en milisegundos con más de un 98 % de precisión. Analizamos cómo la unión de Mistral Large y el framework Warp abre la era del autodiseño nocturno.

👍 0
Julian Goldie SEOMistral AI: Accelerating Industrial Physics Simulation with NVIDIA OmniverseForbes: How the Mistral and NVIDIA Alliance Reshapes Product Design
25 de octubre
Vista en primera persona POV a través de un visor óptico con etiquetado multimodal de objetos por el modelo Nemotron 3.5 Super VL.
ArtículoIAInteligencia artificialMultimodalidadHerramientas

NVIDIA Nemotron 3.5 Super VL: visión multimodal para agentes autónomos

¿Por qué las redes neuronales pesadas de propósito general tropiezan tan a menudo al leer tablas pequeñas en PDF y confunden las coordenadas de los botones en capturas de interfaz? El problema está en pegar a ciegas texto e imágenes con adaptadores simples de transición. NVIDIA lo resuelve con Nemotron 3.5 Super VL, un modelo MoE abierto de 120 mil millones de parámetros con 12 mil millones de pesos activos que combina transformer con capas Mamba-2 y el codificador óptico C-RADIO. Repasamos sus resultados en DocVQA con más del 91 % de precisión, el posicionamiento por coordenadas para agentes GUI y su ejecución en formato NVFP4 de 4 bits.

👍 0
Julian Goldie SEONVIDIA Blog: Announcing Nemotron 3.5 Super VL for Enterprise AgentsNVIDIA Developer: Nemotron 3.5 Super VL Architecture and Quantization
25 de octubre
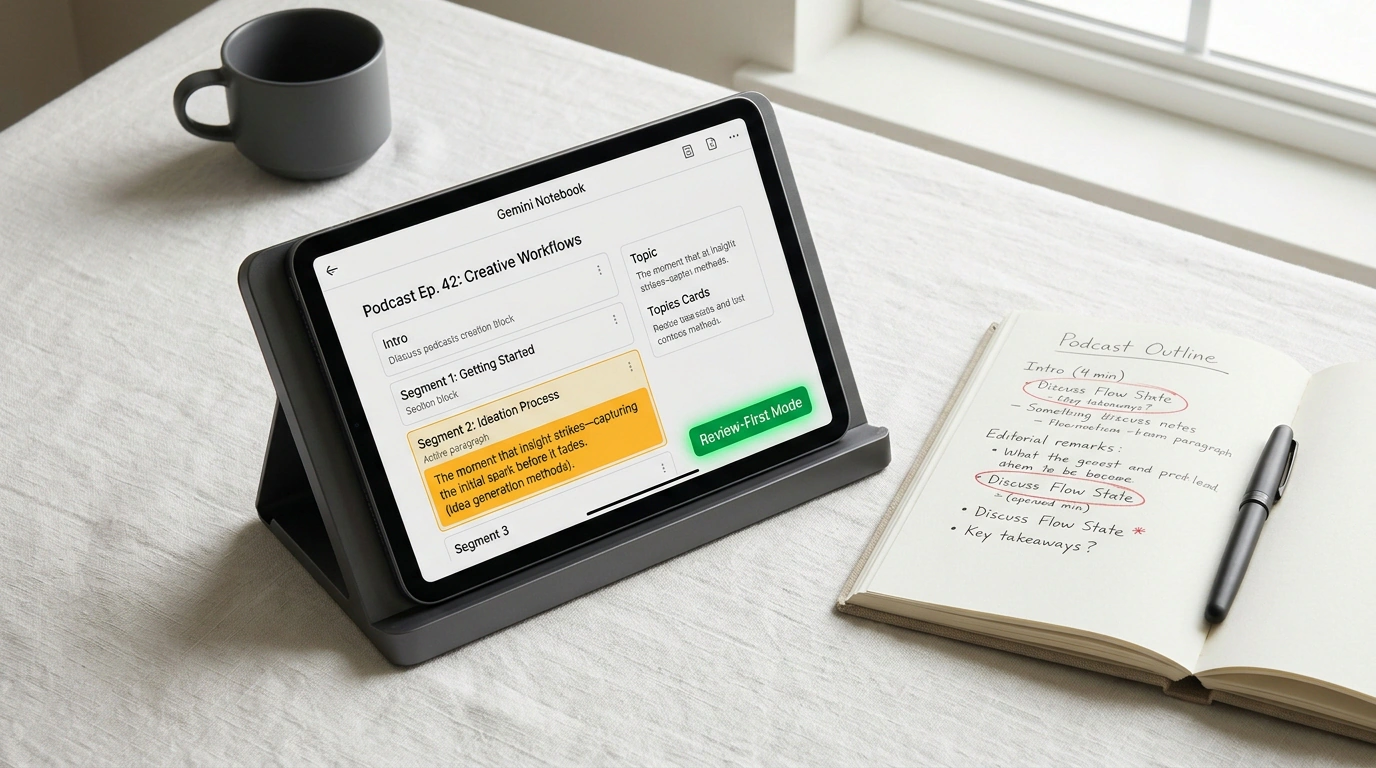
Bodegón de estudio con una tablet mostrando el modo Review-First en Gemini Notebook y el guion impreso de un pódcast.
ArtículoIAInteligencia artificialProductividadContenido

Control previo en Gemini Notebook: editar la estructura antes de generar

La moda de «generar presentaciones en un clic» se tradujo en la práctica en un dolor de cabeza interminable para los profesionales: los algoritmos pescaban datos secundarios, rompían el hilo argumental y obligaban a rehacer a mano cada diapositiva durante horas. La actualización de Gemini Notebook corrige este fallo sistémico con el modo Review First. Ahora el sistema genera primero un armazón transparente de puntos clave y notas del productor, permitiendo al usuario ajustar la lógica antes de lanzar el renderizado pesado. Analizo cómo este nuevo flujo devuelve el control al humano y ahorra tiempo de trabajo.

👍 0
Julian Goldie SEOGoogle Blog: Giving Users Structural Control in Gemini Notebook GenerationGemini Notebook: Collaborative Notebook Research Workspace
25 de octubre
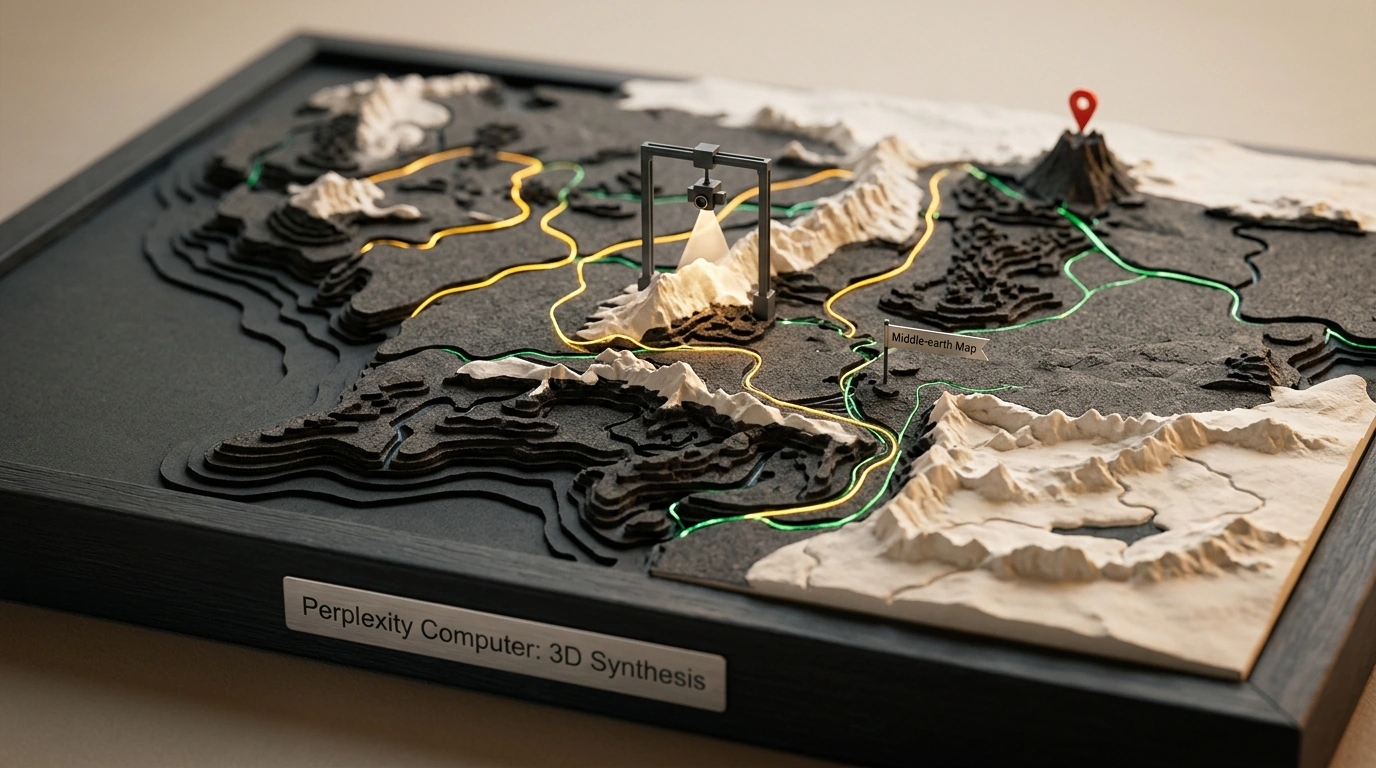
Maqueta física y diorama con relieve 3D del mapa de la Tierra Media y trayectorias de neón de síntesis de Perplexity Computer.
ArtículoIAInteligencia artificialAutomatizaciónCasos

Mapa 3D de la Tierra Media con Perplexity Computer: un caso de síntesis agéntica espacial

La mayoría de los usuarios ve Perplexity como un buscador avanzado que devuelve enlaces con citas, pero el nuevo experimento de Perplexity Computer demuestra el paso hacia verdaderos empleados digitales autónomos. Al recibir el encargo de crear un mapa interactivo tridimensional de la Tierra Media, el agente estructuró sin intervención humana las coordenadas de 179 asentamientos y 41 ríos, programó una aplicación cliente en Three.js y generó un mapa procedural de alturas directamente en el sandbox del navegador. En el artículo examino la arquitectura técnica del caso y explico por qué mantener el contexto durante cientos de pasos cambia las reglas del desarrollo web.

👍 0
Julian Goldie SEOPerplexity: Autonomous Project Building with Perplexity Computer
25 de octubre
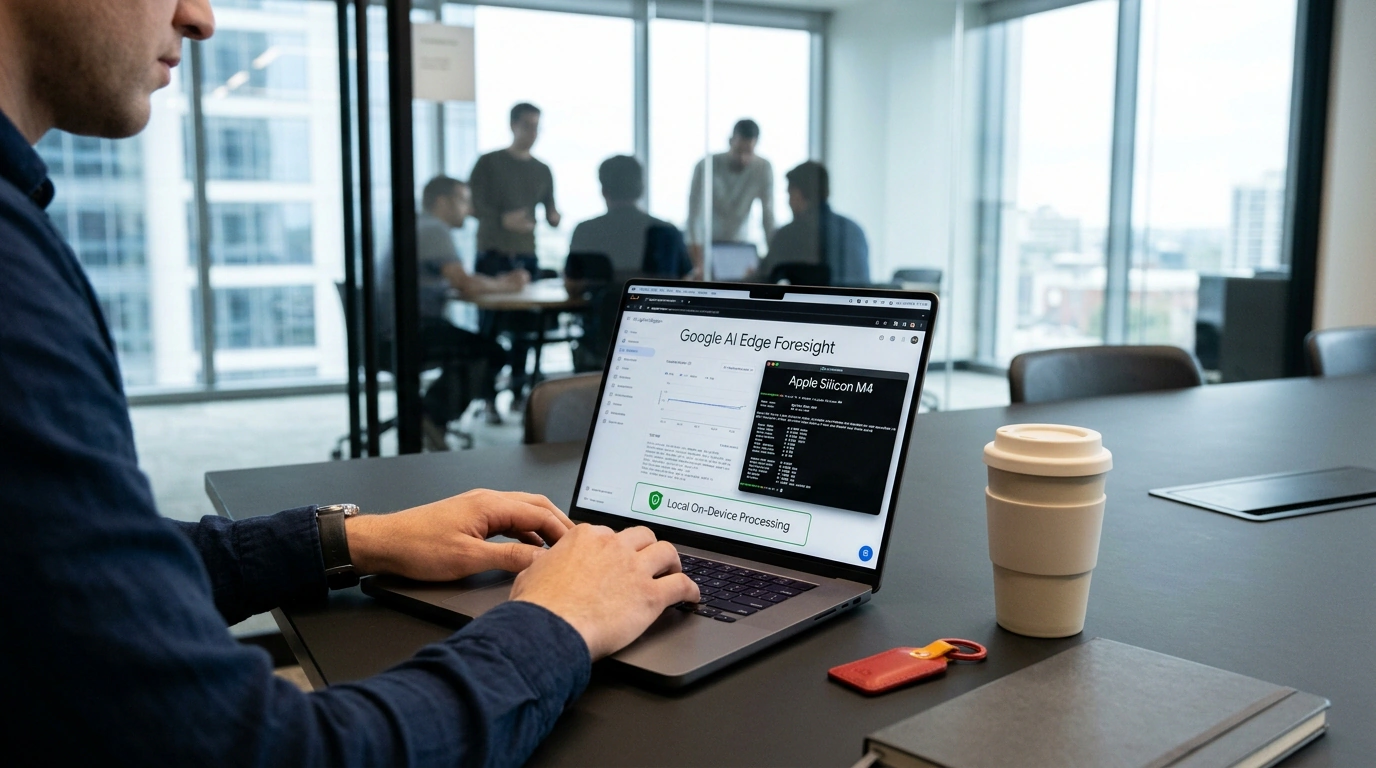
Escena documental en una sala de reuniones con un portátil MacBook Pro ejecutando el demonio local de Google AI Edge Foresight.
ArtículoIAInteligencia artificialSeguridadProductividad

Google AI Edge Foresight: asistente local para reuniones en Apple Silicon

¿Cómo levantar acta de reuniones confidenciales y buscar información en ellas si el departamento de seguridad de la empresa prohíbe tajantemente enviar flujos de audio a servicios de transcripción en la nube? Google propone la respuesta con la app autónoma AI Edge Foresight para ordenadores Mac. La dupla formada por el modelo compacto de embeddings EmbeddingGemma 2 y Gemma 2 local funciona al 100 % sin conexión aprovechando los núcleos de hardware Apple Neural Engine. Analizamos cómo el sistema expande notas cortas de texto en actas detalladas vinculadas al audio y por qué la búsqueda local no agota la batería del portátil.

👍 0
Julian Goldie SEOGoogle Technology Blog: Foresight - Privacy-First On-Device AI on macOSGoogle AI Edge Developer Platform Documentation
25 de octubre
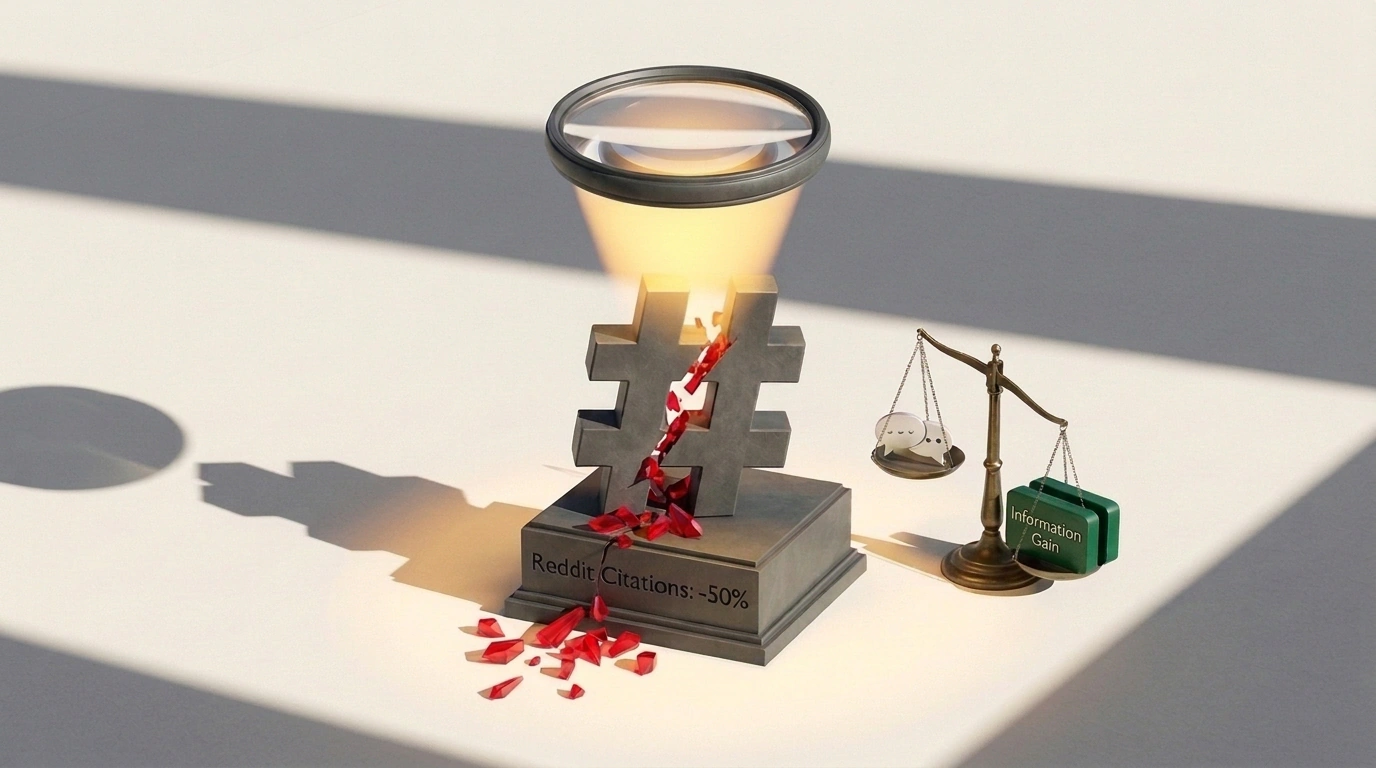
Bodegón conceptual surrealista con un símbolo gigante de grafito de Reddit partiéndose por la mitad bajo una lupa de búsqueda.
ArtículoIASEOAnalíticaTráfico

Caída del 50 % en las citas de Reddit en ChatGPT: estudio de Foundation Marketing

El intento de muchos especialistas en marketing de construir tráfico orgánico a largo plazo optimizando hilos de Reddit y comentarios encubiertos ha sufrido un golpe demoledor. Un nuevo estudio de la agencia Foundation Marketing revela que ChatGPT y SearchGPT redujeron las citas a Reddit exactamente en un 50 %, y en el segmento de software corporativo el desplome alcanzó el 70 %. Los algoritmos de OpenAI se han reajustado para medir el aporte de información única (Information Gain) y han vuelto a las fuentes primarias de autoridad. Analizo las causas de esta purga y recuerdo la regla de oro de la búsqueda generativa: la visibilidad en las respuestas de IA se alquila, no se posee.

👍 0
Ross SimmondsFoundation Marketing: Empirical Study on ChatGPT Reddit Citation Share CollapseRoss Simmonds: AI Search Visibility Is Rented, Not Owned
25 de octubre
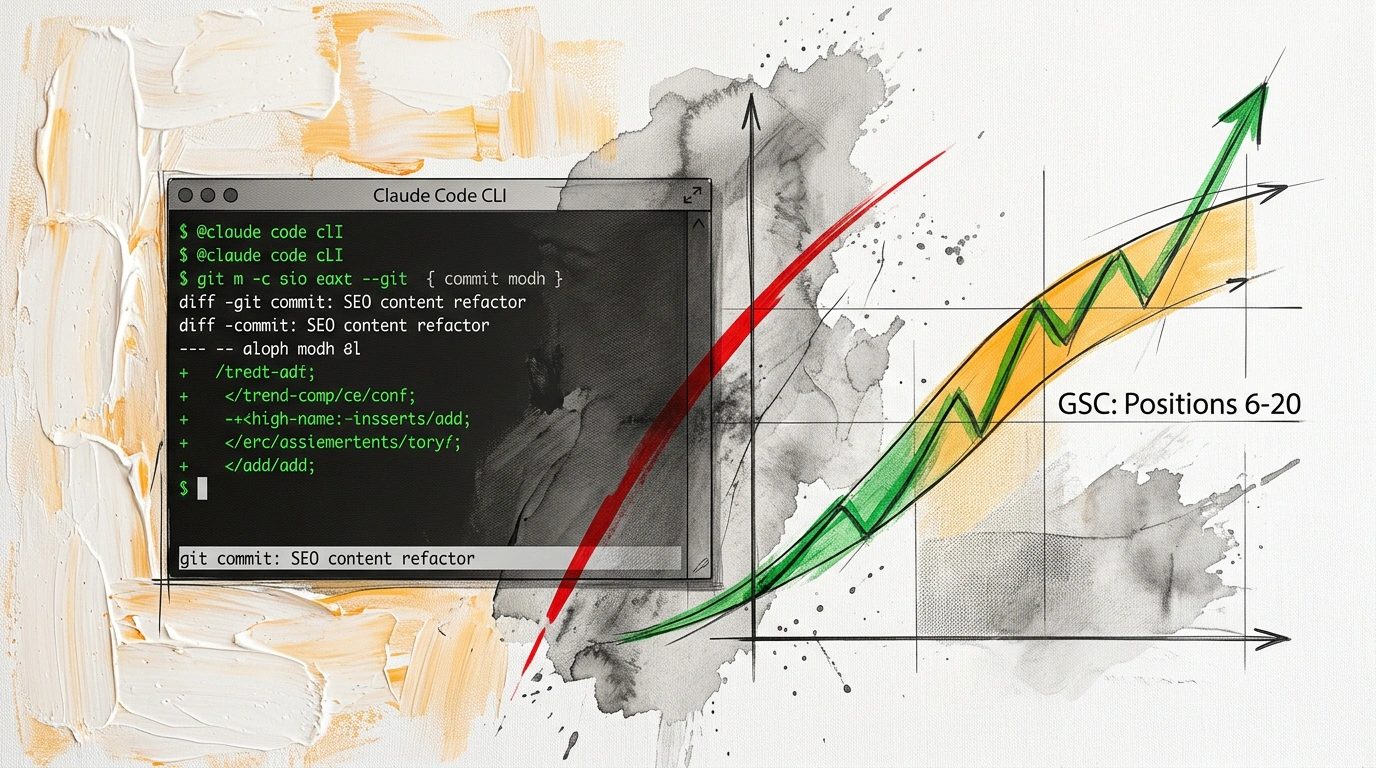
Boceto pictórico en acrílico y tinta con una ventana de terminal de Claude Code CLI, gráfico de tráfico de búsqueda y diagrama de Git diff.
ArtículoIASEOAutomatizaciónTráfico

Automatización del SEO con Claude Code CLI: un pipeline basado en datos de Search Console

El ciclo clásico de optimización en buscadores sufre una brecha entre la analítica y la aplicación de cambios en el código, alargándose semanas entre revisiones. La combinación del agente de consola Claude Code CLI y el protocolo MCP permite automatizar ese pipeline en un único flujo directamente dentro del repositorio web:

  • Extracción de consultas en zona de crecimiento rápido (posiciones 6–20 con altas impresiones) mediante la API de Google Search Console.
  • Refactorización precisa de encabezados H2 y snippets en archivos Markdown locales sin riesgo de canibalización de palabras clave.
  • Generación automática de un commit de Git con el diff de los cambios para la aprobación final del ingeniero. En el artículo comparto un script probado y prompts de sistema para evitar la sobreoptimización.
👍 0
Julian Goldie SEOGitHub: Model Context Protocol Server for Google Search ConsoleSearchConsole AI: MCP Connector Documentation for Terminal Agents
25 de octubre
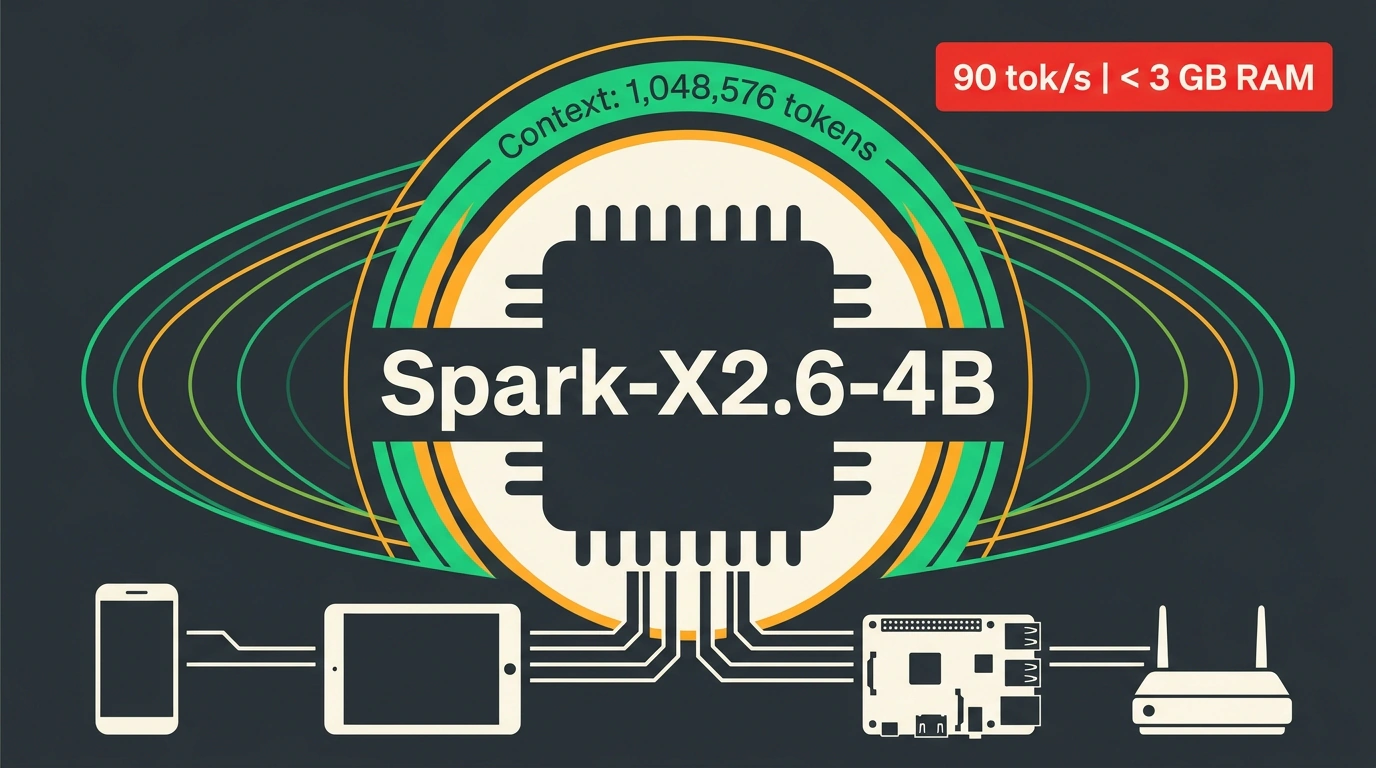
Gráfico vectorial editorial moderno con el chip compacto Spark-X2.6-4B y un anillo de un millón de tokens de ventana de contexto.
ArtículoIAInteligencia artificialAutomatizaciónEficiencia

Spark-X2.6-4B: el modelo compacto para escenarios empresariales rápidos en el borde

En la comunidad suele pensarse que los modelos por debajo de 7 mil millones de parámetros solo sirven como juguetes por sus constantes alucinaciones y bucles repetitivos. El lanzamiento de Spark-X2.6-4B del laboratorio XHToken rompe ese estereotipo: con apenas 4 mil millones de parámetros, la red sostiene una gigantesca ventana de contexto de 1 048 576 tokens gracias a su atención híbrida en proporción 3:1. Con cuantización de 4 bits ocupa menos de 3 GB de memoria y alcanza 90 tokens por segundo en smartphones y microordenadores. Analizo la arquitectura de la versión 2.6, su modo de razonamiento explícito y casos de clasificación corporativa económica en el borde.

👍 0
Julian Goldie SEOOllama Library: Spark-X2.6-4B Model Specs and DeploymentMindStudio: Architecture Breakdown of Spark-X2.6-4B
25 de octubre
Plano arquitectónico tipo blueprint de la evolución desde una plantilla aislada de prompt hasta un sistema cerrado de agentes.
ArtículoIAInteligencia artificialCarreraEstrategia

Del prompting a la arquitectura de sistemas: la transformación del rol de ingeniero hacia 2027

La fiebre por los conjuros de varias páginas del prompt engineering pasa a la historia junto con la era de los chatbots ciegos. A medida que los modelos aprendieron a razonar por su cuenta y verificar código con tests, los prompts rígidos empezaron a estorbar más que a ayudar. Como señala el creador de Claude Code, Boris Cherny, la industria avanza hacia compañeros permanentes en segundo plano dentro de Slack y bucles cerrados de verificación. Analizamos el estudio de Nick Saraev sobre la transformación de la profesión hacia 2027: por qué saber diseñar protocolos de llamada a herramientas y memoria compartida entre agentes pesa ya más que redactar instrucciones.

👍 0
Nick SaraevBusiness Insider: Anthropic's Boris Cherny on the Death of Prompt EngineeringSearch Engine Journal: The Shift from Prompts to Autonomous Loops
25 de octubre