Todo desarrollador que haya intentado levantar un modelo local para programar en su portátil de trabajo ha acabado chocando contra el mismo muro de compromisos. Los modelos ligeros de 7 a 14 mil millones de parámetros (como las versiones base de Qwen o DeepSeek) arrancan sin esfuerzo y escupen código como ametralladoras, pero en cuanto les pasas un bug complejo de concurrencia o una refactorización enrevesada en un repositorio ajeno, empiezan a inventarse métodos inexistentes con total seguridad. Las redes densas pesadas de 32 a 70 mil millones razonan a otro nivel, pero piden de 48 a 80 GB de VRAM y en hardware doméstico arrastran unos tristes 15–25 tokens por segundo que ponen a prueba tus nervios.
La startup Recursive Superintelligence, dirigida por el conocido investigador Richard Socher, ha cortado ese nudo gordiano lanzando el modelo Flint 40B bajo una licencia Apache 2.0 cristalina.
Arquitectura ultradispersa de 256 expertos: cómo obtener calidad de 40B con recursos de 2,5B
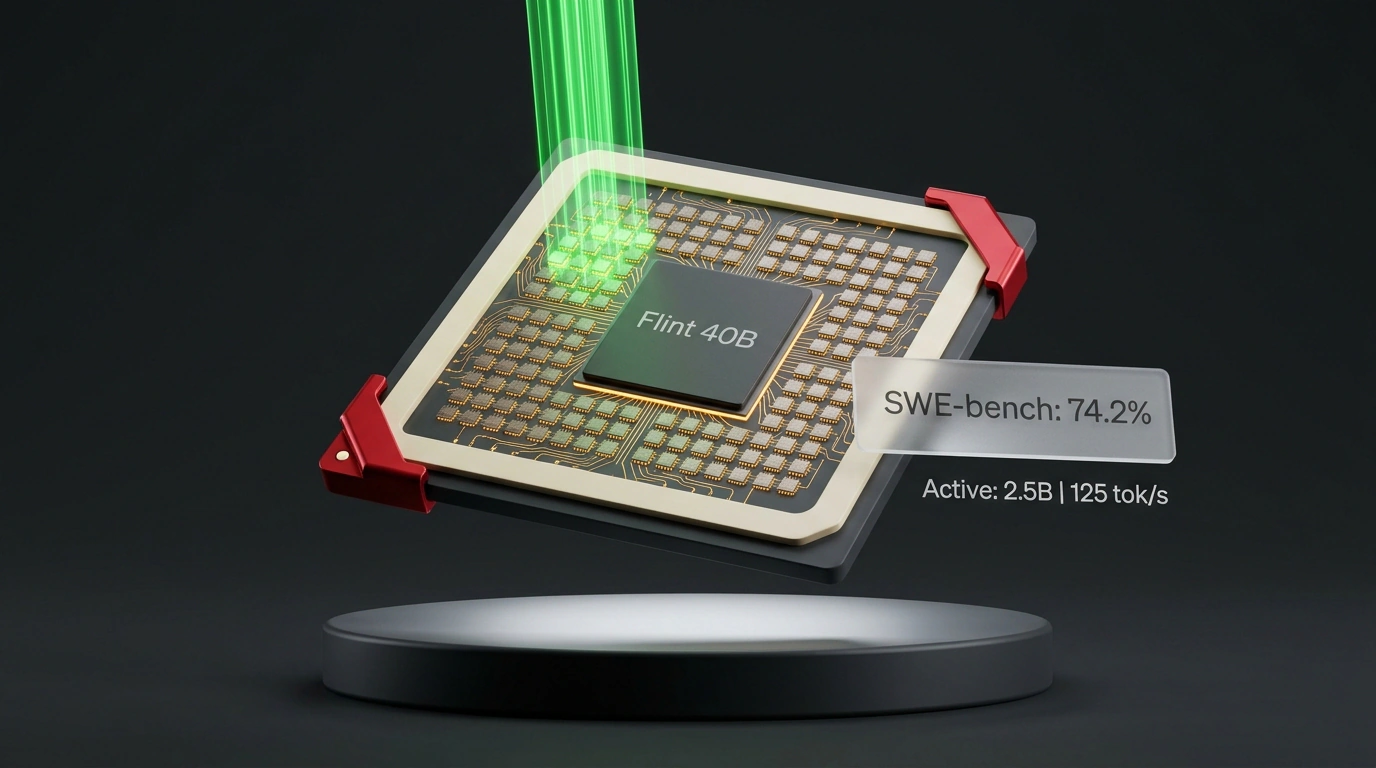
El secreto de la agilidad pasmosa de Flint 40B está en su arquitectura Mixture-of-Experts extremadamente dispersa. El tamaño total del modelo asciende a unos respetables 39,8 mil millones de parámetros, pero al generar cada token individual solo se activan 2,5 mil millones de pesos.
Veamos la geometría de la red:
- El modelo consta de 49 capas: las dos primeras son densas para capturar el contexto inicial y las 47 restantes usan ramificación dispersa MoE.
- En cada capa MoE se empaquetan 256 microexpertos especializados.
- Un enrutador dinámico de tokens escoge en cada paso exactamente 6 expertos especialistas, a los que se suma de forma permanente 1 experto compartido (shared expert) que mantiene la coherencia global de la sintaxis.
El resultado es que el procesador o la tarjeta gráfica de tu equipo hacen cálculos matemáticos como si movieran un modelo compacto de 2,5B, pero la profundidad lógica y la erudición proceden de un enorme almacén de conocimiento de 40 mil millones de parámetros.
Entrenamiento autónomo con Eureka Machine y resultados en SWE-bench Verified
Otro detalle fascinante del lanzamiento es cómo se entrenó el modelo. El pequeño equipo de Recursive entrenó Flint 40B en menos de cuatro meses gracias a su propia plataforma de investigación autónoma, Eureka Machine.
Eureka Machine es un metasistema de IA que generó por sí mismo miles de repositorios sintéticos de software, simuló millones de ciclos de aprendizaje por refuerzo (Reinforcement Learning), comprobó la compilación de tests y podó automáticamente las ramas de razonamiento sin salida. Los ingenieros humanos actuaron únicamente como diseñadores de los criterios generales y árbitros.
Los resultados en los benchmarks de ingeniería de software hablan por sí solos:
- En el prestigioso SWE-bench Verified (donde se entrega al modelo un reporte de bug real de un repositorio abierto y debe clonar el código, localizar el fallo, escribir un test y generar el parche correcto), Flint 40B alcanzó un 74,2 %, situándose como líder indiscutible entre todos los modelos abiertos por debajo de 50B parámetros.
- En la prueba de seguimiento de instrucciones complejas multinivel IFEval logró un 95,1 %.
- Su ventana de contexto alcanza los 262 144 tokens, suficiente para cargar entera la documentación arquitectónica de proyectos medianos.
125 tokens por segundo en Apple Silicon y ejecución en entorno totalmente aislado
En formato cuantizado GGUF Q4_K_M, el archivo del modelo pesa alrededor de 23 GB. Esto significa que en cualquier MacBook Pro con chip Apple M4 Pro o M3 Max y 48 GB de memoria unificada corre con total soltura, dejando espacio de sobra para el sistema operativo y el IDE.
Además, la velocidad de inferencia en portátil se mantiene estable en 125–130 tokens por segundo, y en servidores con gráficas de gama RTX 4090 supera los 150 tokens por segundo. ¡Eso es más rápido que la velocidad de lectura humana!
Para levantar un servidor local de Flint 40B con el popular motor llama.cpp basta un único comando en la terminal:
# Inicio del servidor local compatible con OpenAI para Flint 40B
./llama-server \
  --model ./models/flint-40b-instruct-q4_k_m.gguf \
  --ctx-size 131072 \
  --n-gpu-layers 49 \
  --threads 12 \
  --port 8080 \
  --host 127.0.0.1
Una vez levantado el servidor, puedes conectar Flint 40B a cualquier editor de código (VS Code, Cursor, Neovim) o invocar el endpoint local directamente desde scripts en Python:
import openai

# Conexión a la inferencia local de Flint 40B
client = openai.OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local-dev-no-key-required"
)

response = client.chat.completions.create(
    model="flint-40b",
    messages=[
        {
            "role": "system",
            "content": "You are a senior systems engineer. Inspect memory allocations and optimize socket buffers."
        },
        {
            "role": "user",
            "content": "Find potential memory leaks in our epoll network event loop in src/net/worker.c"
        }
    ],
    temperature=0.1,
    max_tokens=2048
)

print(response.choices[0].message.content)
La licencia Apache 2.0 te da vía libre para uso comercial: puedes desplegar el asistente dentro del perímetro cerrado de tu empresa, eliminando por completo cualquier fuga de código fuente fuera de la red local.