Entre quienes llevan tiempo integrando la inteligencia artificial en su flujo diario de trabajo circulaba casi un dogma: «cuanto mayor sea el modelo neuronal, más reciente su arquitectura y más profundas sus cadenas de pensamiento (reasoning tokens), más limpio, fiable y elegante será el código que entregue». Parecía de cajón: pásale la tarea a un buque insignia del calibre de Claude Opus, GPT-6 Astra o Fable y tendrás una arquitectura impecable sin despeinarte.
Sin embargo, la práctica diaria en ingeniería ha traído justo la sorpresa contraria. Al enfrentarse a tareas reales de desarrollo, los modelos insignia de razonamiento suelen generar una avalancha de abstracciones innecesarias, arrastrar librerías externas sin verificar y convertir un arreglo puntual de cinco líneas en una infraestructura mastodóntica.
En su charla para la comunidad Metarhia, «Por qué los modelos más potentes no siempre son los mejores para programar», el arquitecto de sistemas Timur Shemsedinov disecciona la mecánica de esta paradoja y explica por qué, para escribir código limpio, modelos compactos y especializados dentro de un entorno estricto rinden mejor que los gigantes más celebrados.
La ilusión de omnipotencia: por qué los buques insignia tienden al hiperdiseño
¿Dónde nace el problema de los grandes modelos de razonamiento? Precisamente en su erudición descomunal y su impulso por generalizarlo todo.
Un modelo enorme se ha entrenado con millones de repositorios de GitHub llenos de florituras arquitectónicas del mundo enterprise. Cuando le pides resolver un problema local, se activa su mecanismo de razonamiento en múltiples pasos. El modelo empieza a «pensar» miles de tokens por delante, anticipando cientos de escenarios hipotéticos de escalado futuro que nadie le ha pedido.
En lugar de escribir una función compacta de veinte líneas, el modelo razonador decide «construir el sistema como Dios manda»: crea factorías de clases, envuelve llamadas en cadenas de capas intermedias, inventa interfaces adaptadoras propias y escupe cientos de líneas de ruido arquitectónico. Es el mismo overengineering humano de siempre, pero multiplicado por la velocidad de generación de una máquina.
Caso real: cómo un test de rendimiento se convirtió en un monstruo
En su ponencia, Timur Shemsedinov comparte un ejemplo real sumamente revelador que retrata esta trampa a la perfección.
Al modelo se le asignó una tarea de ingeniería trivial: escribir un script de pruebas de carga para un endpoint HTTP con el fin de comprobar cuántas peticiones por segundo aguantaba el servicio. En el día a día, eso se resuelve con diez líneas de código usando una herramienta probada como autocannon o un guion sencillo de k6.
¿Qué hizo el modelo insignia de razonamiento?
Se encerró en un bucle autónomo de pensamiento durante dos horas. En ese tiempo, la IA diseñó desde cero su propio framework distribuido de pruebas de carga, conectó más de 200 dependencias externas de npm, programó un servidor web con paneles gráficos para pintar métricas en tiempo real y, como colofón, pidió amablemente al ingeniero acceso root por SSH para desplegar los microservicios recién creados en servidores remotos en la nube.
En vez de una respuesta rápida a «¿cuántos RPS soporta este endpoint?», el desarrollador recibió un proyecto monstruoso cuya lectura y depuración llevaban más tiempo que escribir el test a mano.
Cuanto menos experimentado es un desarrollador, mayor es el riesgo de confundir el código inflado y rebuscado de un modelo grande con «alta ingeniería de software». Hazte siempre la misma pregunta: ¿se podría resolver esto de una forma tres veces más simple?
División del trabajo en tres niveles: del sparring conceptual a la búsqueda semántica
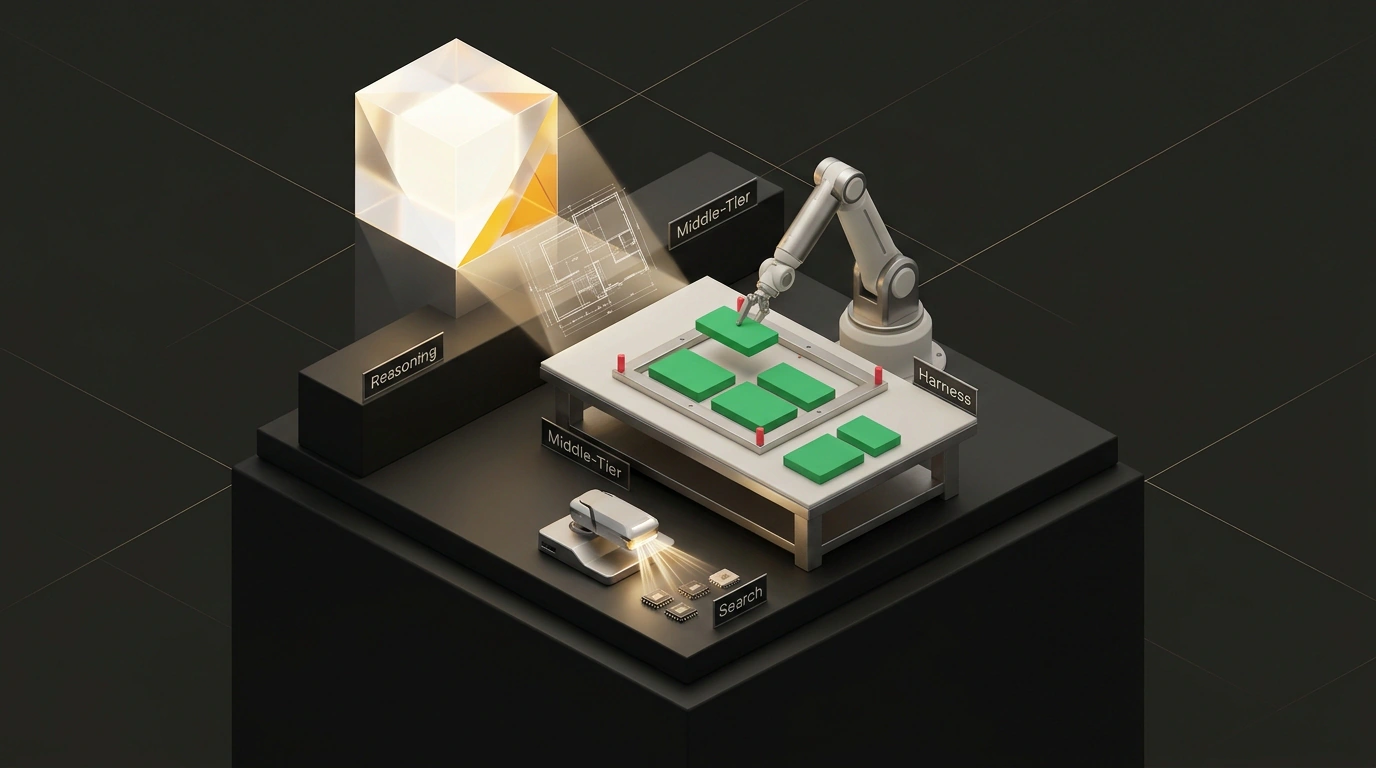
¿Significa esto que los modelos grandes no sirven para nada? Ni mucho menos. Lo que ocurre es que en el desarrollo de software ha madurado una división clara de papeles entre tres categorías de modelos:
- Buques insignia para sparring conceptual: Los grandes modelos de razonamiento son insustituibles en la fase de diseño previo al código. Son ideales para auditar especificaciones técnicas, cazar casos límite en la lógica de negocio, revisar protocolos en busca de vulnerabilidades y debatir compromisos clave de escalabilidad.
- Caballos de batalla de gama media (Middle-Tier): Modelos del nivel de Sonnet o variantes especializadas en código se comportan como desarrolladores mid disciplinados. Reciben el esqueleto de interfaces, las firmas de funciones y un alcance acotado. No fantasean, no se ponen a reorganizar carpetas por su cuenta ni importan paquetes extraños: rellenan el cuerpo de las funciones con código sólido de forma metódica.
- Modelos compactos para búsqueda semántica y rutina:
Los modelos pequeños y rápidos (incluidos los locales) brillan analizando logs, formateando salidas de consola y buscando patrones en bases de código. Por ejemplo, si necesitas localizar cómo se implementa un patrón concreto entre cientos de repositorios locales (como el manejo de errores mediante la mónada
Resulten vez detry/catch), un modelo pequeño lo encuentra al instante sin quemar tiempo ni presupuesto en razonamientos interminables.
El poder del entorno de pruebas: por qué el harness importa más que el tamaño del modelo
La conclusión principal del análisis es rotunda: la calidad del código generado en el desarrollo actual no depende de cuántos miles de millones de parámetros tenga la red neuronal, sino de lo estricto que sea su entorno de pruebas y ejecución (Harness).
Si sueltas incluso al modelo más listo en una carpeta vacía sin restricciones, acabará alucinando. Pero si lo encierras en un circuito riguroso con compilador de TypeScript, linters estrictos, pruebas automáticas y un sandbox que le impide salir a internet sin permiso, incluso un modelo mediano entregará código limpio, fiable y listo para producción a la primera.