En el día a día de un ingeniero de datos, analista o desarrollador backend toca cambiar constantemente de herramienta. Por la mañana escribes una consulta SQL analítica contra un data warehouse, al mediodía validas una hipótesis en Jupyter Notebook con Pandas en Python y por la tarde pasas el prototipo a un pipeline distribuido en Apache Spark.
Aunque los tres sistemas se apoyan en el álgebra relacional clásica, su sintaxis, su modelo de ejecución y su manejo de estructuras de datos cambian bastante. En esta recopilación temática reunimos dos guías prácticas de la comunidad SQL Portal: una tabla comparativa con 50 operaciones clave de transformación de datos y un desglose paso a paso del pipeline lógico con el que el motor de una base de datos ejecuta una consulta SQL.
Comparativa de 50 operaciones
Cuando migras código de un stack a otro, donde más tiempo se pierde no es pensando la lógica, sino buscando equivalentes sintácticos en la documentación. Lo que en el SQL declarativo se expresa con una sola palabra clave, en el código imperativo de Pandas exige encadenar métodos sobre un DataFrame, y en PySpark obliga a tener en cuenta la evaluación perezosa (Lazy Evaluation) y la serialización de expresiones.
La guía sistematiza 50 operaciones habituales de manipulación de datos agrupadas por bloques funcionales:
- Proyección y filtrado:
Una selección básica con condición
SELECT col1, col2 WHERE col1 > 10en Pandas se escribe mediante enmascarado vectorialdf[df['col1'] > 10][['col1', 'col2']], mientras que en PySpark requiere llamadas explícitasdf.filter(F.col('col1') > 10).select('col1', 'col2'). - Familia de operaciones JOIN:
Los cinco tipos de uniones relacionales (Inner, Left, Right, Full Outer y Cross Join). En Pandas se combinan dos DataFrames con
pd.merge(df1, df2, on='key', how='left'), y en PySpark mediante el método distribuidodf1.join(df2, on='key', how='left')odf1.crossJoin(df2). - Funciones de ventana y ranking:
Construcciones analíticas como
RANK() OVER (PARTITION BY dept ORDER BY salary DESC)en Pandas exigen agrupar y aplicar el método de rango:df.groupby('dept')['salary'].rank(ascending=False). En PySpark se define un objeto explícito de especificación de ventana:
from pyspark.sql import functions as F
from pyspark.sql.window import Window

# Definición de la ventana particionada por departamento y ordenada por salario
dept_window = Window.partitionBy('department').orderBy(F.col('salary').desc())

# Incorporación del ranking del empleado dentro de su departamento
df_ranked = df.withColumn('rank', F.rank().over(dept_window))
Esta matriz de equivalencias permite a cualquier ingeniero de datos traducir modelos SQL a pipelines distribuidos en Spark en cuestión de minutos sin alterar la lógica de negocio.
Anatomía de una consulta SQL
La segunda mitad del oficio consiste en entender cómo ve tu consulta SQL el motor físico del SGBD.
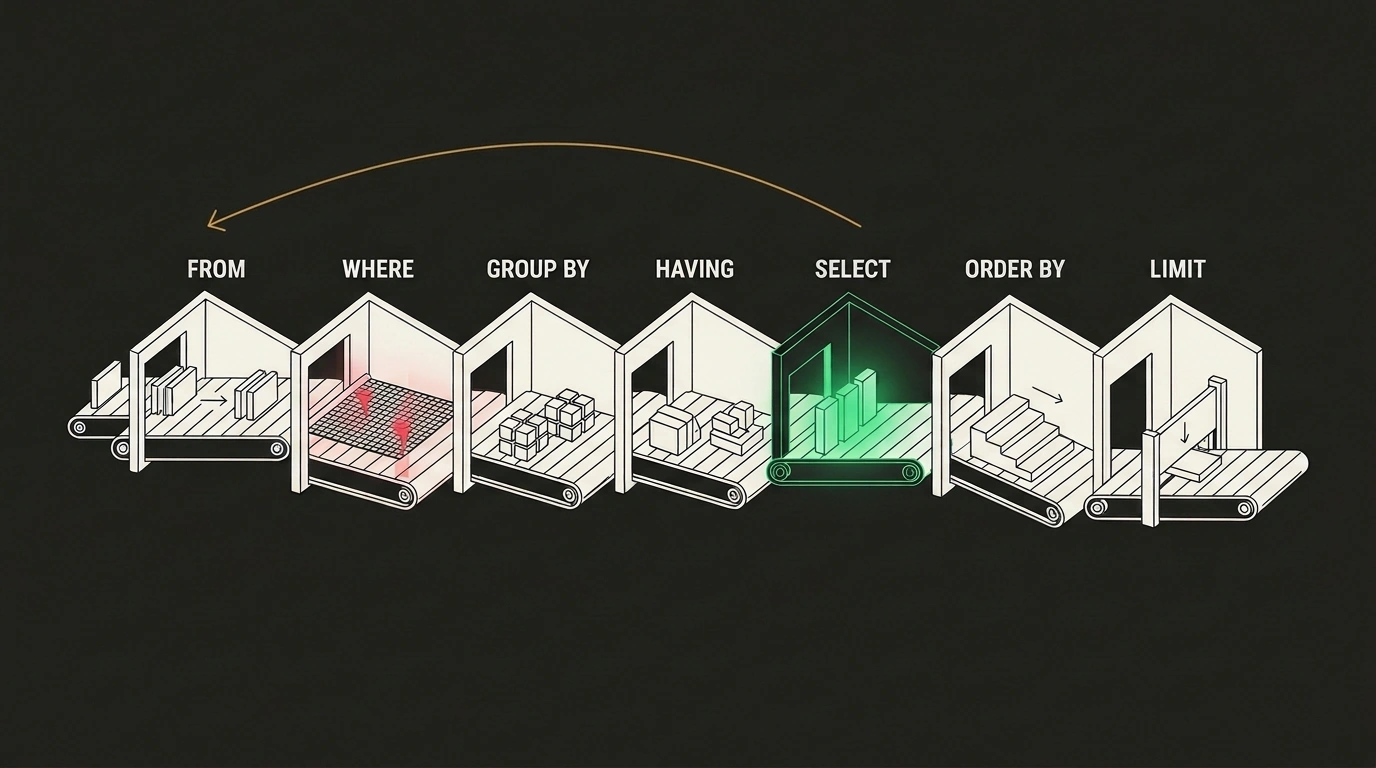
La gran paradoja de SQL es que el orden sintáctico en el que escribes la consulta es prácticamente opuesto al orden lógico en el que se ejecuta. Una consulta siempre empieza por SELECT. Pero si echas un vistazo a la documentación del ejecutor de PostgreSQL, descubres que el bloque SELECT se ejecuta penúltimo, justo antes de ordenar.
El pipeline lógico estándar de un SGBD consta de 7 etapas estrictas:
FROMyJOIN: el motor determina el conjunto base de tuplas y cruza las tablas según la condiciónON.WHERE: filtrado fila a fila. En este paso el SGBD todavía no sabe nada de agregados ni de los alias definidos enSELECT.GROUP BY: agrupación de las filas restantes por las claves indicadas.HAVING: filtrado sobre los grupos ya formados.SELECT: cálculo de proyecciones de columnas, expresiones matemáticas, funciones de ventana y eliminación de duplicados conDISTINCT.ORDER BY: ordenación del conjunto de resultados final.LIMIT/OFFSET: recorte del volumen de filas devueltas al cliente.
Este orden explica de golpe los errores más frecuentes:
-- Demostración del pipeline lógico:
-- ERROR: usar el alias total_cost dentro de WHERE provocará un fallo,
-- porque WHERE se ejecuta antes de que SELECT calcule ese valor.
-- SELECT item_id, price * quantity AS total_cost FROM orders WHERE total_cost > 1000;

-- CONSULTA CORRECTA respetando las etapas:
SELECT
    category_id,
    COUNT(*) AS total_orders,
    AVG(price * quantity) AS avg_order_cost
FROM orders
JOIN categories ON orders.category_id = categories.id
WHERE orders.status = 'completed'
GROUP BY category_id
HAVING COUNT(*) >= 10
ORDER BY avg_order_cost DESC
LIMIT 5;
En la cláusula ORDER BY ya sí puedes usar el alias avg_order_cost, porque la fase de ordenación se ejecuta después de la proyección SELECT.
Combinar la matriz de equivalencias sintácticas con el dominio del orden lógico de ejecución te da una visión completa del sistema. Cuando sabes con precisión en qué punto del pipeline se descartan las filas sobrantes (en WHERE antes de agrupar, y no en HAVING tras un GROUP BY costoso), tus consultas vuelan en milisegundos tanto en una base relacional como en un clúster distribuido de PySpark.