Durante mucho tiempo existió entre los ingenieros de IA un prejuicio bastante arrogante: todo lo que bajara de 7–8 mil millones de parámetros eran juguetes inútiles para demos en móviles. Se daba por hecho que con pesos ultracompactos era imposible lograr un seguimiento fiable de instrucciones: los modelos confundían los formatos de salida, entraban en bucles infinitos y empezaban a alucinar sin freno en cuanto la tarea se complicaba un poco.
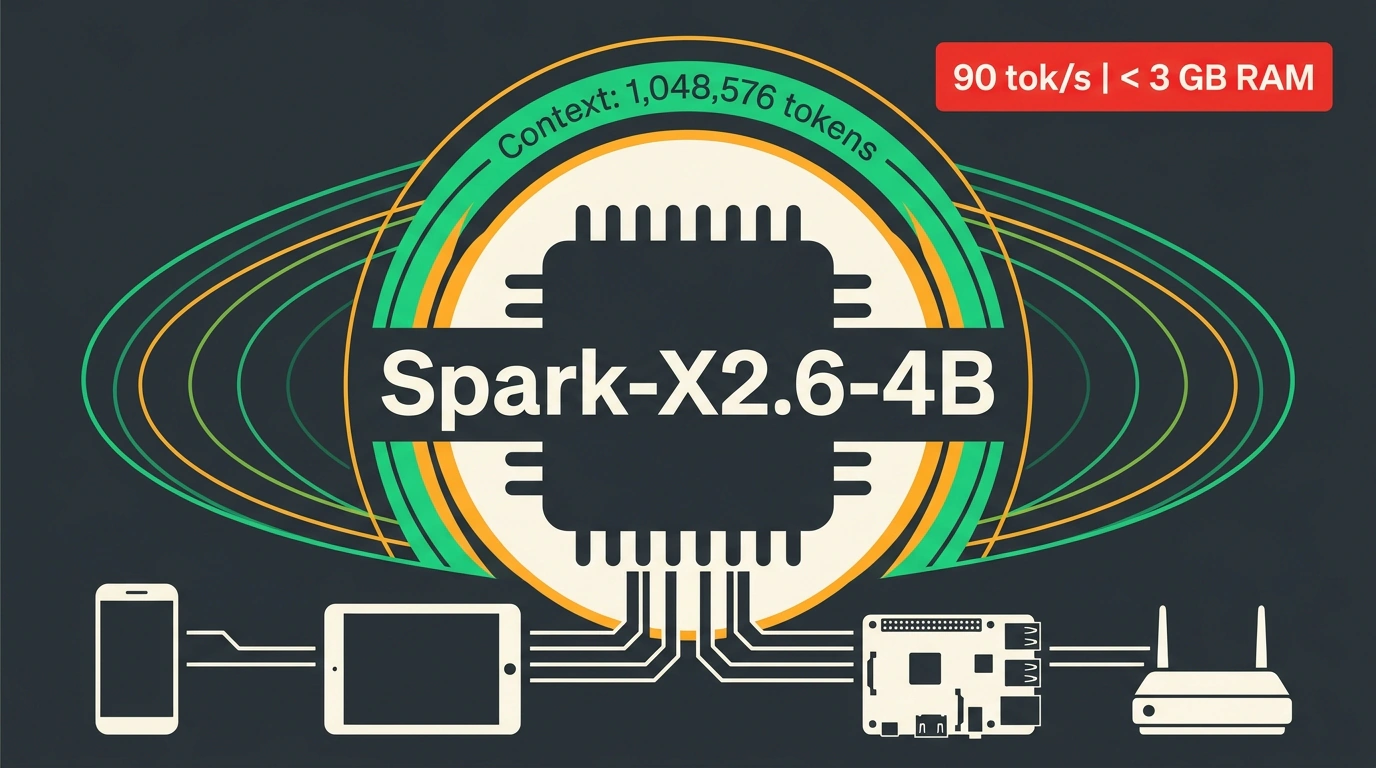
Sin embargo, el lanzamiento de Spark-X2.6-4B, desarrollado por el laboratorio XHToken (familia SparkLLM), obliga a revisar esos dogmas anticuados. Un modelo de 4 mil millones de parámetros demuestra capacidades que hace apenas un año exigían redes de servidor de 70B.
Atención híbrida 3:1: cómo meter un millón de tokens de contexto en 3 gigabytes de memoria
El gran obstáculo para el contexto largo en modelos pequeños es el crecimiento cuadrático de la caché de claves y valores (KV-Cache). Si le das a un modelo de 4B una ventana de contexto estándar de un millón de tokens, la memoria de la gráfica se satura al instante con matrices auxiliares de atención.
Los desarrolladores de Spark-X2.6-4B resolvieron este problema con un elegante esquema híbrido de atención:
- Tres capas consecutivas del transformer utilizan ventana deslizante local (Sliding-Window Attention, SWA), reteniendo solo los miles de tokens más cercanos.
- Cada cuarta capa cambia a atención global completa (Full Global Attention), enlazando entre sí los extremos distantes del documento.
Esta proporción 3:1 permitió desplegar una gigantesca ventana de contexto de 1 048 576 tokens (1M). Y en cuantización de 4 bits, todo el modelo junto con la caché ocupa menos de 3 GB de memoria RAM. Cabe en una Raspberry Pi 5, en una tablet o en la placa de un cajero automático.
Novedades de la versión 2.6: modo de razonamiento y fin de los bucles infinitos
En la versión 2.6 los ingenieros se centraron en el postentrenamiento (Post-Training Alignment):
- Modo de razonamiento explícito (Explicit Reasoning Mode): el modelo soporta la generación de etiquetas
<think>, permitiendo regular la profundidad de la cadena interna de pensamiento antes de emitir la respuesta estructurada. - Algoritmo DPO antibloqueos: en la versión 2.5, ante ramificaciones lógicas complejas, el modelo caía a veces en un bucle infinito repitiendo la misma frase. La 2.6 aplica un algoritmo específico de optimización de preferencias que corta de raíz las repeticiones.
- JSON sin fallos: la precisión al generar datos estrictamente estructurados aumentó un 18 %.
Aquí tienes un ejemplo de clasificación local de tickets de soporte técnico con extracción de entidades usando la librería transformers:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "XHToken/Spark-X2.6-4B"
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True
)

prompt = """<|system|>
You are a high-speed edge classifier. Classify customer tickets and output JSON.
<|user|>
Me cobraron 2490 rublos por el plan Business, pero el acceso al área personal está cerrado. Contrato #98124.
<|assistant|>
<think>
Categoría: Billing (cobro) + Account (acceso). El motivo principal de la consulta es facturación.
Entidades: contrato 98124, importe 2490, plan Business.
</think>
{"category": "Billing", "contract_id": "98124", "amount": 2490, "tier": "Business"}"""

inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=256, temperature=0.1)
print(tokenizer.decode(outputs[0][inputs.input_ids.shape[1]:], skip_special_tokens=True))
Y para ejecutarlo en la herramienta local Ollama basta un único comando estándar:
# Ejecución local de la versión cuantizada de Spark-X2.6-4B en Ollama
ollama run spark-x2.6-4b:latest "Clasifica el documento financiero entrante"
Escenarios en el borde: primera línea de soporte y onboarding
Gracias a una velocidad de generación superior a 90 tokens por segundo en procesadores convencionales, Spark-X2.6-4B se convierte en la herramienta ideal para automatizar la primera línea:
- Clasificación instantánea de cientos de miles de correos entrantes de clientes sin costes de API en la nube.
- Onboarding local en aplicaciones móviles sin enviar datos personales del usuario al servidor.
- La licencia Apache 2.0 da libertad total para integrarlo en productos comerciales.