Si has seguido el auge del video generativo de los últimos dos años —con todos esos Sora, Runway Gen-3, Kling y Luma Dream Machine—, seguro que has notado su techo fundamental. Por muy fotorrealistas que parezcan los fotogramas generados, siempre tenemos delante un «cine» pasivo. Introduces un prompt de texto, esperas un par de minutos y obtienes un bonito clip MP4 de cinco segundos. No puedes girar la cámara a la vuelta de la esquina, no puedes patear una piedra en el camino ni cambiar la dirección del viento. Es la ilusión de un mundo pintada sobre cristal.
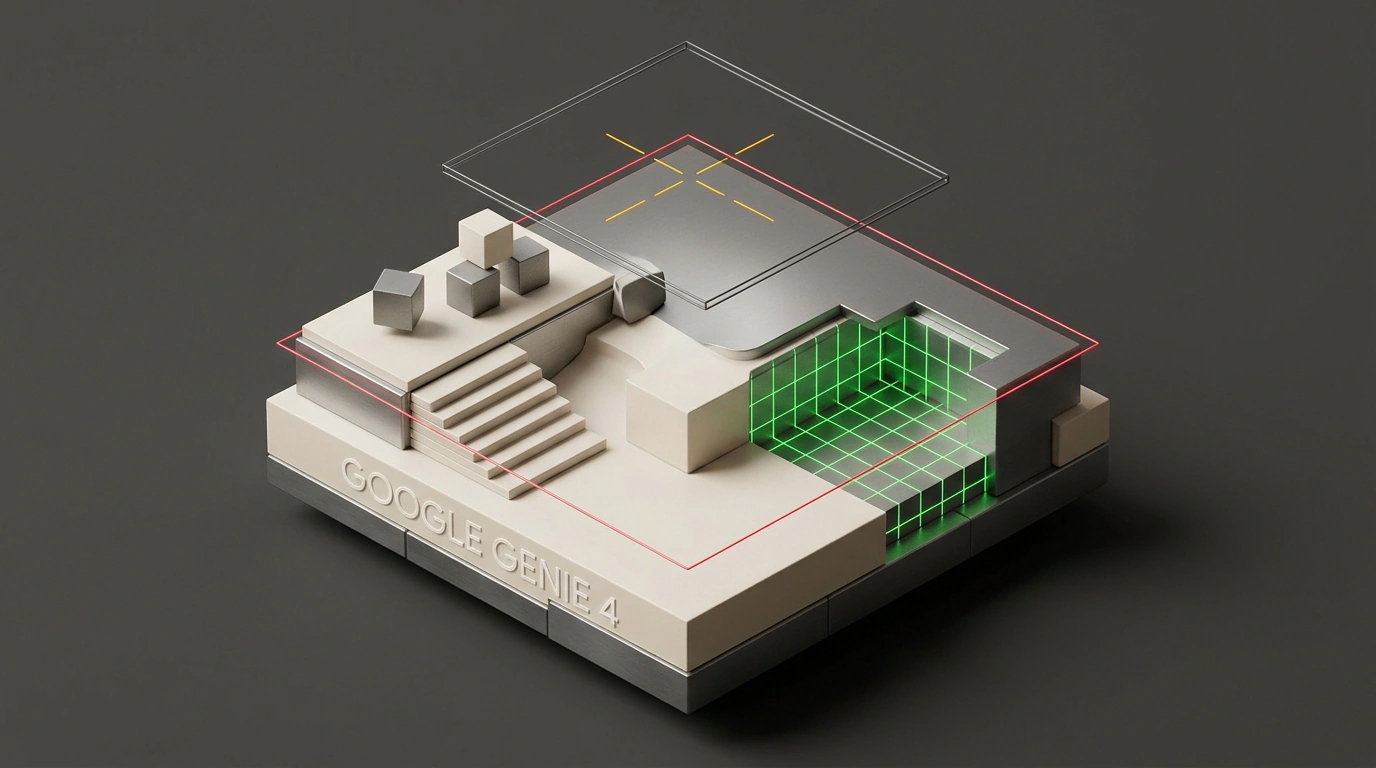
El laboratorio de investigación Google DeepMind ha decidido romper ese muro de cristal. Su nuevo lanzamiento —la arquitectura Google Genie 4— traslada la IA generativa de la categoría de «generadores de video» a una clase radicalmente distinta: modelos fundacionales de mundo interactivos (Foundation World Models). La red neuronal genera un espacio tridimensional completo e interactivo que puede controlarse en tiempo real con un mando o teclado, y el entorno obedece estrictamente las leyes de la mecánica. Veamos cómo funciona esta tecnología y por qué puede revolucionar el desarrollo de videojuegos y la robótica.
De los píxeles a la física: generación condicionada por acciones
La primera versión de Genie solo sabía crear plataformas bidimensionales primitivas en píxeles, parecidas a juegos de consola retro. En Genie 4, el equipo de DeepMind ha dado un salto colosal al pasar a espacios 3D reales con soporte de vista en primera y tercera persona.
La diferencia clave entre un modelo de mundo y un generador de video reside en la arquitectura de generación condicionada por acciones (Action-Conditioned Generation). Una red de video tradicional intenta adivinar el siguiente fotograma basándose únicamente en los fotogramas anteriores. Genie 4 funciona de otro modo:
- Vector de acciones entrantes. En cada paso temporal, el modelo recibe dos flujos de datos: el estado visual actual de la escena y un vector de señal de control (se pulsó la tecla «adelante», el stick del mando se inclinó a la derecha, se activó el botón de salto).
- Aprendizaje latente de acciones (Latent Action Learning). La red neuronal no fue programada con fórmulas de física clásica. Se entrenó con decenas de miles de horas de video de gameplay sin etiquetar y simulaciones 3D. Al analizar los cambios visuales al mover la cámara, el propio modelo dedujo conceptos empíricos: gravedad, elasticidad de cuerpos sólidos, conservación del impulso, deslizamiento y refracción de la luz.
- Inferencia en tiempo real. El modelo sintetiza el flujo a una velocidad de 24 a 30 fotogramas por segundo con un input lag mínimo. Pulsas una flecha del teclado y el personaje en pantalla no se limita a deslizarse sobre una textura, sino que tropieza de verdad con los baches, sube escalones y proyecta una sombra dinámica.
Sobre cómo evoluciona esta línea ya hablamos en el repaso de capacidades del modelo generativo Genie 4 de DeepMind.
Memoria espacial: cómo vencer la deriva al girar 180 grados
La gran maldición de las primeras simulaciones neuronales era la llamada deriva espacial (spatial drift). Bastaba con que el jugador en una habitación generada girara la cámara 180 grados y luego volviera a mirar atrás para que el mundo cambiara por completo: la puerta desaparecía, la pared cambiaba de color y los objetos sobre la mesa se desvanecían en el aire. La red neuronal simplemente carecía de memoria tridimensional a largo plazo.
En Genie 4 resolvieron ese problema incorporando un búfer híbrido espacio-temporal (Spatio-Temporal Memory Buffer). La arquitectura mantiene una representación geométrica latente de la escena. Si entraste en un hangar abandonado, rompiste una caja de madera y fuiste a explorar el pasillo contiguo, al regresar la caja seguirá rota exactamente en el punto donde la dejaste.
Es más, durante la propia sesión interactiva se puede modificar el mundo en tiempo real mediante comandos de texto:
- «Añade lluvia intensa y niebla». El modelo recalcula al vuelo los reflejos en el asfalto mojado y reduce la distancia de dibujado.
- «Reduce la gravedad a nivel lunar». Los objetos empiezan a flotar lentamente al empujarlos.
- «Cambia la hora del día al atardecer». La fuente de luz desciende hacia el horizonte, modificando la temperatura de color de toda la geometría.
A diferencia del renderizado web clásico como la generación de mundos 3D en Three.js puro, aquí no hay mallas poligonales ni shaders predefinidos: cada píxel nace en las profundidades de la red neuronal.
Para qué sirve: un campo de pruebas infinito para robots y el fin de los motores clásicos
Mucha gente percibe estos avances únicamente como un juguete para videojuegos. Sin duda, la perspectiva de tener un RPG infinito donde cada ciudad y misión se generan al vuelo según el estilo del jugador resulta apasionante. Pero el principal interés comercial de DeepMind está en otro plano muy distinto: en la robótica.
Entrenar robots bípedos o manipuladores autónomos en el mundo físico real es carísimo y lentísimo. El robot se cae, rompe servomotores, destroza cámaras y exige reparaciones. Hasta ahora, los desarrolladores usaban simuladores manuales (NVIDIA Isaac Sim, MuJoCo), que requieren meses de trabajo minucioso de modeladores 3D y físicos, algo que ya mencionamos en el contexto de la automatización de pipelines en Blender y Unreal Engine.
Genie 4 permite generar en cuestión de segundos millones de escenarios de simulación variados: baldosas resbaladizas tras fregar el suelo, un almacén abarrotado de cajas, una escalera con un peldaño roto. Los agentes robóticos pueden entrenar en esos mundos a velocidad mil veces superior, acumulando miles de millones de tropiezos en el espacio virtual antes de que su cuerpo físico dé el primer paso real.
Dónde están los límites: acumulación de errores y apetito por el hardware
Pese al triunfo tecnológico, todavía queda lejos el reemplazo total de Unreal Engine por redes neuronales:
- Acumulación de errores en recorridos largos. El búfer de memoria mantiene la geometría de forma estable durante 10–15 minutos de juego activo. Pasado ese tiempo, en los rincones lejanos de los escenarios empieza a asomar la entropía visual: las texturas «flotan» ligeramente y los detalles pequeños pierden nitidez.
- Requisitos colosales de cómputo. Renderizar física tridimensional en tiempo real exige una potencia de cálculo gigantesca. El modelo funciona sobre clústeres de Google TPU v5p y no será posible ejecutarlo en una tarjeta gráfica doméstica GeForce en un futuro cercano.
- Ausencia de rigor ingenieril. El modelo de mundo opera con verosimilitud visual, no con ecuaciones matemáticas estrictas de Navier-Stokes. No sirve para cálculos aerodinámicos de cohetes ni pruebas de choque de automóviles: crea una imagen creíble, no un modelo de cálculo.
Genie 4 demuestra un cambio tectónico: la inteligencia artificial ha aprendido no solo a describir el mundo de forma pasiva con texto o dibujar imágenes estáticas, sino a modelar una realidad física interactiva. Y este campo de pruebas virtual cambiará las reglas del juego más rápido de lo que parece.