Desde la publicación del histórico artículo «Attention Is All You Need» en 2017, la industria de la inteligencia artificial vivió bajo un férreo monopolio tecnológico. El mecanismo de atención (Self-Attention) dentro de la arquitectura Transformer se convirtió en el cimiento de todas las redes frontera sin excepción, desde GPT-4o hasta Claude y Gemini. El escalado funcionaba sin fallos: añade más capas, compra clústeres de aceleradores H100 y obtén un salto de inteligencia.
Pero esa fórmula triunfal tiene una barrera física insalvable: el crecimiento cuadrático de la complejidad computacional de la atención y un apetito insaciable por la memoria de las tarjetas gráficas. Cada token generado exige guardar los vectores clave y valor en el llamado caché KV (Key-Value Cache). Con contextos largos, esa caché crece hasta decenas de gigabytes, convirtiendo la ejecución de modelos en dispositivos periféricos —gafas inteligentes, drones autónomos o microordenadores portátiles— en una tarea de ingeniería imposible.
La startup Liquid AI, fundada por investigadores del laboratorio CSAIL del Instituto Tecnológico de Massachusetts (MIT) liderados por Ramin Hasani, Mathias Lechner y Daniela Rus, desafió el dogma establecido. Presentaron la familia de modelos fundacionales de tercera generación LFM3 (Liquid Foundation Models). La novedad demuestra que una red compacta no-transformer de la clase de 2 mil millones de parámetros es capaz de competir de tú a tú con transformers seis veces más grandes. Analicemos las matemáticas de esta arquitectura y sus implicaciones prácticas para la IA en el borde (Edge AI).
Redes neuronales líquidas y arquitectura tri-híbrida: matemáticas más allá del transformer
En la base del desarrollo de Liquid AI está el concepto de redes neuronales «líquidas» (Liquid Neural Networks, LNN). A diferencia de las redes artificiales clásicas con pesos sinápticos fijados durante el entrenamiento, las redes líquidas se modelan mediante el aparato de sistemas dinámicos continuos y ecuaciones diferenciales no lineales. Sus estados ocultos y constantes de tiempo pueden adaptarse dinámicamente al flujo cambiante de señales de entrada directamente durante la inferencia.
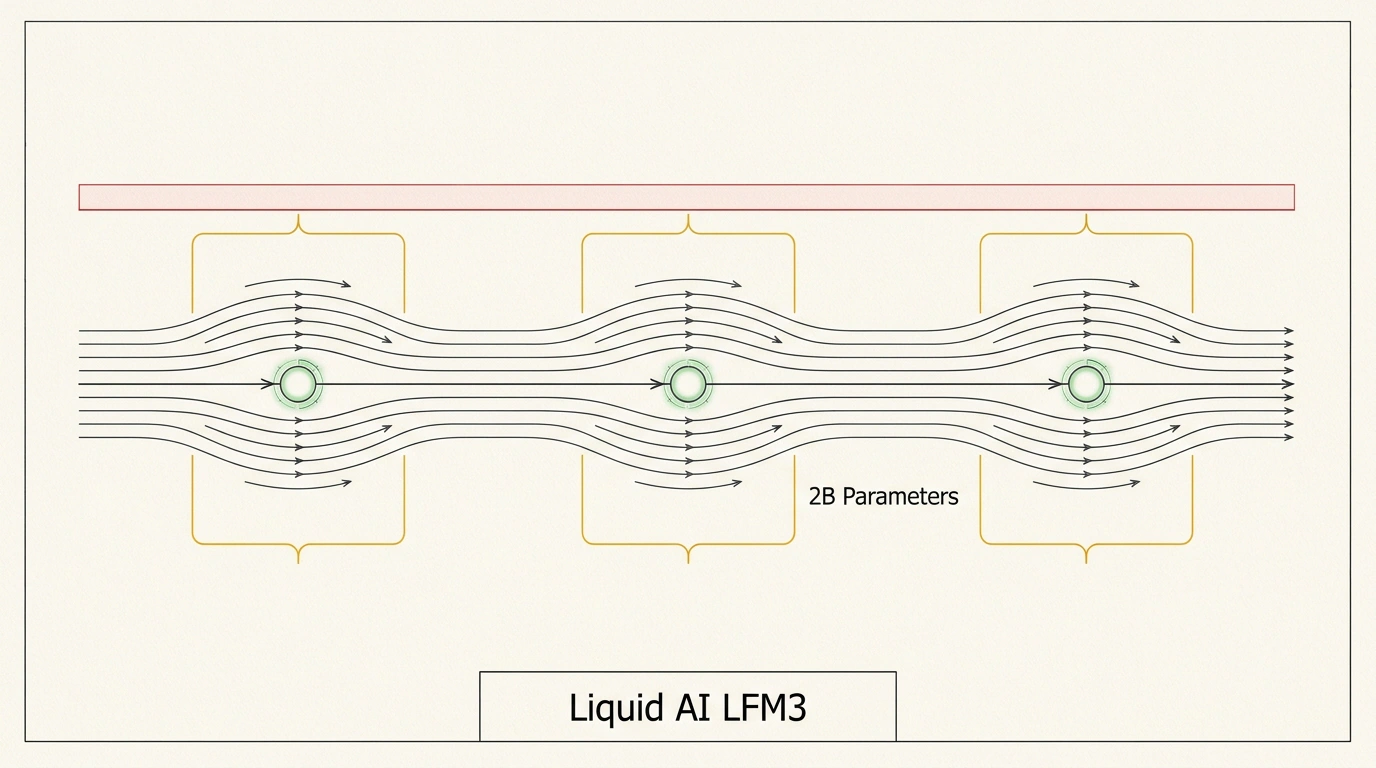
El gran avance de la familia LFM3 fue sustituir las capas homogéneas de atención por una arquitectura tri-híbrida (Tri-Hybrid Architecture). En lugar de obligar a cada token a mirar todos los símbolos anteriores, el bloque de cómputo se divide en tres componentes complementarios:
- Convoluciones cortas con compuerta (gated short convolutions). Se encargan de capturar patrones morfológicos y sintácticos locales entre tokens vecinos. Las convoluciones se ejecutan en tiempo constante y no requieren guardar caché intermedia.
- Atención de ventana deslizante (sliding-window attention). La atención se conserva, pero actúa solo sobre un horizonte local corto de unos pocos cientos de tokens, encargándose de la concordancia precisa de conceptos cercanos.
- Compresión lineal global de memoria. En lugar de inflar una caché KV gigantesca, la memoria a largo plazo se organiza como un espacio compacto matemático de estados (State Space), donde se integra de forma continua la esencia de lo leído mediante ecuaciones diferenciales.
Este enfoque híbrido permitió reducir el tamaño de la caché KV en más de un 70% frente a un transformer estándar. Sobre cómo esta mecánica comprime los requisitos de hardware hablamos en detalle en el artículo sobre la familia multimodal Liquid AI LFM 3.
La familia LFM3: el modelo visual 2B frente a gigantes de 12B y un agente ultraligero
La familia LFM3 se construye sobre un núcleo unificado LFM3-1.7B-Base e incluye seis modelos especializados:
El buque insignia del área multimodal es el modelo LFM3-VL-2B (peso real de 1.9 mil millones de parámetros). Para comprobar su viabilidad, los desarrolladores realizaron una evaluación masiva en 62 benchmarks independientes de visión por computador. Los resultados fueron sensacionales: la red compacta mostró una calidad media de reconocimiento y orientación espacial idéntica a la de transformers clásicos de la clase de 12 mil millones de parámetros. El modelo lee sin error instrumentos de aguja, analiza la dinámica del tráfico en flujos de video y resuelve con soltura la navegación de manipuladores robóticos.
El modelo de texto LFM3-1.7B dio un salto equivalente en escenarios agénticos:
- Soporta una ventana de contexto de hasta 256,000 tokens;
- En cuantización de 4 bits (GGUF, Apple MLX, ONNX Runtime), el peso total del modelo en memoria RAM es de apenas 1 gigabyte;
- La arquitectura está optimizada específicamente para llamadas frecuentes a herramientas externas (Tool-Calling), parseo de estructuras JSON estrictas y navegación web.
Además, la familia incluye el modelo de audio LFM3-Audio-2B, el modelo multimodal integral LFM3-Omni-2B y clasificadores deterministas especializados d1-2B. Los principios de funcionamiento de estos árbitros compactos de decisión los analizamos en el artículo sobre los modelos dinámicos de toma de decisiones Liquid AI d1.
Revolución del Edge AI: por qué la eficiencia energética importa más que la fuerza bruta
La aparición de LFM3 cambia el equilibrio de fuerzas en la industria de sistemas embebidos e internet de las cosas:
- Autonomía total en el borde (Edge AI). Un robot aspirador, un dron de videovigilancia o unas gafas inteligentes dejan de depender de la estabilidad de la conexión celular y la latencia de servidores en la nube. Inteligencia al nivel de los asistentes actuales funciona en local sobre chips móviles económicos.
- Eficiencia energética. En dispositivos portátiles cuenta cada vatio-hora de batería. Las capas lineales de la arquitectura líquida exigen muchas menos operaciones de cómputo por token generado, evitando el calentamiento de los equipos y alargando su autonomía.
- Capacidad de la infraestructura de servidor. En clústeres en la nube, eliminar la pesada caché KV permite alojar en una sola GPU de clase NVIDIA A100 o H100 entre 5 y 10 veces más sesiones de usuario en paralelo, reduciendo en un orden de magnitud el coste de la inferencia.
Límites de capacidad y compromisos prácticos
Pese al triunfo tecnológico, no existen milagros, y las redes neuronales líquidas exigen una valoración sobria de sus limitaciones:
- Capacidad de conocimiento factual. Un modelo de 1.7–2 mil millones de parámetros es matemáticamente incapaz de alojar en sus pesos todo el volumen enciclopédico de Wikipedia o millones de monografías científicas. Para consultas factuales necesita búsqueda externa o base de conocimiento.
- Deducción lógica compleja. En la resolución de problemas atípicos de olimpiadas matemáticas o la redacción de ensayos arquitectónicos de varias páginas, LFM3 queda por detrás de las grandes redes de razonamiento frontera como GPT-5 o Claude Opus.
- Soporte en el ecosistema de software. Integrar kernels personalizados para las capas diferenciales de las redes líquidas requiere instalar bibliotecas optimizadas, aunque el soporte base en ONNX y MLX mitiga el problema.
La familia Liquid AI LFM3 ha demostrado con contundencia que la era de inflar parámetros a ciegas llega a su fin, cediendo el paso a arquitecturas dinámicas elegantes donde no importa la masa de la red neuronal, sino su organización interna.