¿Te has parado a pensar lo derrochador y absurdo que resulta el uso actual de los grandes modelos de lenguaje? Imagina la escena: una línea de producción automatizada o un pipeline de agentes necesita responder a una pregunta elemental —«¿Es seguro pasar este pull request a producción?» o «¿Tiene un defecto la pieza de esta foto?»—. En vez de devolver un número o un simple «sí/no», un transformer pesado se pone a imprimir párrafos interminables carácter a carácter: «¡Hola! Tras analizar detenidamente el fragmento de código proporcionado, llego a la conclusión de que…».
En esa verborrea innecesaria se pierden cientos de milisegundos valiosos y megavatios de energía. Estamos clavando clavos con un microscopio simplemente porque nos acostumbramos a los chatbots autorregresivos.
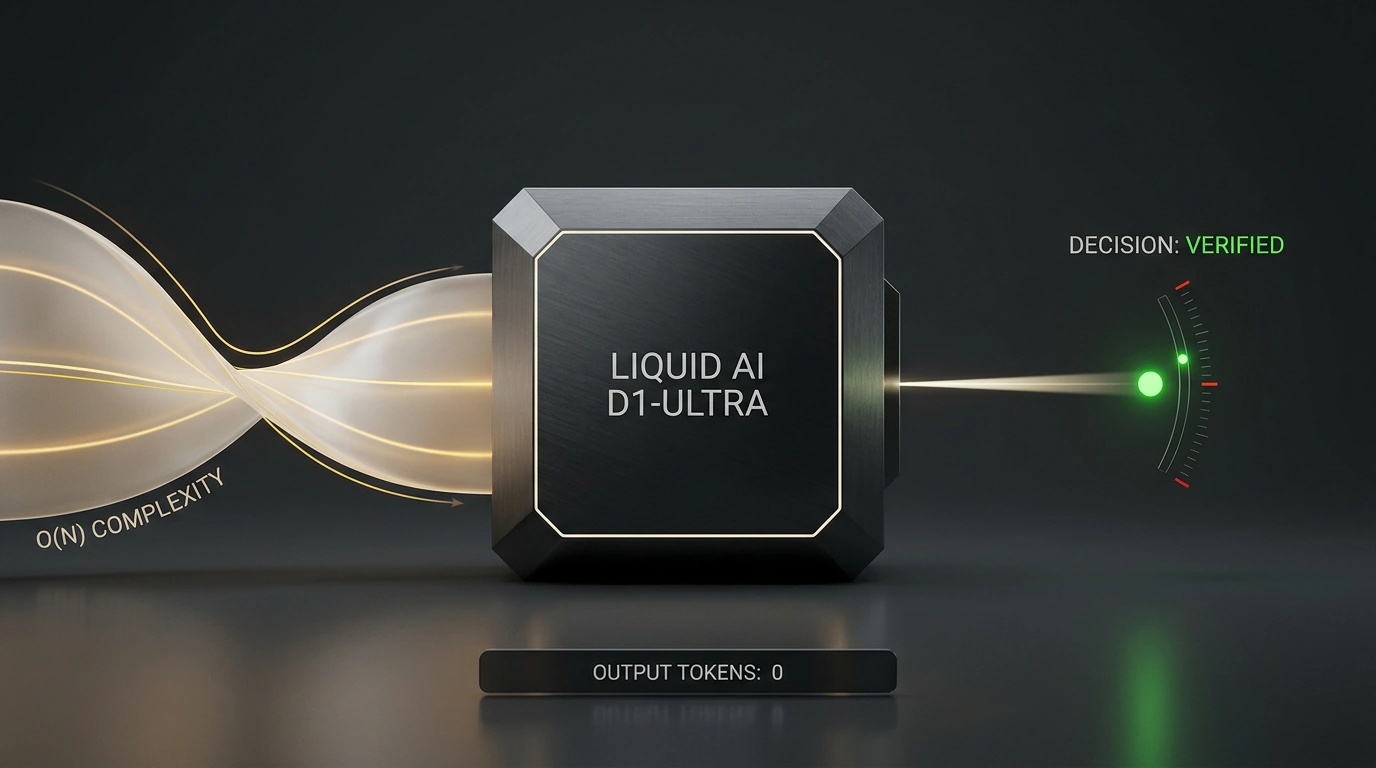
Pero la startup Liquid AI, nacida del laboratorio CSAIL del MIT bajo el liderazgo de Ramin Hasani, ha planteado una salida radical. Su nuevo modelo multimodal d1-ultra pertenece a una familia distinta: no es un modelo generativo, sino un modelo de decisión (Decision Model). Su contador de output_tokens es literalmente cero.
He revisado la arquitectura del modelo y sus resultados en benchmarks para mostrarte por qué las redes neuronales dinámicas apuntan a convertirse en el árbitro estándar de los sistemas autónomos.
La maldición cuadrática de la atención: por qué los transformers chocan contra un muro
Todos los LLM actuales —de GPT-4 a Claude y Gemini— se apoyan en la arquitectura Transformer y el mecanismo de autoatención (Self-Attention). Ese mecanismo es brillante capturando contexto, pero arrastra una tara matemática severa: su complejidad computacional cuadrática $O(N^2)$.
Si duplicas la longitud del contexto de entrada, el cómputo y la memoria de caché de atención se multiplican por cuatro. Si la multiplicas por diez, se disparan por cien. Frente a flujos continuos de datos (vídeo de cámaras de seguridad, telemetría de conducción autónoma o millones de líneas de logs), los transformers se ahogan de inmediato.
Liquid AI tomó otro camino: sustituyó las matrices discretas de atención por «redes neuronales líquidas» (Liquid Neural Networks, LNN) y modelos continuos de espacio de estados (Continuous-Time State Space Models). Su base matemática usa ecuaciones diferenciales con coeficientes dinámicos: el comportamiento de las neuronas se adapta sobre la marcha a los datos entrantes, como un líquido que rodea un obstáculo.
La consecuencia computacional directa es que la complejidad pasa de cuadrática a lineal o subcuadrática $O(N)$. El modelo puede leer un flujo infinito de información a velocidad constante y con consumo fijo de memoria.
Anatomía de un Decision Model: cuando sobran las palabras
El modelo d1-ultra está diseñado de raíz para no generar texto. Recibe texto, imagen o ambos, los pasa por la red dinámica y en una única pasada hacia adelante devuelve una decisión escalar o una distribución de probabilidades.
Composición infográfica escultórica con los tres tipos de veredictos del Decision Model d1-ultra sin consumo de tokens de salida.
La arquitectura soporta tres tipos básicos de consulta:
- Decisión binaria (Binary Decision): respuesta clara Sí/No con estimación de riesgo (por ejemplo, si hay fuga de secretos en un commit).
- Selección discreta (Categorical Choice): elige la categoría óptima de una lista cerrada sin tener que parsear texto libre con expresiones regulares.
- Escala calibrada (Calibrated Scalar): puntuación numérica de confianza entre 0.0 y 1.0 (por ejemplo, ajuste de un currículum a una vacante).
Mira cómo se llama al Decision Engine desde Python en un caso real:
"""
Integración con Liquid AI Decision Engine.
El modelo evalúa si un pull request es apto para fusión automática
y devuelve una probabilidad calibrada sin generar tokens de texto.
"""
import requests
import json

API_URL = "https://api.liquid.ai/v1/decide"
API_KEY = "lqd_live_sample_token"

payload = {
    "model": "d1-ultra",
    "inputs": {
        "text": "PR #402: Refactored database connection pooling. Added retry logic for transient timeouts. All 142 unit tests passed. No schema migrations.",
        "question": "¿Es seguro realizar un despliegue automático a producción sin aprobación manual del líder técnico?",
        "decision_type": "binary",
        "confidence_threshold": 0.90
    }
}

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}

response = requests.post(API_URL, json=payload, headers=headers)
result = response.json()

# El modelo devuelve el resultado con cero consumo de tokens de salida
print(f"Veredicto: {result['decision']}")
print(f"Confianza: {result['confidence']:.4f}")
print(f"Tokens consumidos: Entrada={result['usage']['input_tokens']}, Salida={result['usage']['output_tokens']}")
Fíjate en la última línea: output_tokens: 0. No pagas por generar palabras ni esperas a que el modelo termine sus frases de cortesía. La respuesta llega en cuestión de milisegundos.
Y aquí tienes un ejemplo multimodal para detectar defectos en una cadena industrial:
"""
Evaluación de defectos en una pieza por foto y regla de tolerancia en d1-ultra.
"""
import base64
import requests

def check_component_defect(image_bytes: bytes, tolerance_rule: str) -> dict:
    b64_img = base64.b64encode(image_bytes).decode('utf-8')
    data = {
        "model": "d1-ultra",
        "inputs": {
            "image": f"data:image/jpeg;base64,{b64_img}",
            "text": tolerance_rule,
            "question": "¿Existen microfisuras en la superficie del cristal?",
            "decision_type": "binary"
        }
    }
    res = requests.post(
        "https://api.liquid.ai/v1/decide",
        json=data,
        headers={"Authorization": "Bearer lqd_live_sample_token"}
    )
    return res.json()
Un LLM clásico está entrenado para predecir el siguiente token más probable de una frase, lo que fomenta la verborrea y una falsa seguridad (overconfidence). En cambio, d1-ultra se entrena minimizando el error de predicción del resultado objetivo, garantizando una calibración matemática honesta de las probabilidades.
Récord en Artificial Analysis Decision Index y el fin del exceso de confianza
El gran azote de las redes neuronales tradicionales al evaluar riesgos es su soberbia patológica. Un chatbot puede afirmar una barbaridad con un 99% de seguridad aparente, engañando a pipelines automáticos enteros.
En el benchmark Artificial Analysis Decision Index, d1-ultra rondó los 65 puntos, superando por más de 8 puntos a su rival especializado más cercano (la familia Jev de TypeSafe).
Pero lo más valioso es otro dato: d1-ultra mostró una calibración de probabilidades prácticamente perfecta. Si el modelo indica un 85% de probabilidad de fallo, en una muestra real de cien casos equivalentes el fallo ocurre efectivamente unas 85 veces. Para scoring financiero, triaje médico y control de calidad, esa fiabilidad es oro puro.
La economía de inferencia también da un vuelco: el coste de la API ronda los $0.042 por millón de tokens de entrada, con coste cero de salida. La familia de Liquid AI incluye el buque insignia D1 Ultra, la equilibrada D1 Base, una ultracompacta 3B para dispositivos periféricos y la variante multimodal Omni.
Como ya comentamos en el artículo sobre modelos de decisión para agentes de IA, separar los roles entre «generador» y «juez-árbitro» se está convirtiendo en el estándar de oro de la automatización fiable.
Límites de aplicación: para qué no sirve Liquid AI
Pese a lo elegante que resulta la arquitectura LNN, conviene tener muy claras sus fronteras:
- Incapacidad total para generar contenido. d1-ultra no te redactará un artículo, no inventará un guion creativo ni mantendrá una charla contigo. Es un bloque puramente analítico.
- Particularidades del entorno de servidor. Las librerías actuales de optimización de inferencia (vLLM, TensorRT-LLM) están pensadas para la atención de transformers. Correr redes líquidas en servidores propios exige kernels específicos de Liquid AI.
El lugar natural de d1-ultra en una arquitectura moderna es el de árbitro instantáneo (Judge) y enrutador en fábricas agénticas. Mientras los grandes modelos generativos escriben código, d1-ultra verifica en milisegundos y por fracciones de céntimo la seguridad, filtra alucinaciones y toma decisiones objetivas.
