Históricamente, Go ha defendido una filosofía de sencillez deliberada: escribes código claro en Go puro y el compilador se encarga de traducirlo a instrucciones máquina eficientes. Sin embargo, cuando toca procesar grandes volúmenes de datos, parsear JSON, hacer criptografía, construir índices de búsqueda o trabajar con multimedia, los bucles escalares acaban chocando contra el techo físico de rendimiento de un único núcleo.
Durante años, la única forma de exprimir al máximo una CPU moderna en Go consistía en escribir archivos en ensamblador Plan 9 (.s). Pero el ensamblador en Go se paga caro: el compilador deja de hacer inlining de esas funciones, el análisis estático de los linters se rompe y mantener soporte para varias arquitecturas (x86_64, ARM64, WebAssembly) se convierte en un dolor de cabeza continuo con generadores externos de código.
En la próxima versión Go 1.27, el equipo del lenguaje dirigido por Junyang Shao y David Chase ha dado un salto enorme. La API experimental de instrucciones vectoriales incorpora por fin soporte completo para las arquitecturas ARM64 y WebAssembly.
Hace poco ya repasamos cómo evolucionaba el SIMD portable en Go 1.27 para algoritmos generales. Ahora los desarrolladores reciben además acceso directo al paquete de bajo nivel simd/archsimd, que permite invocar intrínsecos de hardware de cada procesador directamente desde código Go estándar.
Modelo en dos niveles: portabilidad frente a velocidad límite
Para dar respuesta tanto a quien busca máxima portabilidad como a quien pelea por cada ciclo de reloj, los arquitectos de Go diseñaron un sistema en dos capas:
- Paquete de alto nivel
simd: ofrece operaciones matemáticas y lógicas portables (en la línea de la librería C++ Google Highway). Escribes un único algoritmo vectorial y compila en cualquier procesador con registros vectoriales. - Paquete de bajo nivel
simd/archsimd: abre la puerta directa a las capacidades de hardware de un chip concreto. Si tu servidor cuenta con AVX-512, NEON o Wasm SIMD, puedes llamar a sus instrucciones específicas mediante métodos tipados.
Este paquete experimental se activa con una bandera de compilación dedicada:
GOEXPERIMENT=simd go build
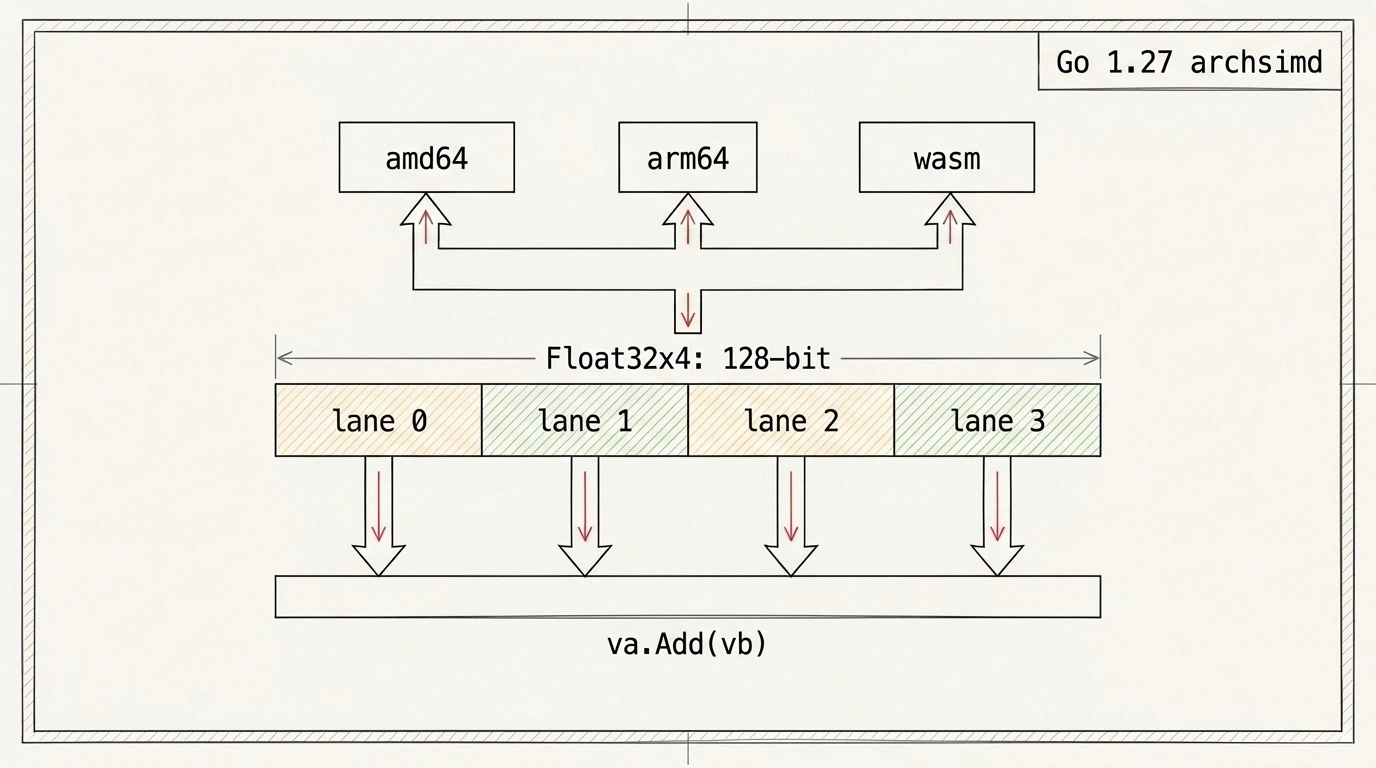
En Go 1.27, el soporte de archsimd cubre ya tres plataformas clave:
amd64— extensiones vectoriales SSE, AVX2 y AVX-512;arm64— instrucciones vectoriales ARM NEON de 128 bits (con la base arquitectónica preparada para las extensiones escalables SVE y SVE2);wasm— el perfil vectorial estandarizado WebAssembly SIMD de 128 bits.
Tipado estricto y nombres claros para las instrucciones
En lenguajes como C o C++, trabajar con intrínsecos suele asustar de entrada por nombres interminables sacados de archivos de cabecera, tipo _mm512_mask_add_ps o _mm256_shuffle_epi8. En Go han diseñado la API con la sobriedad y claridad propias del lenguaje.
Los vectores se representan como estructuras estrictamente tipadas de tamaño fijo:
Float32x4— cuatro números de coma flotante de 32 bits (128 bits);Int32x8— ocho enteros de 32 bits (256 bits);Uint8x16— dieciséis bytes (128 bits).
Todas las operaciones son métodos sobre esas estructuras. Por ejemplo, sumar dos vectores se escribe siempre va.Add(vb) sin importar la plataforma destino. En lugar de códigos crípticos de ensamblador, se usan verbos legibles: el desplazamiento se llama ShiftAllLeft, la operación AND bit a bit es And y el mínimo es Min.
El compilador de Go aplica además optimizaciones peephole profundas. Si encadenas va.Add(vb).Masked(m), el optimizador fusiona la suma y la máscara de bits en una sola instrucción de hardware con predicado (por ejemplo, VPADD en AVX-512).
También ofrece conversiones de tipo sin coste (zero-cost bitcast). Métodos como ToBits(), ReshapeToUint32s() o BitsToFloat32() cambian la interpretación lógica de los datos dentro del registro vectorial al instante, sin generar ni una sola instrucción de copia en memoria.
Diferencias sutiles de semántica: PermuteOrZero frente a LookupOrZero
La parte más fascinante al explorar simd/archsimd es ver cómo el equipo de Go ha lidiado con las discrepancias entre procesadores al manejar condiciones límite (boundary semantics).
Diagrama comparativo de la semántica por plataforma de las instrucciones vectoriales PermuteOrZero y LookupOrZero cuando los índices salen fuera de la tabla.
Un ejemplo clásico: permutar dieciséis bytes según una tabla de índices. En procesadores Intel x86_64, la instrucción VPSHUFB se comporta de forma asimétrica cuando un índice se sale de rango: si el bit más significativo del índice es uno (número negativo), el byte resultante se pone a cero; pero si el índice es positivo y mayor que 15, la CPU simplemente toma el resto módulo 16. En Go para amd64, esa operación ha recibido el nombre exacto de PermuteOrZero.
En procesadores ARM64, el conjunto NEON resuelve lo mismo con VTBL, pero con una regla más estricta: si el índice queda fuera del rango de 0 a 15 (tanto por arriba como por abajo), el byte resultante siempre se anula. Exactamente igual funciona la instrucción i8x16.swizzle en WebAssembly.
Para evitar que un desarrollador introduzca un bug silencioso al llevar un algoritmo de un servidor x86_64 a un Mac con Apple Silicon o a WebAssembly en el navegador, en Go para ARM64 y Wasm la operación tiene otro nombre: LookupOrZero. Al tener nombres distintos, el programador se ve obligado a tener presente el detalle de cada arquitectura.
Y para las instrucciones de AMD64 que operan de forma aislada dentro de carriles independientes de 128 bits dentro de registros anchos de 256 o 512 bits, se añade el sufijo Grouped (por ejemplo, PermuteOrZeroGrouped).
//go:build goexperiment.simd

package main

import (
    "fmt"
    "simd/archsimd"
)

// VectorAdd realiza la suma paralela componente a componente de dos slices float32
func VectorAdd(a, b, result []float32) {
    n := len(a)
    i := 0

    // Bucle principal: procesamos 4 elementos en cada iteración vectorial
    for ; i+4 <= n; i += 4 {
        va := archsimd.LoadFloat32x4(a[i:])
        vb := archsimd.LoadFloat32x4(b[i:])
        vr := va.Add(vb)
        vr.Store(result[i:])
    }

    // Procesamiento de la cola del slice si la longitud no es múltiplo de 4
    if i < n {
        va, _ := archsimd.LoadFloat32x4Part(a[i:])
        vb, _ := archsimd.LoadFloat32x4Part(b[i:])
        vr := va.Add(vb)
        vr.StorePart(result[i:])
    }
}
Fíjate en lo limpio que queda el manejo del resto final del array. LoadFloat32x4Part lee de forma segura los elementos sobrantes (entre 1 y 3 números) rellenando con ceros el resto del vector, y StorePart escribe de vuelta únicamente los bytes que realmente corresponden, sin pisar memoria ajena fuera del slice.
# Compilación para arquitectura ARM64 (servidores Graviton o Apple Silicon)
GOEXPERIMENT=simd GOARCH=arm64 go build -o app-arm64 ./cmd/app

# Compilación para WebAssembly para cálculos de alta velocidad en el navegador
GOEXPERIMENT=simd GOOS=js GOARCH=wasm go build -o app.wasm ./cmd/app
Activar GOEXPERIMENT=simd no vectoriza automáticamente los bucles for normales. El desarrollador tiene que estructurar el algoritmo usando tipos vectoriales y añadir siempre una ruta de respaldo escalar para procesadores antiguos que no dispongan del juego de instrucciones requerido.
Dónde brilla esta nueva API en la práctica
Contar con vectorización de bajo nivel en Go abre puertas muy potentes para software de infraestructura:
- Bases de datos y analítica: escaneo de máscaras de bits, filtrado columnar y agregación de millones de valores numéricos;
- Parsers de formatos: validación de caracteres UTF-8, búsqueda de caracteres de control en JSON y análisis de protocolos sin bucles byte a byte;
- Criptografía y hashing: aceleración por hardware de algoritmos de hash y cifrado simétrico;
- WebAssembly: llevar librerías de cálculo intensivo al navegador sin depender de C++ ni Emscripten.
Conclusión práctica
El experimento con simd/archsimd en Go 1.27 demuestra que el rendimiento extremo y la legibilidad pueden ir de la mano. Por fin podemos exprimir todos los teraflops del hardware de servidor manteniendo las herramientas habituales de Go, la seguridad de tipos y la comodidad de la compilación cruzada.