Si alguna vez has corrido modelos de lenguaje en local o mediante APIs abiertas, conoces de sobra el mayor suplicio de los asistentes de programación: la eterna espera hasta el primer token y esa impresión letárgica carácter a carácter. Cuando quieres levantar un microservicio rápido o probar una idea en la terminal, ir a 30 o 40 tokens por segundo convierte el trabajo en una prueba de paciencia. Durante mucho tiempo parecía que las velocidades de vértigo (cientos de tokens por segundo) eran coto privado de proveedores con hardware propietario carísimo como Groq o Cerebras.
Pero el laboratorio chino DeepSeek ha vuelto a descolocar a los gigantes del sector. El equipo liberó bajo licencia Apache 2.0 el código fuente de su motor de inferencia de producción DeepInfer, acompañado de un checkpoint optimizado del modelo DeepSeek V4.1 Flash (compilación 1017) afinado para generación autónoma de código.
Me he sumergido en el código del repositorio para desgranar los dos trucos arquitectónicos que permiten a DeepSeek superar a los motores clásicos, y ver cómo desplegar esta pila en tu propio hardware.
El callejón sin salida autorregresivo: por qué frenan los LLM estándar
Para entender qué rompe DeepInfer, recordemos cómo funciona un modelo de lenguaje clásico. La arquitectura Transformer es autorregresiva por naturaleza: para emitir el siguiente token, el modelo debe hacer pasar todo el contexto anterior por todas sus capas.
Un paso de generación equivale a un solo token. La tarjeta gráfica gasta una potencia descomunal moviendo trillones de pesos desde la VRAM lenta hacia los registros rápidos del chip solo para predecir una letra o una sílaba corta. El resultado es que el 80% del tiempo los aceleradores NVIDIA modernos están ociosos esperando datos por el bus de memoria. Es el famoso cuello de botella de memoria (Memory-Bound Bottleneck) contra el que se estrellan las optimizaciones ingenuas.
El segundo lastre de los sistemas agénticos es el contexto largo repetitivo. Cuando un agente de código da decenas de vueltas, reenvía en cada turno el prompt de sistema, las reglas del proyecto, la documentación y el historial de cambios. Un motor convencional recalcula una y otra vez la atención matemática sobre cientos de miles de tokens idénticos, desperdiciando ciclos de cómputo.
Los dos resortes de DeepInfer: DSpark especulativo y KV-cache inteligente
Los ingenieros de DeepSeek atacaron ambos problemas directamente en la arquitectura del servidor de inferencia.
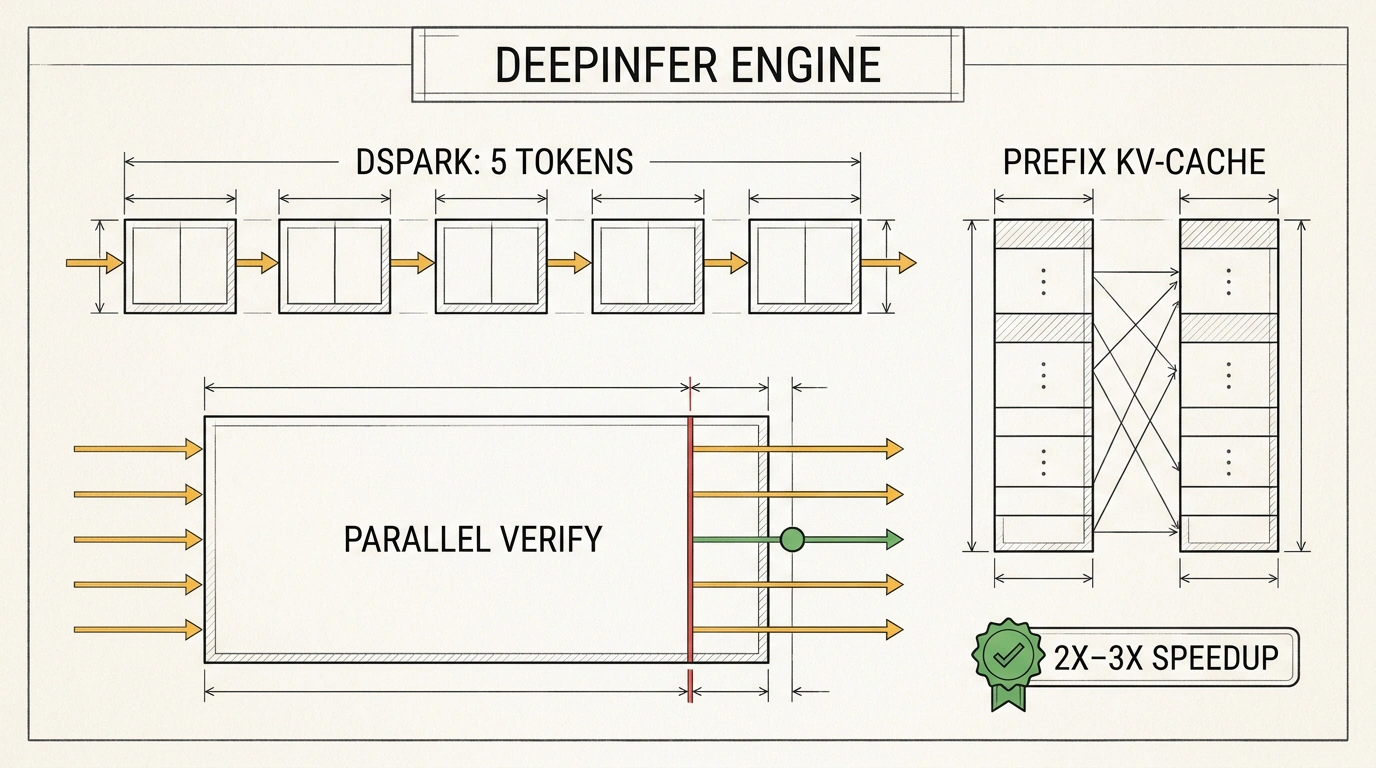
Diagrama arquitectónico del pipeline paralelo DSpark con paquete especulativo de tokens y KV-cache acelerado de DeepInfer.
El primer resorte es la decodificación especulativa DSpark (Speculative Decoding).
En lugar de mover el modelo pesado completo para cada token, el motor integra una cabeza de predicción ligera (Confidence Head). Trabaja casi al instante y propone de golpe un bloque de 3 a 5 tokens borrador (Draft Tokens). En código, por ejemplo, tras la palabra clave def casi seguro viene un espacio y el nombre de la función, y tras return suele ir una variable.
Luego, el modelo principal pesado realiza una sola pasada hacia adelante y verifica en paralelo todo el paquete propuesto. Si la cabeza ligera acertó 4 de 5 tokens, el sistema los acepta todos en un único ciclo. La latencia de generación cae entre 2 y 3 veces manteniendo el 100% de exactitud matemática del modelo grande.
El segundo resorte es el compartido de prefijos en KV-cache (KV-Cache Prefix Sharing). DeepInfer divide la memoria de claves y valores (KV-cache) en páginas y calcula el hash del prefijo de sistema inmutable. Cuando el agente manda la siguiente petición, el motor recupera al instante los cálculos ya hechos y procesa únicamente el delta del último mensaje. Esto recorta casi un 50% el cómputo en pipelines agénticos.
Como ya analizamos en el artículo sobre el motor abierto DeepInfer y el modelo Flash 1017, combinar ambas técnicas exprime al máximo tarjetas gráficas estándar de servidor.
Despliegue del servidor de producción DeepInfer
El servidor de DeepInfer está escrito en C++ puro con kernels CUDA optimizados y soporta tanto aceleradores NVIDIA (A100, H100, B200) como chips NPU Huawei Ascend.
Aquí tienes un comando real de arranque con el motor especulativo DSpark activo y paralelismo en 4 GPUs:
# Arranque del servidor de producción DeepInfer para DeepSeek-V4.1-Flash-1017
python3 -m deepinfer.entrypoints.openai.api_server \
  --model deepseek-ai/deepseek-v4.1-flash-1017 \
  --speculative-engine dspark \
  --speculative-draft-tokens 5 \
  --speculative-confidence-threshold 0.85 \
  --kv-cache-prefix-caching \
  --max-model-len 131072 \
  --tensor-parallel-size 4 \
  --port 8000
Fíjate en la bandera --speculative-confidence-threshold 0.85: fija el umbral de confianza de la cabeza borrador. Si la probabilidad de acierto baja del 85%, el sistema no arriesga y conmuta al instante al modo estándar, evitando retrocesos costosos.
Y así se consume el endpoint desplegado desde Python usando el cliente estándar de OpenAI:
"""
Llamada al servidor de inferencia DeepInfer con DSpark activado.
Obtención de código generado con latencia ultrabaja al primer token (TTFT).
"""
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="deepinfer-local-token"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {"role": "system", "content": "You are an expert autonomous software engineer."},
        {"role": "user", "content": "Escribe un microservicio autónomo en Go para monitorizar la KV-cache de un servidor de inferencia."}
    ],
    temperature=0.2,
    max_tokens=2048
)

print(response.choices[0].message.content)
Al generar código con tipado estricto (Go, Rust, TypeScript), puedes bajar sin miedo el umbral --speculative-confidence-threshold a 0.75: gracias a lo predecible de la sintaxis, la tasa de aceptación sube al 80–90% y maximiza el flujo de salida.
El checkpoint Flash 1017 en acción junto a OpenCode
Un motor veloz sirve de poco sin un modelo capaz de escribir código limpio sin fallos de sintaxis. El checkpoint actualizado DeepSeek V4.1 Flash (compilación 1017) está optimizado específicamente para entornos autónomos de desarrollo como OpenCode.
Con una ventana de contexto de hasta 1 millón de tokens, el modelo logra resultados llamativos ensamblando aplicaciones full-stack de una sola pasada. En pruebas controladas a partir de una única instrucción de texto genera de golpe:
- Un clon funcional de Tetris en JavaScript puro con animaciones fluidas y marcador;
- Escenas 3D interactivas en Three.js/WebGL sin errores de renderizado;
- Microservicios REST API completos en Go con documentación Swagger autogenerada.
Como mostró el estudio sobre el ecosistema OpenCode, la pila abierta de programación se ha pegado a los modelos insignia propietarios ofreciendo un ahorro de diez veces en el coste por token.
La realidad del hardware: lo que callan los benchmarks
Por atractivo que sea este lanzamiento abierto, hay que tener claros los requisitos físicos:
- Memoria de vídeo (VRAM). Para alojar V4.1 Flash con un contexto de 131k tokens y su KV-cache hacen falta al menos dos tarjetas tipo NVIDIA RTX 4090 (48 GB en total) en formato cuantizado, o una tarjeta de servidor A100/H100 de 80 GB para trabajar en FP16 completo.
- Caída de velocidad en algoritmos complejos. La decodificación especulativa brilla en sintaxis predecible (boilerplate, maquetación, CRUD típicos). Frente a fórmulas matemáticas densas o algoritmos poco convencionales, la cabeza borrador falla más y la ganancia de velocidad baja a un modesto 20–30%.
Aun así, el movimiento de DeepSeek marca un hito para todo el sector: los algoritmos punteros de inferencia ya no están encerrados tras nubes propietarias. Cualquier equipo puede montar su propia línea de programación ultrarrápida sobre hardware propio.
