Si alguna vez intentaste soltar un agente autónomo de programación sobre un repositorio grande, ya conoces el principal dolor de cabeza. Los modelos propietarios gigantes como Claude Opus o las versiones pesadas de GPT escriben código sólido, pero se toman su tiempo y queman el saldo de la API al ritmo de un deportivo a todo gas. Basta con lanzar un ciclo automático de búsqueda de bugs sobre un par de cientos de archivos para que el límite diario se evapore. Por otro lado, los modelos ligeros suelen pecar de errores de sintaxis, confunden tipos de datos y se quedan atrapados en bucles de alucinaciones.
El equipo chino de investigación DeepSeek hizo una jugada maestra que sacudió a la industria. El 17 de octubre de 2026 publicó el checkpoint DeepSeek-V4.1-Flash-1017 y, acto seguido, liberó el código fuente de su motor de inferencia en producción DeepInfer bajo licencia Apache 2.0. El resultado es un cóctel explosivo: un modelo ligero de arquitectura MoE (Mixture of Experts), optimizado para el paradigma «wish-driven programming», junto a un servidor de inferencia de bajo nivel que exprime hasta la última gota del hardware.
Por qué Flash 1017 supera a los gigantes en las pruebas SWE
Desmontemos la mecánica: ¿cómo es que un modelo compacto de pronto rinde mejor que sistemas cerrados mucho más pesados? En los benchmarks de corrección automática de bugs (SWE-bench y Mini-SWE), los modelos grandes suelen sufrir el «síndrome del alumno aplicado». Gastan decenas de miles de tokens en monólogos internos, filosofan sobre compromisos de arquitectura e intentan reescribir medio proyecto vecino en lugar de corregir con precisión dos líneas en la función vulnerable.
El checkpoint Flash 1017 se entrenó con una penalización estricta contra la cháchara innecesaria. Actúa como un ingeniero experimentado de guardia nocturna: localiza rápido el stack trace del fallo, revisa las condiciones límite y genera un diff mínimo y sintácticamente limpio. En las mediciones de control, este modelo levanta servicios web funcionales en minutos gastando centavos frente a sus rivales. Ya habíamos visto esta tendencia en DeepSeek V4.1 Flash 1017: compilación acelerada de apps y comparativa de costos frente a Claude Opus, pero ahora al checkpoint de software se sumó una pieza fundamental de infraestructura.
Arquitectura de DeepInfer: cómo funciona el motor por dentro
Hasta ahora, el estándar de facto para alojar redes abiertas en local seguía siendo vLLM o TensorRT-LLM. Son herramientas potentes, sí, pero generalistas y, por lo tanto, llenas de compromisos. DeepSeek eligió otro camino: publicó en el repositorio deepseek-ai/DeepInfer exactamente el mismo código con el que corre su propia API pública.
Macrofotografía de un acelerador especializado de inferencia DeepInfer con chips de memoria paralela y buses de cómputo
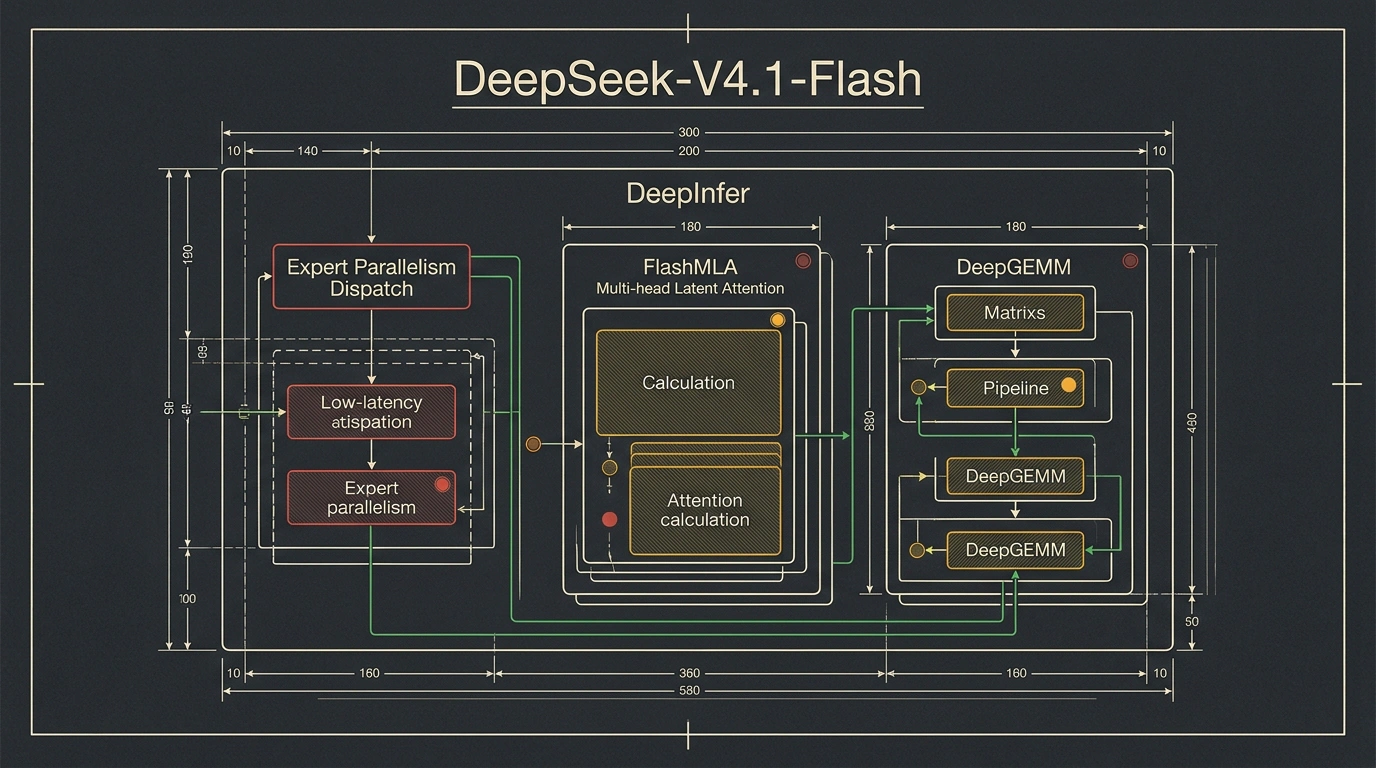
El mayor cuello de botella al procesar miles de peticiones en paralelo sobre modelos de mezcla de expertos (MoE) es la fragmentación de la memoria de video y la transferencia de datos entre GPUs. DeepInfer lo resuelve con un conjunto de librerías de bajo nivel:
- FlashMLA: kernels propios para calcular Multi-Head Latent Attention con un consumo drásticamente menor de memoria para matrices de claves y valores;
- DeepGEMM y DeepEP: multiplicaciones matriciales ultrarrápidas y un protocolo de paralelismo de expertos (Expert Parallelism) que garantiza latencias mínimas al intercambiar pesos entre chips por el bus NVLink;
- TileLang y TileKernels: lenguaje especializado para compilar bloques de cómputo pensado directamente para la arquitectura de los tensor cores.
El motor recibió optimización nativa para los aceleradores de servidor más recientes de NVIDIA de la generación Blackwell SM100 (B200 y racks GB200), además de los procesadores chinos Huawei Ascend 950. Para quienes desarrollan herramientas de terminal, esto abre posibilidades enormes —ya analizamos el entorno autónomo en Ecosistema OpenCode 2.0: agente abierto para terminal e integración de modelos rápidos—, y con DeepInfer la inferencia local alcanza escala industrial.
Así se lanza la generación desde la API de Python de DeepInfer indicando de forma explícita el paralelismo de expertos:
import deepinfer
from deepinfer import EngineConfig, MoEParallelConfig

# Configuración de inferencia distribuida para Flash 1017
config = EngineConfig(
    model_path="deepseek-ai/DeepSeek-V4.1-Flash-1017",
    tensor_parallel_size=4,
    moe_parallel_config=MoEParallelConfig(
        expert_parallel_size=8,
        load_balancer="EPLB",          # Balanceo dinámico de carga entre expertos
        enable_flash_mla=True
    ),
    kv_cache_dtype="fp8_e5m2",         # Cuantización de la caché KV en formato de 8 bits
    max_batch_size=128
)

engine = deepinfer.InferenceEngine(config)

# Generación con control gramatical estricto
output = engine.generate(
    "Напиши lock-free очередь на C++20 с использованием std::atomic",
    temperature=0.2,
    structured_grammar="json_schema"
)
print(output.text)
DeepInfer integra el mecanismo DSpark, que emplea planificación adaptativa de confianza para la generación especulativa de tokens. Al mismo tiempo, el motor garantiza una salida idéntica bit a bit con un seed fijo sobre hardware NVIDIA, algo crítico al ejecutar pruebas de regresión de código.
Trampas y límites de uso
Antes de lanzarte a desplegar DeepInfer en tu servidor de producción, conviene tener claro el estado actual del proyecto. Ante todo, es una herramienta pensada para procesamiento por lotes offline y colas de alta carga.
En la versión actual no viene incluido un demonio HTTP listo para usar compatible con la especificación OpenAI API (/v1/chat/completions). Para conectarlo a un servicio web tendrás que escribir tu propio wrapper en FastAPI/Rust o tirar de la librería deepseek-recipe. Además, desplegar MoE distribuido en varios nodos exige redes de alta velocidad RDMA/InfiniBand: en tarjetas Gigabit normales, el intercambio de datos entre expertos se convertirá en un cuello de botella.
Aun así, la liberación del código fuente de DeepInfer marca un hito en el otoño de 2026. El monopolio de los laboratorios cerrados sobre la infraestructura eficiente acaba de caer: ahora cualquier startup o ingeniero independiente puede montar un stack de programación de alto rendimiento en su propio hardware.
