A primera vista, ¿qué puede haber más sencillo en programación que averiguar la longitud de una cadena? En la tercera página de cualquier manual básico te dicen: llamas a str.length o len(s) y listo.
Pero hagamos un experimento muy simple. Tomemos la misma cadena aparentemente inofensiva —el emoji de la familia: "👨👩👧👦"— y preguntémosle a cuatro lenguajes de programación populares cuál es su longitud.
Estas son las respuestas que obtendremos:
- JavaScript:
11 - Python 3:
7 - Go:
25 - Rust:
25(bytes) o7(caracteres)
Un solo símbolo visible para el ojo humano en pantalla... y cuatro respuestas completamente distintas. Si en el código cliente en JavaScript pusiste una validación de usuario o comentario if (input.length > 10) return error;, tu usuario ni siquiera podrá enviar un único emoji porque JavaScript cree que ahí ya hay once caracteres.
Y si pasas esa cadena a un backend en Go y haces ingenuamente un slice de los cinco primeros elementos, el servicio entrará en pánico al instante o convertirá el texto en caracteres corruptos. Ya comentamos en su momento por qué un slice s0:3 en Go rompe la codificación UTF-8, pero hoy vamos a diseccionar toda la anatomía de Unicode hasta sus cimientos.
Cuatro niveles de realidad en Unicode
Para entender por qué los lenguajes dan respuestas distintas, hay que asumir una idea clave: el concepto de «carácter» en el estándar Unicode no existe en singular. Hay cuatro niveles fundamentales de representación del texto:
Infografía comparativa de formatos de contenedores Docker: el tarball clásico v2.2 con capas monolíticas frente a la estructura eStargz con fragmentos granulares y tabla de contenidos TOC.
- Bytes: octetos físicos sin procesar en memoria RAM o en disco. En la codificación UTF-8, un símbolo puede ocupar entre 1 y 4 bytes.
- Unidades de código (Code Units): la celda mínima indivisible de una codificación concreta. En UTF-16, una unidad de código son 16 bits (2 bytes). En UTF-8, son 8 bits (1 byte).
- Puntos de código (Code Points): el número de orden abstracto de un símbolo en la tabla Unicode (de
U+0000aU+10FFFF). Por ejemplo, la letra latinaAtiene el punto de códigoU+0041. - Clústeres de grafemas (Grapheme Clusters): lo que una persona percibe como una única letra gráfica o un icono indivisible en la pantalla del teléfono.
Nuestro emoji familiar "👨👩👧👦" en realidad está formado por cuatro figuras individuales de personas:
- Hombre (
U+1F468) - Mujer (
U+1F469) - Niña (
U+1F467) - Niño (
U+1F466)
Y entre ellas hay caracteres invisibles que las unen: Zero-Width Joiner (ZWJ, U+200D). En total, 4 figuras + 3 conectores = 7 puntos de código.
En UTF-8, cada figura ocupa 4 bytes y cada ZWJ ocupa 3 bytes: (4 * 4) + (3 * 3) = 25 bytes.
En UTF-16, cada figura no cabe en 16 bits y se codifica mediante un par sustituto (2 unidades de código de 16 bits = 8 unidades para las figuras), más 3 unidades de código normales para los ZWJ = 11 unidades de código.
Cómo funciona la memoria en cada lenguaje: veamos el código
Veamos cómo trabajan distintos entornos con esta cadena y cómo calcular correctamente la longitud «humana».
1. JavaScript: prisionero del legado UTF-16
JavaScript nació en 1995, cuando el estándar Unicode aún esperaba poder meter todos los símbolos del mundo en 16 bits. Por eso, históricamente las cadenas en JS son secuencias de unidades de código UTF-16 de 16 bits:
const family = "👨👩👧👦";
console.log(family.length); // 11 (unidades de código UTF-16)
// El operador spread ingenuo solo separa pares sustitutos, ¡no los ZWJ!
console.log([...family].length); // 7 (puntos de código)
// CORRECTO: segmentación en clústeres de grafemas con Intl.Segmenter
const segmenter = new Intl.Segmenter("ru", { granularity: "grapheme" });
const graphemes = [...segmenter.segment(family)];
console.log(graphemes.length); // 1 (¡el símbolo visible real!)
El moderno Intl.Segmenter es la única forma fiable de conocer el número real de símbolos visibles en el navegador y en Node.js.
2. Python 3: representación flexible con PEP 393
En Python 3, las cadenas están optimizadas por dentro: el intérprete usa 1, 2 o 4 bytes por carácter según el punto de código máximo presente en la cadena.
La función len() en Python siempre devuelve la cantidad de puntos de código:
import unicodedata
family = "👨👩👧👦"
print(len(family)) # 7 (puntos de código: 4 figuras + 3 ZWJ)
# Para contar grafemas reales hace falta la biblioteca regex con el patrón \X
import regex
graphemes = regex.findall(r'X', family)
print(len(graphemes)) # 1 (clúster de grafema real)
3. Go: UTF-8 estricto y el concepto de runa
En Go, sus creadores diseñaron el tipo string como un slice inmutable de bytes (immutable byte slice). La función len() devuelve bytes. Para trabajar con símbolos, Go introdujo el concepto de rune (alias de int32), que representa un punto de código:
package main
import (
"fmt"
"unicode/utf8"
)
func main() {
family := "👨👩👧👦"
// 1. Longitud en bytes UTF-8
fmt.Println(len(family)) // 25
// 2. Longitud en puntos de código (runas)
fmt.Println(utf8.RuneCountInString(family)) // 7
}
Para segmentar en grafemas en Go se utiliza el módulo golang.org/x/exp/shiny/materialdesign/colornames o el paquete especializado github.com/rivo/uniseg.
4. Rust: seguridad absoluta de tipos
Rust prohíbe por principio la indexación directa sobre cadenas s[0], porque es ambigua. El tipo &str garantiza UTF-8 válido, pero obliga al programador a elegir explícitamente qué quiere contar:
fn main() {
let family = "👨👩👧👦";
// 1. Número de bytes
println!("{}", family.len()); // 25
// 2. Número de puntos de código (chars)
println!("{}", family.chars().count()); // 7
// 3. Clústeres de grafemas mediante el crate unicode-segmentation
// use unicode_segmentation::UnicodeSegmentation;
// println!("{}", family.graphemes(true).count()); // 1
}
La trampa de las letras compuestas: por qué «ё» no siempre es «ё»
¿Crees que los problemas con los clústeres de grafemas solo afectan a los fans de los emojis? Para nada.
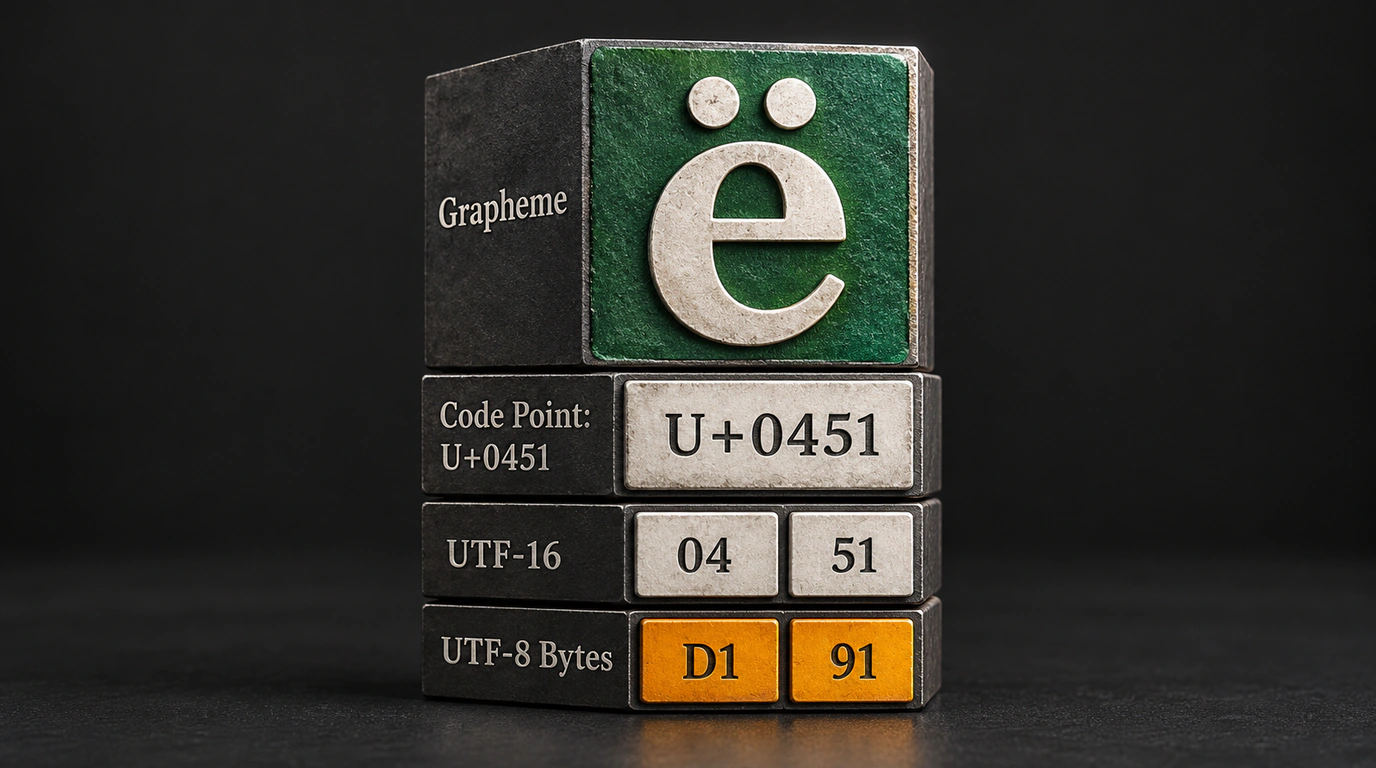
Tomemos la letra cirílica «ё». En Unicode se puede codificar de dos maneras:
- Precomposed (NFC): un único punto de código
U+0451(CYRILLIC SMALL LETTER IO). Longitud en JS:1. - Decomposed (NFD): la letra base
«е»(U+0435) más la diéresis combinable superior (U+0308,COMBINING DIAERESIS). Longitud en JS:2.
En la pantalla del monitor ambas letras se ven exactamente igual: ё y ё. Pero para una base de datos o una búsqueda de cadenas son entidades completamente distintas. Si un usuario introdujo su nombre de usuario en forma NFC y otro en NFD, la comparación user1 === user2 devolverá false (y lo mismo ocurre con las tildes en español, como á o ñ).
Por eso existe una regla de oro en el backend al procesar entradas de usuario: normalizar siempre las cadenas a la forma canónica NFC:
str.normalize("NFC") en JavaScript o unicodedata.normalize("NFC", s) en Python antes de guardarlas en la base de datos.
Entender cómo funcionan los puntos de código y los grafemas evita los bugs de validación más traicioneros y garantiza que la interfaz no se rompa al encontrarse con texto real.
