Si alguna vez has construido un almacén de datos corporativo o un lago de cientos de terabytes, seguro que recuerdas ese sudor frío: son las tres de la madrugada, un script ETL complejo ha fallado al actualizar el quinto data mart de diez, y a las ocho de la mañana la dirección abre los paneles. La mitad de los datos se ha actualizado, la otra mitad sigue siendo de ayer, el balance financiero no cuadra y toca revertir a mano archivos Parquet en S3 presa del pánico.
En las bases de datos relacionales clásicas nos salva la transacción: BEGIN TRANSACTION ... COMMIT. Si ocurre un fallo, la base simplemente revierte el estado y los lectores ni siquiera llegan a ver basura intermedia. Pero cuando tus datos viven distribuidos en un almacenamiento de objetos en la nube en formato Apache Parquet, las transacciones tradicionales fueron durante años un sueño inalcanzable.
La llegada de formatos de tabla como Apache Iceberg y Delta Lake supuso un paso gigante: aparecieron los snapshots y el aislamiento a nivel de una sola tabla. Pero ¿qué pasa cuando un pipeline actualiza a la vez diez tablas interconectadas? ¿Cómo garantizar que los analistas no vean un estado «roto» a medias?
Ahí es donde entra en escena el proyecto de código abierto Apache Nessie, que implementa el concepto de «Git-for-Data» para la arquitectura Lakehouse. Veamos cómo funciona por dentro y por qué cambia las reglas del juego en ingeniería de datos.
El problema de las lecturas sucias en los lagos de datos
Para entender el valor de Nessie, piensa en cómo se suele resolver el aislamiento de los procesos ETL:
- Doble búfer (Staging Schemas): los datos se escriben en un esquema temporal y luego, mediante scripts rebuscados, se renombran o intercambian con
ALTER TABLE ... SWAP WITH. Es engorroso, rompe los permisos de acceso y muchas veces no lo soportan los motores distribuidos. - Banderas de disponibilidad: se escribe en la base un indicador
is_ready = falsey todas las consultas analíticas quedan obligadas a filtrar por él. Basta con que un junior se olvide delWHERE is_readypara que aparezca basura en las gráficas. - Escritura directa en vivo: la estrategia más peligrosa, donde los datos intermedios quedan visibles para todos los lectores en pleno proceso de inserción.
Cuando Skillbox llevó a cabo la migración de su almacén de datos corporativo a Trino, Iceberg y S3, se topó en la práctica con la necesidad de garantizar una consistencia sólida entre cientos de flujos analíticos. Nessie resuelve precisamente ese dolor actuando como catálogo central de metadatos con soporte de ramas y commits.
Cómo funciona Nessie por dentro: ramificación Zero-Copy
La gran magia de Apache Nessie reside en que no copia en absoluto los archivos físicos de datos.
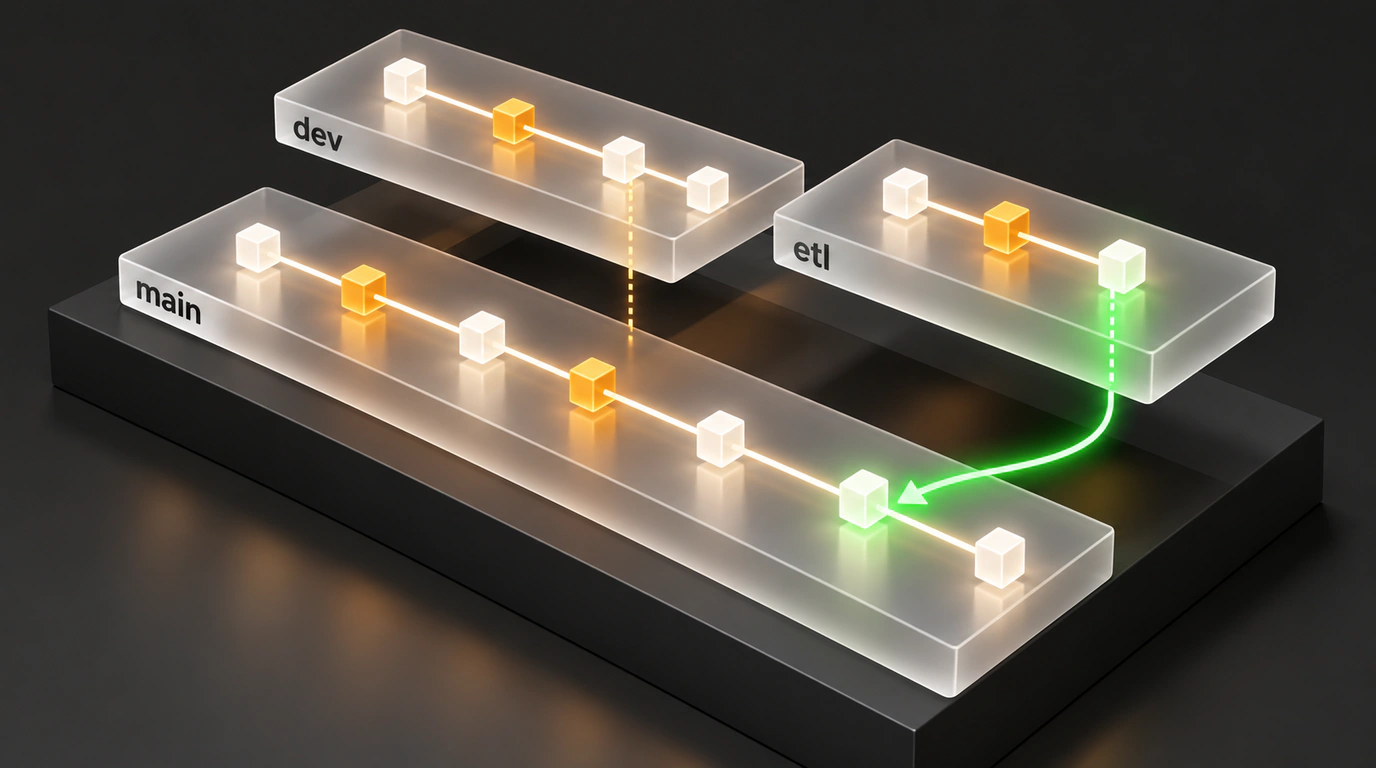
Esquema de ramificación Zero-Copy en Apache Nessie: una rama aislada con nuevos commits apunta a los archivos de datos compartidos en el almacenamiento de objetos sin duplicarlos.
Cuando creas una rama en Git, el sistema no duplica todo tu disco duro. Git simplemente crea un puntero ligero a un commit concreto dentro del grafo de historial. Nessie hace exactamente lo mismo, pero en lugar de código fuente, gestiona los metadatos de las tablas Iceberg:
- Catálogo como árbol de contenido: Nessie guarda un árbol de referencias a los manifiestos de tablas (
metadata.json). Cada tabla se identifica mediante una clave de contenido (ContentKey). - Zero-Copy Branch: la operación
CREATE BRANCH etl_batch FROM mainse ejecuta en unos pocos milisegundos. En la base del catálogo se crea una referencia con nombre que apunta al snapshot raíz actual. Los terabytes y petabytes de archivos Parquet en el bucket de S3 no se mueven de sitio. - Commits aislados: mientras tu proceso ETL escribe nuevos archivos Parquet y genera metadatos de Iceberg, todos los cambios quedan ligados exclusivamente a la rama
etl_batch. Las consultas sobre la ramamainno ven físicamente esos commits.
Dentro del propio Nessie, el historial de commits se organiza en un grafo acíclico dirigido (DAG). Como backend persistente para almacenar los metadatos del catálogo, Nessie soporta PostgreSQL, DynamoDB, RocksDB o estructuras distribuidas en memoria.
Práctica: ramificación y fusión atómica en SQL
Veamos cómo es el trabajo real con Nessie desde Spark SQL o Trino. Gracias al soporte de la sintaxis de referencias de Nessie, la gestión de versiones de datos se resuelve en apenas un puñado de comandos estándar:
-- 1. Creamos una rama aislada para el cálculo nocturno antes de arrancar el ETL
CREATE BRANCH etl_nightly_sales IN nessie FROM main;

-- 2. Cambiamos la sesión para trabajar en la rama creada
USE REFERENCE etl_nightly_sales IN nessie;

-- 3. Ejecutamos los cálculos pesados y actualizamos los data marts
-- Toda la escritura va al bucket S3, pero en el catálogo los cambios se ven SOLO en nuestra rama
INSERT INTO analytics.orders_summary
SELECT
    customer_id,
    date_trunc('day', order_date) AS order_day,
    sum(amount) AS total_spent
FROM raw_stage.orders
WHERE order_date >= '2026-10-21'
GROUP BY 1, 2;

-- 4. Actualizamos las métricas de clientes en la tabla contigua
UPDATE analytics.customer_profiles
SET loyalty_tier = 'Gold'
WHERE total_spent > 100000;
Fíjate: en ese mismo instante, los paneles de BI siguen conectados a la rama main. Ningún analista ve la tabla orders_summary a medio llenar ni recibe errores de bloqueo de tablas.
Cuando el ETL termina sus cálculos con éxito y supera las pruebas de calidad de datos (por ejemplo, con Great Expectations), llega el momento de publicar:
-- 5. Volvemos a la rama principal y ejecutamos la fusión
USE REFERENCE main IN nessie;

-- ¡Merge atómico de varias tablas a la vez hacia producción!
MERGE BRANCH etl_nightly_sales INTO main IN nessie;
La operación MERGE BRANCH se ejecuta de forma atómica. El puntero de la rama main avanza al commit de fusión. Para todos los lectores, las nuevas versiones de ambas tablas aparecen al unísono en el mismo milisegundo.
Conflictos de escritura paralela y estrategias de fusión
¿Y qué ocurre si, mientras nuestro largo pipeline ETL calculaba los data marts, otro proceso llegó a escribir datos en main?
Nessie utiliza control de concurrencia optimista (Optimistic Concurrency Control, OCC). Al fusionar, soporta dos estrategias básicas:
- Fast-Forward Merge: si la rama
mainno ha avanzado desde que se creó nuestra rama de trabajo, el puntero demainsimplemente se mueve a la punta de nuestra rama. No se crean commits adicionales. - Three-Way Merge: si en
mainhan aparecido nuevos commits, Nessie compara el ancestro común base, la rama destino y la rama origen. Si los commits afectaron a tablas distintas (por ejemplo, el ETL nocturno actualizóorders_summaryy el streaming actualizóclickstream), la fusión se completa automáticamente sin conflictos.
En cambio, si ambos procesos intentaron modificar la misma tabla, Nessie bloquea la operación y lanza un error de conflicto, protegiendo el lago frente a inconsistencias.
Escollos y recolección de basura
Suena ideal, pero en producción cualquier solución arquitectónica elegante tiene un coste. Y en el caso de Nessie, ese precio es la gestión del ciclo de vida de los archivos en el almacenamiento.
Como crear ramas resulta tan barato, los ingenieros suelen abrir decenas de ramas para experimentos y luego se olvidan de borrarlas. Cada rama mantiene referencias a ciertos snapshots de Iceberg. Como resultado, el recolector de basura de Iceberg (expire_snapshots) no puede eliminar de S3 los archivos de datos antiguos porque una rama olvidada de hace dos meses sigue apuntando a ellos.
Para evitar que se disparen las facturas de almacenamiento en la nube, conviene implantar desde el principio dos reglas en el equipo:
- Configurar un TTL para las ramas temporales y eliminar automáticamente las ramas de tareas ETL finalizadas.
- Ejecutar periódicamente Nessie GC (Garbage Collection), que localiza los archivos inalcanzables desde cualquier rama o etiqueta viva y los borra de forma segura en S3.
En definitiva, Apache Nessie transforma un lago de datos de un campo salvaje lleno de archivos Parquet en una plataforma rigurosa, predecible y transaccional, donde revertir un error es un simple RESET REFERENCE y no una noche en vela de recuperación manual.