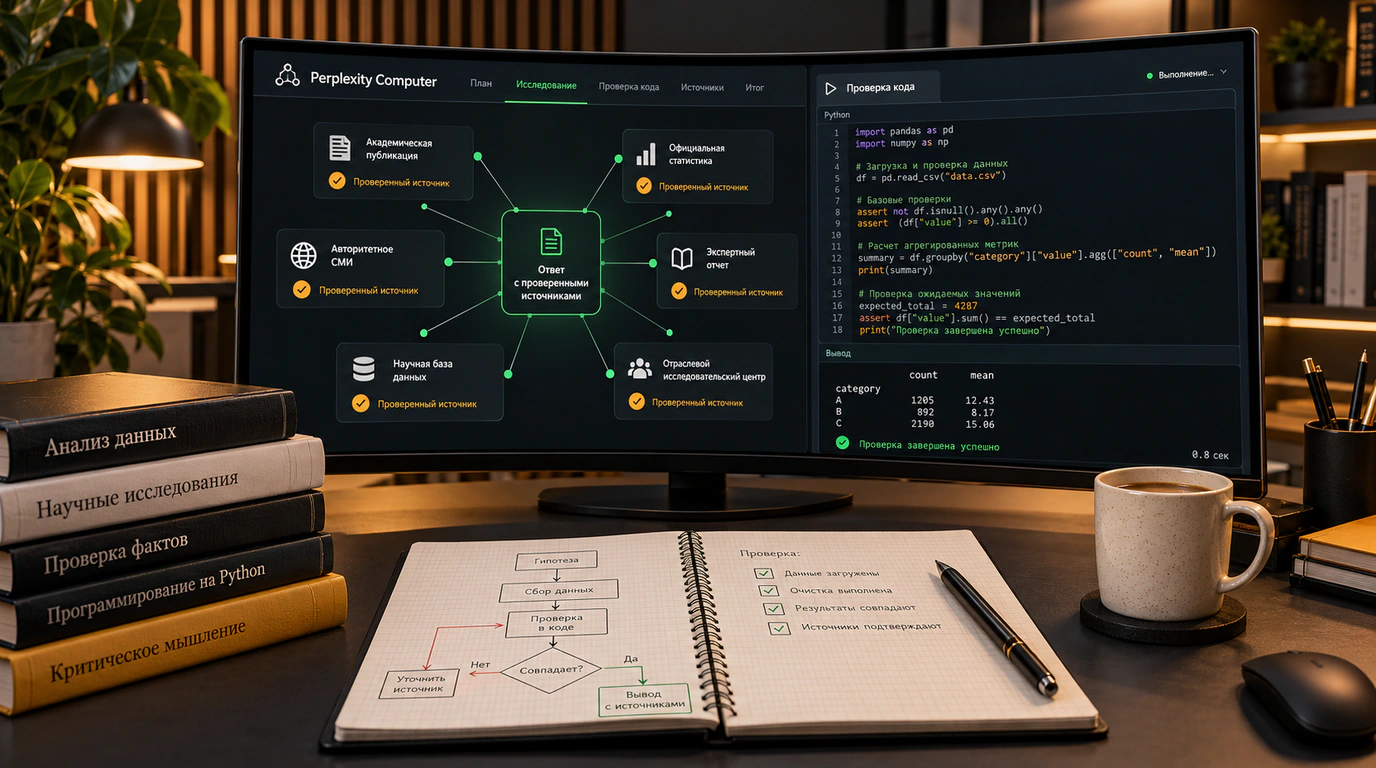
Si usas buscadores generativos a menudo, seguro que ya chocaste con su techo oculto. Cuando necesitas rápido la receta de una tarta o la fecha de un hecho histórico, la búsqueda conversacional va como la seda. Pero en cuanto pides un informe completo de mercado —por ejemplo, comparar los estados financieros de cinco startups, cruzar referencias de patentes y sacar la evolución exacta de precios—, el sistema empieza a patinar por la superficie y repite los mismos snippets promocionales de los diez primeros resultados.
El laboratorio de búsqueda Perplexity decidió derribar esa barrera presentando Perplexity Computer. Es un cambio de fondo: pasar de preguntas sueltas a sesiones agénticas autónomas de larga duración.
Arquitectura de investigación: de los snippets al árbol DOM completo
La gran novedad de Perplexity Computer está en lo hondo que entra en la web. Los chatbots corrientes solo ven metaetiquetas y resúmenes cortos que devuelve el índice del buscador. Perplexity Computer despliega un enjambre de subagentes en paralelo que hacen clic en los enlaces de verdad, cargan las páginas enteras, sortean elementos básicos de navegación y extraen los datos directo de la estructura DOM y las tablas incrustadas.
La arquitectura se apoya en dos piezas clave:
- Entorno aislado seguro SPACE (Secure Platform for Autonomous Code Execution): cuando el agente necesita procesar un conjunto de datos en bruto o parsear una maquetación rara, genera al vuelo un script auxiliar en Python y lo ejecuta dentro de un contenedor aislado. Eso protege frente a ataques de prompt injection si un sitio malicioso intenta secuestrar al agente;
- Consejo de modelos (Model Council): para contrastar cifras críticas y datos polémicos, el sistema convoca a varios modelos heterogéneos (Claude, GPT y pesos abiertos). Si sus conclusiones discrepan, el agente lanza otra ronda de búsqueda hasta dar con la fuente primaria.
Ya hablamos de las herramientas de escritorio del ecosistema en Análisis de Perplexity Computer para Windows: el agente de IA de escritorio de nueva generación, y detallamos los flujos en la nube en Automatizaciones en Perplexity Computer: de búsquedas puntuales a tareas periódicas en segundo plano.
No reduzcas el prompt a una sola línea. Indícale al agente criterios concretos de validación: qué fuentes considerar fiables (por ejemplo, solo comunicados oficiales y reguladores financieros), qué formato de salida necesitas (tabla comparativa en Markdown) y a partir de qué nivel de discrepancia marcar un dato como dudoso.
Perplexity Computer navega de maravilla por la web abierta, pero se frena ante barreras interactivas complejas: captchas interactivos, muros de pago cerrados y autenticación en dos factores. Para esas fuentes sigue haciendo falta descargar los archivos manualmente antes.
Perplexity Computer convierte la rutina investigadora de un analista en un solo clic, devolviéndole a internet su mayor valor: datos verificables y precisos.
