Imagina una escena típica para cualquier experto moderno: tuviste una gran llamada de hora y media, grabaste un episodio denso de podcast o dejaste en la grabadora una docena de ideas potentes sobre un proyecto reciente. El material es oro puro, los datos están vivos y los insights piden a gritos salir al mundo. Pero luego empieza la rutina agotadora que te quita las ganas de todo: hay que transcribir la grabación, limpiar la paja, extraer lo esencial, redactar un artículo analítico, maquetar una serie de posts concisos para redes sociales y armar un boletín para la lista de correo.
En ese momento la mayoría de las personas comete exactamente el mismo error clásico: abre la ventana de chat con una red neuronal, pega todo el bloque de texto en bruto y escribe una petición ingenua: «Hazme con esto cinco posts de distinto formato con mi estilo». ¿Y qué devuelve el modelo? Exacto: toneladas de plástico sin vida y vaciado de alma. El texto rebosa de clichés como «En el mundo actual que cambia rápidamente», «Sumerjámonos en los detalles» y «Esta herramienta cambiará las reglas del juego». La voz del autor se disuelve sin dejar rastro.
Kieran Flanagan, ex vicepresidente sénior de HubSpot y coanfitrión del podcast Marketing Against the Grain, dio con un enfoque de ingeniería radicalmente distinto. En lugar de torturar un único chat, construyó una auténtica «fábrica de contenido de una sola persona», uniendo subagentes aislados en Claude dentro de una cadena de producción estricta. Desmonté este sistema hasta el último tornillo y estoy listo para mostrarte cómo funciona.
La crisis de la producción manual y la trampa del chat único
Quitémonos de entrada las gafas de color de rosa: escalar contenido de calidad a mano y en solitario es imposible. Inevitablemente chocas con el límite biológico de tu propia atención. Crear un análisis profundo exige alternar entre modos mentales completamente distintos: el analista busca hechos, el arquitecto diseña la estructura, el escritor elige metáforas precisas y el editor recorta sin piedad todo lo que sobra.
Cuando intentas encargar todos esos papeles a un solo modelo de lenguaje dentro de una única sesión, te topas inevitablemente con el fenómeno que los investigadores llaman dilución de la atención (attention dilution) o degradación contextual. A medida que la sesión crece hasta decenas de miles de tokens, el modelo empieza a «desvariar»:
- Olvida las restricciones estilísticas estrictas fijadas al principio del trabajo;
- Empieza a promediar el tono hacia la plantilla corporativa más probable de su conjunto de entrenamiento;
- Confunde hechos de distintas partes de la transcripción y comienza a alucinar discretamente, inventando detalles inexistentes para que la frase suene fluida.
Intentar resolver este problema complicando sin fin un único megaprompt se parece a contratar a un solo becario y obligarlo a llevar la contabilidad, escribir código backend, diseñar gráficos y atender a clientes en primera línea de soporte al mismo tiempo. El resultado siempre es predeciblemente triste.
El principio de división del trabajo en arquitecturas LLM
El descubrimiento fundamental de la ingeniería agéntica moderna suena sencillo: un modelo de lenguaje muestra su máxima calidad de razonamiento única y exclusivamente cuando su atención está enfocada en una tarea atómica dentro de un contexto compacto.
En lugar de un chat monolítico, Flanagan dividió la producción de medios en roles altamente especializados:
- Agente de procesamiento primario (Raw Ingestion Agent): su única tarea es recibir la transcripción de audio en bruto, limpiar titubeos, muletillas y marcas de tiempo, y generar un borrador coherente de notas.
- Extractor de núcleos de sentido (Core Idea Extractor): este agente analiza el texto limpio y descarta sin piedad las obviedades. Su misión es extraer 3–5 tesis contraintuitivas y paradójicas alrededor de las cuales se construye toda la dramaturgia.
- Arquitecto de publicación (Outliner Agent): toma las tesis seleccionadas y diseña el esqueleto lógico del material, colocando énfasis, contraejemplos y transiciones.
- Adaptadores especializados de formato (Format Adapters): agentes independientes, cada uno afinado estrictamente para un único canal de distribución (un artículo largo, un hilo en X, un post denso en Telegram, un correo para la newsletter).
- Editor-verificador (Quality Gate & Fact-Checker): el agente final, que compara el material terminado con el documento original y señala cualquier discrepancia o suposición inventada.
Cada uno de estos agentes se ejecuta en una ventana de contexto aislada, tiene su propia instrucción de sistema concisa y no se distrae con ruido ajeno.
Anatomía del pipeline de transferencia de datos mediante artefactos
¿Cómo organizar la comunicación entre estos agentes sin convertir el sistema en un ovillo inmanejable? La respuesta está en el concepto de pipeline impulsado por artefactos (Artifact-Driven Pipeline).
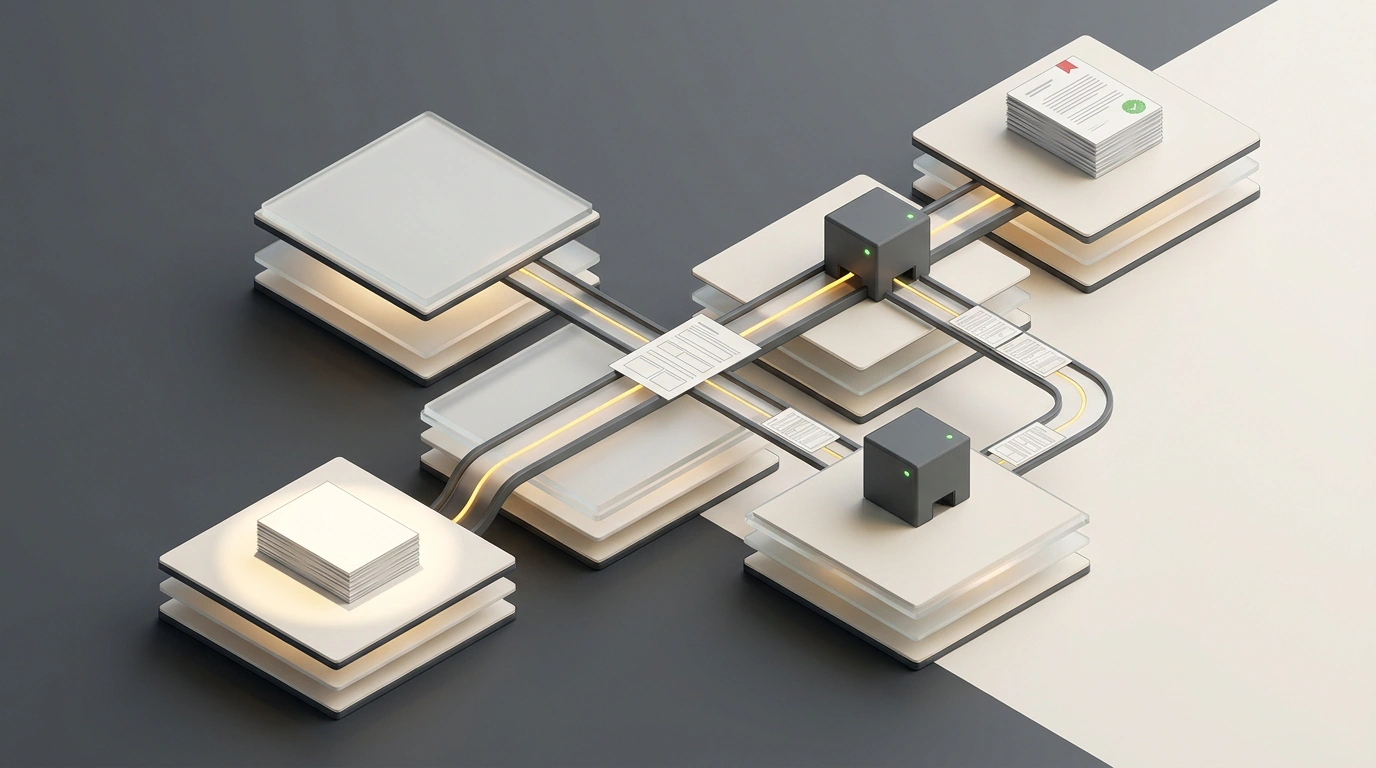
Bodegón de un escritorio de ingeniero organizado: hojas estructuradas de artefactos sobre una tableta y una palanca mecánica de control de la línea de producción
En los sistemas multiagente ingenuos, los bots se lanzan mensajes en un chat compartido, saturando rápidamente la ventana de contexto y quemando tokens. En la arquitectura de Flanagan, los agentes se comunican exclusivamente a través de archivos en el disco duro. La salida de un subagente se materializa en forma de documento Markdown estructurado y se guarda en la carpeta del proyecto, convirtiéndose en el archivo de entrada para la siguiente etapa.
Mira por qué esto es brillante desde el punto de vista de la ingeniería:
- El agente copywriter en el cuarto paso no recibe 60,000 tokens de charla desestructurada en bruto de la conversación original, sino un resumen claro de dos páginas con tesis y citas verificadas. Esto ahorra hasta un 90% de tokens de entrada y reduce el riesgo de alucinaciones a cero estadístico.
- Si no te gustó el borrador final del post, no necesitas reiniciar toda la cadena desde el principio. Puedes ajustar el archivo intermedio con las tesis en un editor de texto común y pulsar el botón de regenerar únicamente para el formato deseado.
- Todo el historial de producción se conserva como archivos locales en un repositorio Git, lo que permite rastrear versiones y perfeccionar los prompts de forma continua. Precisamente este enfoque de ingeniería lo detalla la guía de distribución de roles en Claude Code: el aislamiento del contexto protege la arquitectura contra la degeneración de estilos y convierte experimentos aislados en una línea de producción digital estable.
Metodología Style Cards: reproducir la voz del autor
La pregunta más difícil en cualquier automatización de contenido es: ¿cómo enseñar a una red neuronal a sonar como una persona real y no como un robot incorpóreo?
Tradicionalmente la gente intenta describir su estilo con adjetivos: «escribe de forma experta, pero accesible, con humor, cercano, como para emprendedores». Pero para un LLM esas palabras no significan absolutamente nada: el modelo simplemente saca patrones promediados de su corpus de entrenamiento.
Flanagan propuso el concepto de tarjetas de estilo (Style Cards), basado en el principio literario clásico «Show, Don't Tell» («Muestra, no cuentes»). En la instrucción del sistema del agente generador no se incrustan epítetos abstractos, sino reglas estructurales concretas y 2–3 fragmentos modelo de textos reales exitosos del autor:
- Prohibición estricta de palabras vacías: lista de clichés que el modelo no tiene derecho a usar bajo ninguna circunstancia («game-changer», «revolucionario», «sumerjámonos», «indudablemente»);
- Proporciones rítmicas: longitud máxima de párrafo (no más de 2–3 oraciones), alternancia entre frases cortas contundentes y explicaciones desarrolladas;
- Tipo de arranque: prohibición estricta de saludos e introducciones lejanas. El primer párrafo debe empezar con una paradoja, una cifra inesperada o una afirmación conflictiva;
- Regla de cierre abierto: terminar el texto no con una invitación banal a suscribirse al canal, sino con una pregunta abierta precisa sobre el fondo de la mecánica analizada.
Cuando el modelo ve frente a sus ojos un referente real y restricciones formales claras, capta al instante el ritmo adecuado y lo traslada al nuevo material.
Puntos de control de calidad y protección contra alucinaciones
Uno de los mayores temores al automatizar es quedar en ridículo por un error tonto o un dato inventado que se cuele en la publicación. ¿Cómo garantizar la seguridad cuando el volumen de producción se multiplica?
En la arquitectura de la fábrica de contenido rige una ley inquebrantable: el humano sigue siendo siempre la fuente de la chispa (Spark) y el controlador final de calidad (Human-in-the-Loop). La IA nunca inventa un tema «de la nada». El combustible primario del pipeline es siempre experiencia humana real: una entrevista grabada, notas de voz tras una reunión compleja, fragmentos de código vivo o un caso real de cliente.
Y a la salida del pipeline se conecta el subagente verificador. Trabaja por verificación cruzada: toma el borrador generado y contrasta cada afirmación con el documento de trabajo original. Si el copywriter añadió una cifra que no estaba en la fuente original o atribuyó a un interlocutor una idea ajena, el verificador marca ese fragmento con una advertencia en el informe final. Al humano solo le queda dedicar tres minutos a revisar rápidamente las marcas antes de enviar el material a publicación.
Economía y productividad del pipeline
Calculemos el retorno económico real de implantar un sistema así. Antes de la automatización, preparar el paquete completo de materiales a partir de un episodio experto de una hora (un artículo largo para el blog, 3–4 posts para redes sociales, correo para la newsletter y puntos clave para una presentación) le llevaba a Flanagan entre 12 y 16 horas de trabajo neto, extendiéndose durante varios días laborables.
Tras montar el pipeline de subagentes, todo el ciclo completo de generación de borradores tarda entre 4 y 7 minutos. Se dedican además unos 30–40 minutos a la edición final, colocación de enlaces y pulido humano. En total, un ahorro de tiempo superior a diez veces.
¿Y en dinero? Pasar una hora de audio de punta a punta por la cadena de subagentes con los modelos Claude 3.5 Sonnet y Opus 5.5 vía API cuesta en promedio entre 1.5 y 3 dólares estadounidenses. Incluso si publicas materiales cada día hábil, el presupuesto mensual en tokens apenas superará los 50–70 dólares. Compáralo con el sueldo de un copywriter en plantilla o la comisión de una agencia, medida en cientos de miles de rublos, y la diferencia en economía unitaria se vuelve cristalina.
Integración con el entorno local mediante Model Context Protocol
Para que los subagentes no vivan en un vacío aislado, Flanagan los conecta con el entorno de trabajo a través del estándar abierto Model Context Protocol (MCP). Esto resuelve el eterno problema de mover datos entre servicios desconectados.
En lugar de copiar texto manualmente entre Obsidian, la terminal y el navegador, el orquestador se conecta a servidores MCP locales:
- Servidor de sistema de archivos (Filesystem MCP): otorga a los agentes acceso controlado a los directorios
inputs/youtputs/, garantizando que el script no pueda leer por accidente archivos fuera del proyecto; - Servidor de base de conocimiento (Obsidian/Notion MCP): permite al agente investigador extraer automáticamente notas relacionadas, publicaciones anteriores y el glosario de términos del autor;
- Servidor de búsqueda web (Brave Search / Perplexity MCP): el subagente verificador lo utiliza para comprobar rápidamente hechos, lanzamientos y enlaces a fuentes primarias mencionados en el audio.
Esta combinación convierte un conjunto de prompts de texto en un auténtico sistema operativo para la producción de contenido, donde cada herramienta cumple un papel estrictamente asignado bajo supervisión humana.
Despliegue paso a paso de la fábrica de subagentes
Pasemos de la teoría a la práctica. Puedes desplegar un prototipo básico de este sistema en tu terminal local en literalmente media hora.
Primero inicializamos la estructura de archivos del proyecto, donde cada paso del pipeline quedará aislado en su propio directorio:
mkdir -p content-factory/inputs content-factory/artifacts content-factory/skills content-factory/prompts content-factory/outputs
cd content-factory
git init
Después creamos una especificación legible por máquina del público objetivo en el archivo skills/audience_profile.md. Este archivo define el filtro de percepción para todos los agentes redactores:
# Target Audience Profile: Tech Founders & Senior Engineers
- Role: CTO, Tech Lead, Senior Software Engineer, Solo Founder.
- Frustrations: Superficial AI hype, generic LinkedIn platitudes, zero-code illusions.
- Tone: Direct, intellectually honest, pragmatic, code-literate.
- Stop words: "Unleash", "Game-changer", "Revolutionary", "Dive in", "Buckle up".
Ahora creamos el script ejecutable del orquestador en Python (orchestrator.py). Lanza los agentes de forma secuencial mediante el SDK oficial de Anthropic, pasando los resultados a través de archivos locales:
import os
from anthropic import Anthropic

client = Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))

def run_agent(system_prompt_path, user_input, model="claude-3-5-sonnet-latest"):
    with open(system_prompt_path, "r", encoding="utf-8") as f:
        system_prompt = f.read()

    response = client.messages.create(
        model=model,
        max_tokens=4096,
        system=system_prompt,
        messages=[{"role": "user", "content": user_input}]
    )
    return response.content[0].text

def execute_pipeline(source_file_path):
    with open(source_file_path, "r", encoding="utf-8") as f:
        source_text = f.read()

    # Paso 1: Extracción de núcleos de sentido
    print("Extracting core ideas...")
    core_ideas = run_agent("prompts/extractor.md", source_text)
    with open("artifacts/01_core_ideas.md", "w", encoding="utf-8") as f:
        f.write(core_ideas)

    # Paso 2: Generación del post según la Style Card
    print("Drafting analytical post...")
    post_draft = run_agent("prompts/writer_post.md", core_ideas)
    with open("outputs/post_draft.md", "w", encoding="utf-8") as f:
        f.write(post_draft)

    print("Pipeline completed. Check outputs/post_draft.md for human review.")

if __name__ == "__main__":
    execute_pipeline("inputs/raw_interview.txt")
Solo queda colocar el texto fuente en inputs/raw_interview.txt, ejecutar el script y obtener un borrador limpio y estructurado que conserva la idea del autor sin una gota de basura maquinal.